
2026-09-14 上午,同一件事有兩個都為真的說法:
TypeError e.toFixed。worker 沒騙我,頁面也真的壞了。Day 5 結尾留下的「誤報」缺口比我以為的難處理——它不是一筆假話,是兩種「完成」的定義撞在一起。
那輪我在修 dashboard 的成本分層顯示。「重跑後通過」意思是第一次沒過、重跑後過了,按回報這個任務收得掉;點開頁面才發現沒有。以下時間與數字,引用我在 2026-09-14 11:49 留下的『成本頁崩潰與修復』筆記(這份筆記未公開,讀者無法直接調閱)。
這次的直接原因不在改出來的那段程式碼:dashboard 的 Python 服務行程是 11:13:38 由啟動腳本拉起來的,啟動時間早於成本頁修改任務的改檔時間。行程還抓著舊模組,回傳的 JSON 至少少了 main_usd / manager_usd / worker_usd 三個欄位,前端拿到 undefined 直接呼叫 toFixed,當場炸掉。
那個「早於」是整件事的關鍵。行程 11:13:38 起來,改檔在那之後;Python 行程啟動時把模組讀進記憶體,之後就不再回頭看磁碟——檔案改了,跑著的那份沒改。這條因果鏈裡沒有任何一環是 worker 從自己的工作範圍內看得到的:它的工作範圍是那個檔案,事實卻發生在一個它沒被告知存在的行程裡。
worker 改的那段程式碼可能完全正確。它只是沒辦法知道、也沒被要求知道:旁邊有個行程還活著,不會自己重讀新檔案。
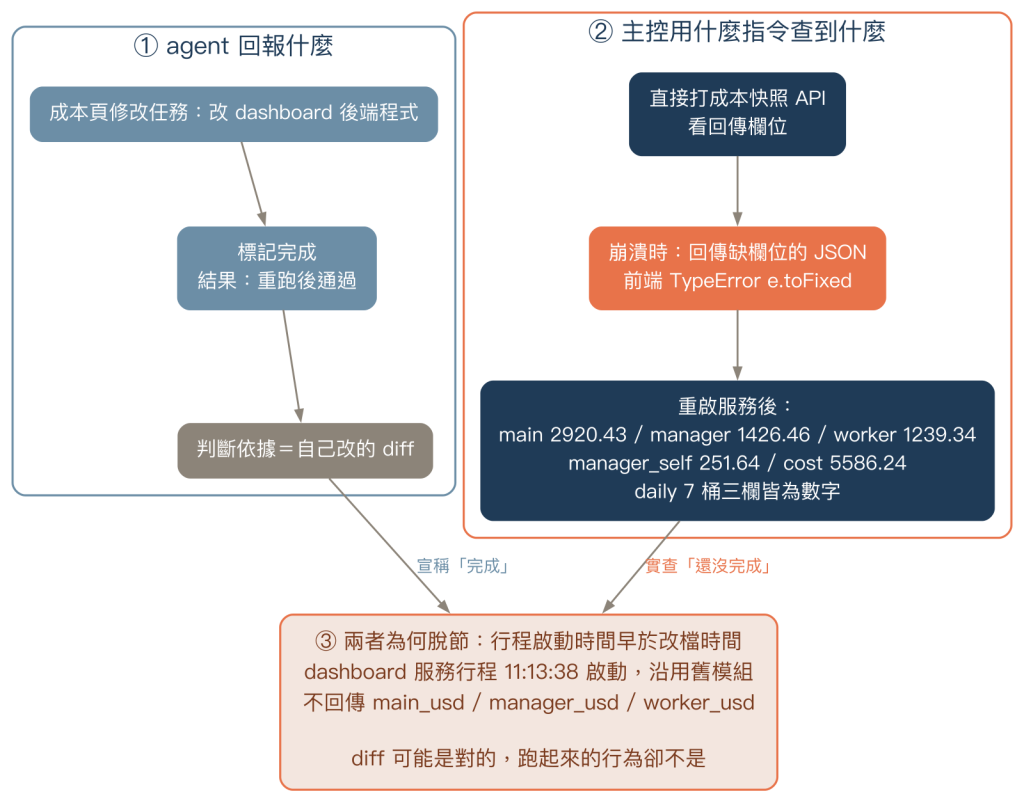
同一件事的兩份依據:左邊是 agent 看到的 diff,右邊是我下指令查到的服務回應,下方是兩者脫節的原因。
我不是靠重讀回報發現的,重讀一百次也讀不出來——它的敘述自洽。我是靠一條指令:直接打 dashboard 提供成本快照的那支 API,看它回傳什麼。
崩潰當下它回的是缺欄位的 JSON。行程重啟後再打一次,summary 才出現 main 2920.43 / manager 1426.46 / worker 1239.34 / manager_self 251.64 / cost 5586.24,daily 七桶的三欄也都是數字。那時我才敢說這支 API 已經恢復;頁面本身要再開一次才算數。
值得標出來的是我查的東西是什麼。我查的不是「有沒有錯誤訊息」,是「那幾個欄位在不在、是不是數字」。崩潰當下那份 JSON 本身是合法的 JSON,端點也有回應——驗收條件如果寫成「服務起得來」或「端點不報錯」,這一輪照樣會過。條件要寫到欄位層級,才擋得住這種壞法:不是壞在報錯,是壞在少了東西而沒人報錯。
這裡是重點,且要標明這是我的判讀:問題不是「AI 會說謊」,是 AI 判斷「完成」的依據跟我要的依據本來就是兩件事。
兩者多數時候一致,脫鉤時機是外部狀態介入——行程沒重啟、快取沒清、migration 沒跑。這些都不在 diff 裡,派多聰明的模型看自己的 diff 都看不到。所以這是制度問題不是道德問題:要求 worker「更誠實」沒用,它已經很誠實;要補的是誰負責對系統下指令。
我把「不採信自述」寫成了四條硬規則,不靠每次臨場判斷:
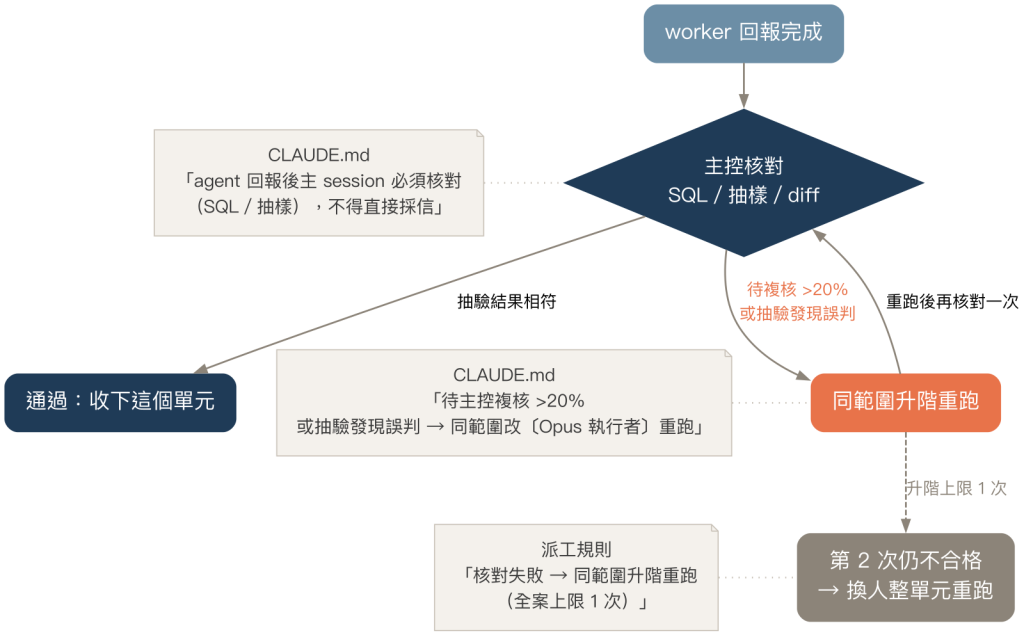
核對通過才算收單元;不過就同範圍升階重跑,而且升階只給一次。
第一條,核對義務在主控。 CLAUDE.md 寫的是:「agent 回報後主控必須核對(SQL / 抽樣),不得直接採信」——寫的是 SQL 和抽樣,不是「再讀一次回報」。派工規則同步寫著:「核對失敗 → 同範圍升階重跑(全案上限 1 次)」。
第二條,退回有量化門檻與上限。 CLAUDE.md 另一條:「回報『待主控複核』>20% 或主控抽驗發現誤判 → 同範圍改〔Opus 執行者〕重跑」。20% 讓我不必爭論「算不算太多」;「全案上限 1 次」防止無限退回——第二次還不行就換人整單元重跑。
第三條,工具也不准替我判完工。 我有一個每輪結束時列出待審變更的提醒機制,CLAUDE.md 記下它的設計原則:「只攤數據不判斷完工、不自動 review」。它每輪結束會說有多少變更還沒 review,但不會說「看起來沒問題」——自動化能把事實推到我面前,不能代替我下結論。
第四條,換成更貴的模型,也不能免驗收。 以這次 dashboard 事故作假設:即使改由更高階模型回報「已完成」,主控仍須確認服務已載入修改,查驗 snapshot 的必要欄位存在且為數字,再確認 Cost 頁能正常顯示;模型身價不能替代這些結果。
「需要更貴的模型」本身也只是待驗的派工理由。較貴模型一次通過、沒有退回或呼叫較少,不能證明便宜模型也能完成同一工作;若要調整下次派工,可把這些紀錄當作試派線索,再用相同驗收條件檢查結果。這裡主張的是驗收標準對所有模型一致,不是用一次成功證明模型可以互換。
這案例本身也變成一條規則進了自製記憶系統:改 dashboard 後端程式後必須重啟服務再驗收。一次事故換一行檢查清單。清單會愈來愈長,這是我接受的代價——比起每次都靠當下想得夠不夠周到,我寧可長。
這四條解掉的是「誰該去查」,但都建立在一個我還沒定義的東西上:什麼才算查過了。
CLAUDE.md 說「SQL / 抽樣」,派工規則多一項「diff」。可是我上面才說 diff 不夠——那 diff 算不算證據?打 API 拿回來的 JSON 算嗎?測試綠燈算嗎?如果標準靠我臨場拍腦袋,這套核對就只是把「相信 worker」換成「相信我當下的心情」。
明天處理:Git、DB、Log、Test 各自能證明什麼、不能證明什麼,怎麼變成可以寫進規則的驗收條件。


 iThome鐵人賽
 看影片追技術