
上一篇完成 AI 調查工具與 Skill。這篇來看看實際產出的巡檢報告。
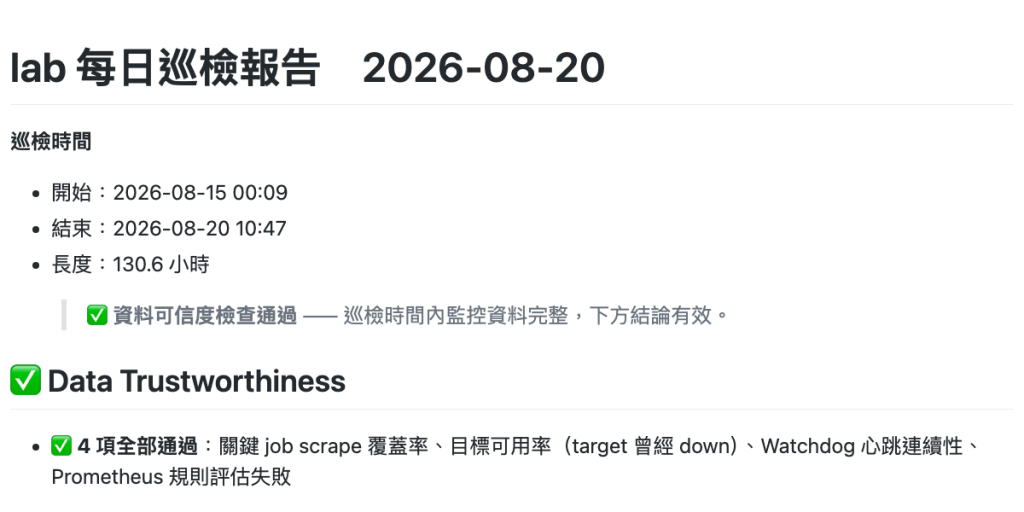
這份報告涵蓋 8 月 15 日到 8 月 20 日。巡檢程式會先確認資料來源是否正常。
這次資料可信度檢查全部通過,代表後面的巡檢結果可以繼續看。
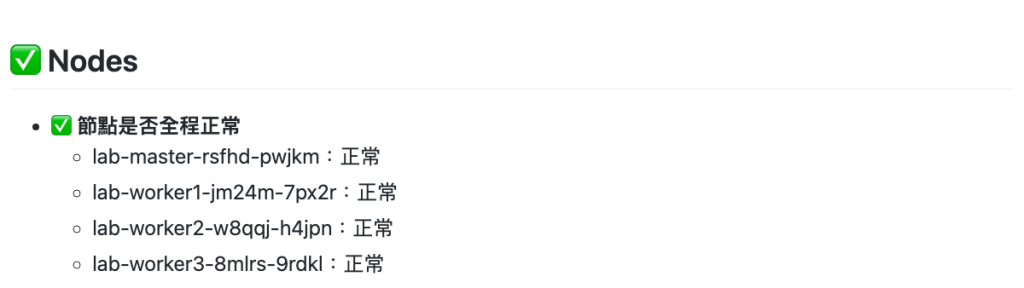
往下看到 Nodes,四個節點在整段巡檢期間都維持正常。
接著是節點資源使用率。CPU 最高值是 14.59%,記憶體最高值是 35.56%,四個節點都沒有超過設定的門檻。
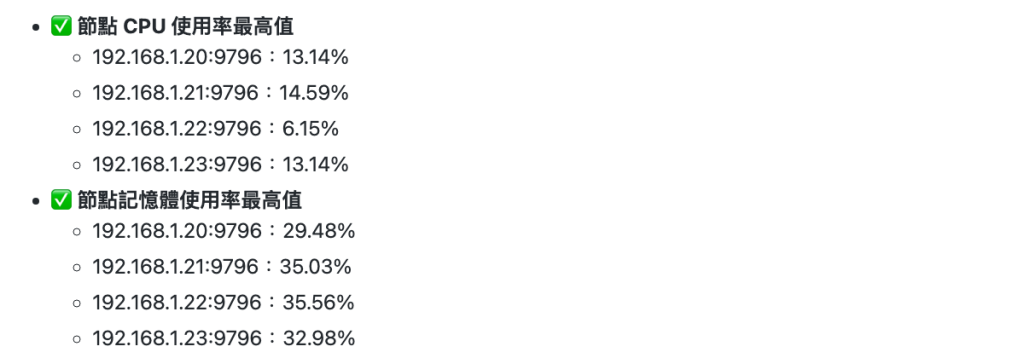
這些項目通過後就保留結果,不交給 AI 調查。
Workloads 有兩個數字要注意:kube-system 在巡檢期間重啟 14 次,lite-bank 重啟 1 次。
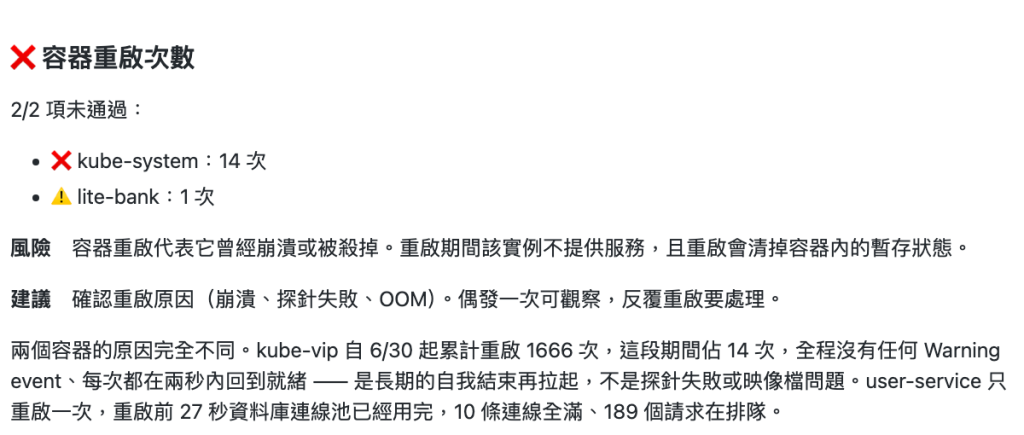
固定規則只負責確認重啟次數超過門檻,因此這兩筆都會被列出來。
kube-vip 已經累計重啟 1,666 次,這次巡檢期間增加 14 次。每次都在兩秒內回到 Ready,也沒有找到 Warning event。現有資料只能確認它長期反覆結束再拉起,還看不到每次結束的原因。
user-service 只重啟一次,數字看起來比較小,重啟前的 log 卻記錄了連線池沒有可用連線,以及服務關閉的時間。
報告直接寫成「kube-system 重啟 14 次、lite-bank 重啟 1 次」,這兩個名稱其實是 Namespace,真正重啟的是裡面的 Container。這段描述不夠精確,後續可以調整提示詞或程式輸出。
完整調查把 user-service 的資料庫連線池狀態、服務關閉與恢復時間放在一起。
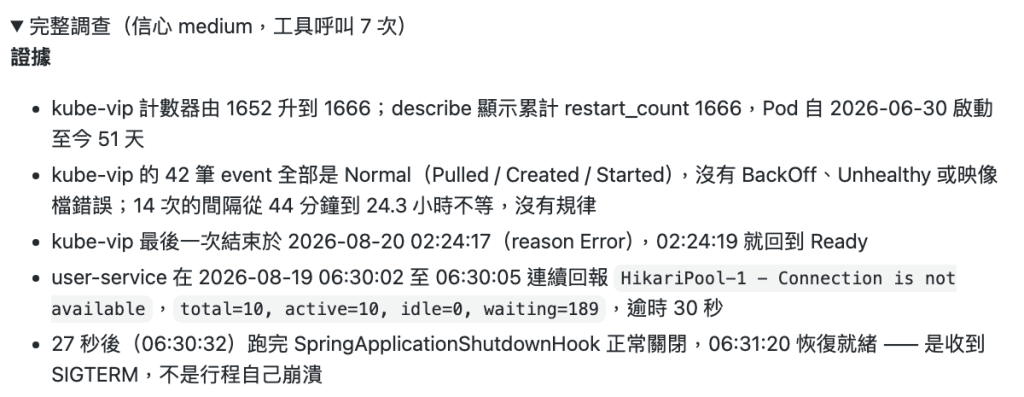
AI 用工具呼叫整理出以下時間線:
06:30:02~06:30:05
HikariCP 連線池的 10 條連線全部使用中
189 個請求正在等待連線

06:30:32
user-service 執行關閉流程

06:31:20
Pod 恢復 Ready
固定規則原本只提供「重啟 1 次」。AI 將 Container restart、應用程式 log 與 Pod 狀態放在同一條時間線後,維運人員可以先檢查資料庫連線池、流量狀況與健康檢查設定。
「證據不足,未能確認」列出當時收集範圍內沒有 kubelet log。
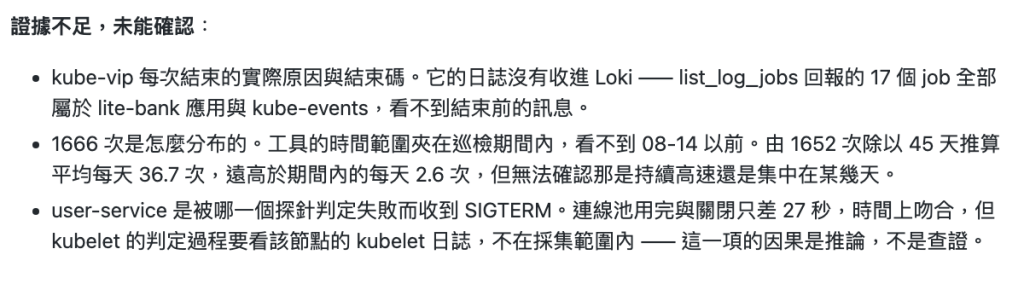
這份調查的信心標成 medium。連線池沒有可用連線,27 秒後服務開始關閉,時間上高度相關,但現有工具讀不到 kubelet log,還無法確認是哪一個 probe 觸發後續動作。
Kubernetes Event 段落列出 51 行 SyncLoadBalancerFailed log,同一個 Event 的累計次數 count 則是 3,128。
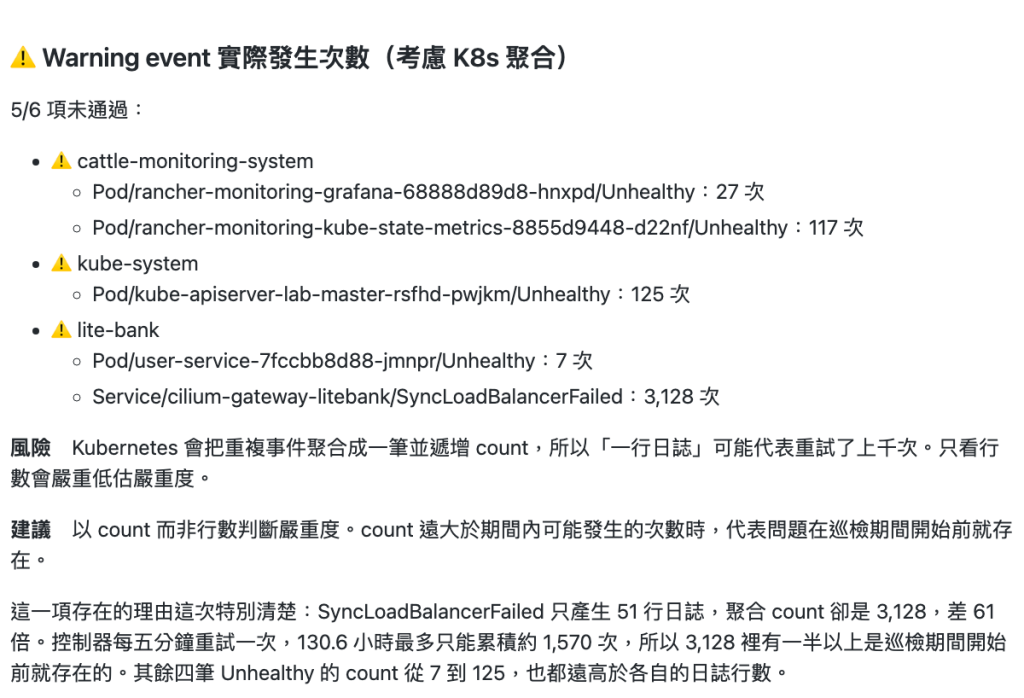
Kubernetes 會把重複 Event 記在同一筆物件裡,後續發生相同事件時持續增加 count。在這段巡檢期間,Loki 查到 51 筆 SyncLoadBalancerFailed Event log,同一個 Event 物件的 count 已經累計到 3,128。51 代表收進 Loki 的 log 筆數,不能當成實際發生次數。
這次巡檢長度是 130.6 小時。控制器大約每五分鐘重試一次,巡檢期間最多累積約 1,570 次。現有的 3,128 次裡,有一半以上在巡檢開始前就已經存在,代表這是一個持續很久的問題。
這一項的 AI 調查工具呼叫次數是 0。規則層保存的 Event 行數、count 累計次數與巡檢時間已經足夠判讀,不必再呼叫工具。
這次報告有抓到 no matched IPPool 的錯誤訊息,可以確認 controller 持續重試。現有工具無法讀取 CiliumLoadBalancerIPPool 這類 CRD,AI 到這裡就無法再往下查。報告會把這項限制留下來,交給維運人員繼續確認 IPPool 的狀態。
接下來可補查兩個項目:
user-service 重啟前沒有可用的資料庫連線,接下來要檢查連線池設定、當時流量與健康檢查,並補查 kubelet log。no matched IPPool,接下來要直接查看 CiliumLoadBalancerIPPool 的狀態。維運人員可以接著補查 kubelet log 與 CiliumLoadBalancerIPPool 狀態。
這份報告確實能統整正常與異常項目,也能把 Container restart 整理成時間線,並保留 no matched IPPool 等錯誤訊息。
不過這次沒有通過的項目,像 Container restart、Warning Event 與 Cilium controller 錯誤,本來就可以設定告警。如果告警發生時已經會通知維運人員,每天再產生一份報告,很可能只是把大家已經知道的事情重新列一次。
目前我能想到的額外價值,是每日巡檢有機會抓到還沒有設定告警的項目。因此,我對每日巡檢的必要性仍然保持懷疑。也許有些維運情境確實需要這份報告。
今天就先寫到這,我們明天見!


 iThome鐵人賽
 看影片追技術