
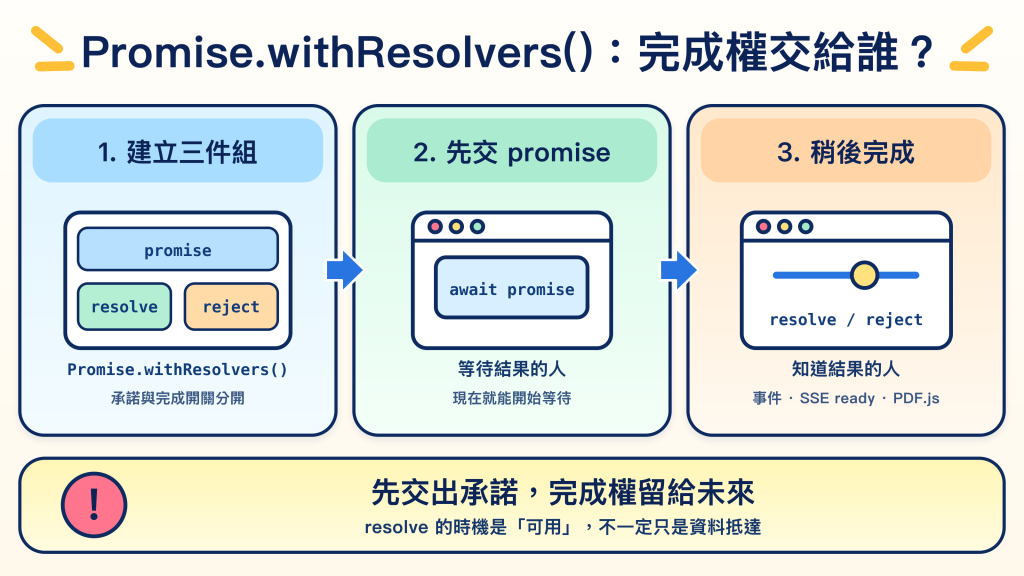
以前常把 Promise 想成「資料一回來、fulfilled 就結束」。但有一種模式,是希望完成 Promise 的開關(resolve / reject)能交給外部或未來的行為使用,而不是在建立 Promise 的當下就把完成權決定好——它可能要等一個未來的事件,或等一段資料流被處理到某個「可用節點」。Promise.withResolvers()(ES2024)把「承諾」和「兌現的開關」分開,讓等待結果的人與知道結果的人,可以是不同段程式。
前置知識:理解 Promise、resolve / reject 與 async / await; 可以讀讀 Day 10 文章 幫助記憶。
學習路線:Day 10–17 從 Promise、Async Iterator、Web Streams 到 Array.fromAsync(),主軸都是「未來的資料怎麼等」;其中 Day 15 的 SSE 說明事件如何一筆一筆推來。今天補上一個常被忽略的角度:完成的時機,有時候不一定希望由「這個函式」決定。
標籤:ES2024 Promise.withResolvers Deferred 非同步生命週期 PDF.js
promise 交出去,resolve / reject 留在外面等未來觸發。Promise.withResolvers() 的三個欄位與典型用法(UI 事件、資料流的 ready 訊號)。withResolvers(),何時用 async / new Promise() 就夠。資料都回來了,難道 Promise 還不能結束.....?
多數人第一次認識 Promise,是從 await fetch() 開始的:
const response = await fetch("/api/products");
const products = await response.json();
在這個直覺裡,Promise 的心智模型很單純,我就等待到你有結果出來:
發出請求
   ↓
等資料回來
   ↓
resolve(fulfilled)
   ↓
await 後面繼續
這裡有個容易被忽略的細節:「完成 Promise 的那個開關(resolve),藏在 fetch 內部」。你不需要自己呼叫它,資料到了,fetch 就替你 resolve 了。
大多數情況,這個直覺完全夠用。真正會卡住初學者的,是下一種情況。
想像一個「確認刪除」的對話框。呼叫端希望這樣寫:
const confirmed = await openConfirmDialog({ title: "確定要刪除嗎?" });

if (confirmed) deleteItem();
問題來了:openConfirmDialog() 被呼叫的當下,使用者還沒按任何按鈕。結果要等未來某個 click 事件才會出現:
呼叫 openConfirmDialog()
        ↓
現在就要拿到一個 Promise(但還是 pending)
        ↓
使用者稍後按下「確認」或「取消」
        ↓
這時才知道結果 → resolve
用一般的 new Promise() 會遇到障礙:你沒辦法在 executor 裡「停下來等使用者點擊」。真正握有結果的,是之後才觸發的事件 callback,而它在 executor 外面。
過去大家的解法,是把
resolve/reject**從 executor 裡「拉出來」**存到外層:
function createDeferred() {
  let resolve;
  let reject;

  const promise = new Promise((res, rej) => {
    resolve = res; // 把開關接到外層變數
    reject = rej;
  });

  return { promise, resolve, reject };
}
這招之所以成立,關鍵在於 executor 是同步執行的(這點Day 10在談 Promise 創建時我們有談過):
new Promise(executor)
        ↓  executor 立刻同步跑完
resolve / reject 已被接到外層變數
        ↓
promise 回傳(此時仍 pending)
        ↓
未來任一事件呼叫 resolve() → 完成
回傳的這個 { promise, resolve, reject },就是一個 Deferred,延遲模式:
一個「待定的承諾」(
promise),加上「兌現它的兩個開關」(resolve/reject),打包在一起。
它的價值是把兩種角色拆開:
等待結果的人:await deferred.promise
知道結果的人:click 事件裡呼叫 resolve() / reject()
「先交出 Promise、把開關留在手上」不是新需求。原生 Promise 還沒普及的年代,各大函式庫早就內建了對應的 helper:
| 函式庫 | API |
|---|---|
| Q | Q.defer() |
| jQuery | $.Deferred() |
| AngularJS | $q.defer() |
用法幾乎一致:拿到一個 deferred、交出 promise、把 resolve / reject 留著等未來觸發。需求一直都在,只是過去得靠上一節那段樣板碼手動把開關取出。
ES2024 把這個模式標準化成一行:
const { promise, resolve, reject } = Promise.withResolvers();
| 欄位 | 責任 |
|---|---|
promise |
交給呼叫端用 await 或 .then() 等待 |
resolve(value) |
讓 Promise 跟隨 value 完成 |
reject(reason) |
讓 Promise 以錯誤結束 |
它沒有發明新的非同步模型,只是把「Deferred」這個老樣板碼變成語言內建。回到確認視窗,就能寫得很乾淨:
function createConfirmDialog() {
  const { promise, resolve } = Promise.withResolvers();

  return {
    promise,
    confirm: () => resolve(true),
    cancel: () => resolve(false),
  };
}

const dialog = createConfirmDialog();
confirmButton.addEventListener("click", dialog.confirm);
cancelButton.addEventListener("click", dialog.cancel);

const confirmed = await dialog.promise; // 等使用者按下才有結果
小提醒:如果
resolve不需要離開建立處(像setTimeout那種),普通new Promise()就夠了,用不到 Deferred。Deferred 是為「完成權要交給別人、別的時間點」而存在。
resolve 有時等的不只是「資料抵達」,而是需要告訴使用者「到達可用節點」剛開始看 Promise.withResolvers(),很容易覺得它只是一個「把控制權(resolve / reject)暴露出來」的新 API——好像只是讓語法寫起來方便一點。但多讀幾次、回頭反思就會發現:一個流程要完成的,不一定只是「等一筆非同步資料回來」。
實務上常常同時有好幾件非同步的事在跑,而且不見得都跟「收資料」有關——資料解析、轉碼、格式驗證……這些「處理」同樣要花時間,也同樣是完成的一環。
資料傳輸生命週期
────────────────────────►
chunk → chunk → chunk → chunk...


文件生命週期
────────────────────────►
loading → parsing → initializing → ready
我們真正想交給使用者的,往往是「這些處理都做完、資料進入可用狀態」的那一刻,而不是「第一批 bytes 抵達」的那一刻。
所以換個角度看,resolve() 等的有時不是「資料抵達」,而是「整段流程被處理到一個可用節點」。
確認視窗等的是「一個未來事件」。再往前一步,把它換成一串陸續到達、還要再加工的資料,就能看到這篇真正想講的角度。
Day 15 的 SSE 會讓事件一筆一筆推來。如果你要逐筆處理,用 for await...of 很自然。但有時候你要的不是每一筆,而是「這串資料處理到某個節點時,給我一個『可以開始了』的訊號」。這正是 withResolvers() 的舞台:
function whenConfigReady(source) {
  const { promise, resolve, reject } = Promise.withResolvers();

  let raw = "";
  source.addEventListener("message", (e) => {
    raw += e.data;                      // ① chunk 一段一段收進來(原始、還不能用)

    const config = tryParseConfig(raw); // ② 累積夠了,才解析/轉換得出來
    if (config) {
      resolve(config);                  // ③ 轉換完成、資料可用 → 這時才 ready
    }
  });
  source.addEventListener("error", reject);

  return promise; // 先把「可用訊號」交出去
}

// 拿到的是「已經處理好、可以直接用」的結果,不是原始 chunk
const config = await whenConfigReady(source);
chunk ─ chunk ─ chunk ...        資料一直來(原始、還不能用)
                 │
     累積到能解析出完整 config(轉換完成)
                 ↓
        resolve(config)  ← 這時才把「可用的結果」交給使用者
注意兩件事:resolve() 交出去的不是原始 chunk,而是轉換完成、可直接使用的 config;而它等的也不是「有沒有資料」——chunk 一直在來——是「資料被處理到一個可用節點」。這就是心智模型的升級:
Promise 不只是「等一筆資料回來」,它也可以代表「一段資料流處理到某個可用狀態」的完成訊號。
也因為如此,這種寫法不能簡化成一條 await load()。有三個訊號,只要出現就代表「該用 Deferred」:
resolve 由事件 / callback 觸發,不是某個函式的 return。promise 必須在資料開始進來之前就交出去。await 就結束PDF.js 是 Mozilla 開源的 JavaScript PDF 引擎,用純瀏覽器技術(主要是
<canvas>)把 PDF 畫出來,不需要任何外掛——你在 Firefox 打開 PDF 看到的檢視器,底層就是它。
它解決的流程滿龐大,看原始碼應該會嚇跑大家🤣,用白話簡單來說:
PDF 是複雜的二進位格式,裡面有交叉引用表(xref)、物件、字型、影像與各種壓縮。
交叉引用表比較像「一個帶索引的物件資料庫 + 一份繪圖腳本」,而不是一張現成的圖。而且這些資料在網路上就是一串原始 bytes——瀏覽器拿到的可能是 Blob 或 ArrayBuffer,但真正要逐 byte 解析時,得先轉成 Uint8Array ,把這些原始 bytes 解析、解碼成畫面很吃 CPU,若全放在主執行緒做,頁面會卡住。
於是 PDF.js 把重活丟到背景的 Web Worker,主執行緒只留下 API:
主執行緒(你的程式碼)             Web Worker(pdf.worker.js)
getDocument / getPage / render  ←──►  解析 xref、解碼字型/影像、
        (postMessage 訊息往返)        產生繪圖指令
再加上檔案本身可以用 streaming / range request 分段抓,於是同一時間有好幾條非同步的線在跑。這也是為什麼它的 API 不是「一次 await 就好」。
初學者看到 PDF 預覽,直覺會想:不就
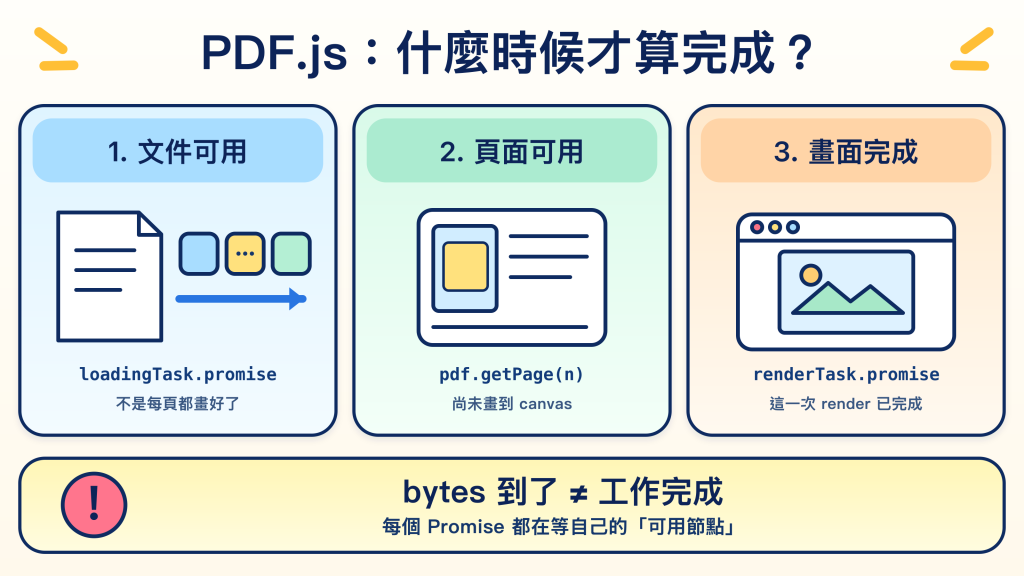
const pdf = await loadPdf()嗎?但 PDF.js 的實際 API 一次就有三個階段:
const loadingTask = pdfjsLib.getDocument(url);
const pdf = await loadingTask.promise;      // ① 文件載入完成

const page = await pdf.getPage(1);          // ② 取得某一頁

const renderTask = page.render(renderContext);
await renderTask.promise;                    // ③ 這一頁畫完
document loading → page loading → page rendering
這三個階段各做不同的事,別把它們混為一談——真正「轉成畫面」的其實只有 render:
| 呼叫 | 它做的事 | 是不是「轉成畫面」 |
|---|---|---|
getDocument(url) |
worker 抓 bytes、解析文件骨架(xref、目錄、頁樹),知道整份文件有哪些頁 | 否(解析結構) |
pdf.getPage(n) |
取得某一頁的「描述資料」(尺寸、資源引用、內容流位置),回一個 PDFPageProxy |
否(定位並載入這頁的目錄資料) |
page.render(…) |
把這頁內容流解壓成繪圖指令、解碼字型/影像,照指令畫到 <canvas> |
✅ 真正成像在這裡 |
換句話說,getPage 只是「翻到並讀取這一頁的頁首資料」,還沒把它畫出來;吃 CPU 的解碼與成像主要落在 render。
為什麼要拆這麼細?因為一份 PDF 的載入不是「整包下載完再用」,而是好幾條各自獨立的非同步流程同時在跑:
整份文件可用了       ← loadingTask.promise
某一頁可用了         ← getPage() 的 Promise
某一次 render 畫完了  ← renderTask.promise
這帶出關鍵一句:
「資料到了」不等於「整個工作 ready」。底層某段資料抵達,不代表上層生命週期完成。
這就是第四節那兩條並行生命週期的真實案例——只是這次把 PDF.js 真正 resolve 的點也標出來:
資料傳輸生命週期
────────────────────────►
chunk → chunk → chunk → chunk ...

文件生命週期
────────────────────────►
loading → parsing → initializing → ready
                                    ▲
                         loadingTask.promise
                         在這裡才 resolve
上面那條一直有 chunk 進來,不代表下面那條就到站;loadingTask.promise 等的是文件生命週期跨過 ready,而不是傳輸生命週期又收到一段 bytes。
這正是第四節那句話的具體版本:
resolve等的是「到達可用節點」,不是「資料抵達」。
而且這些工作在還沒完成前,外部可能就要介入取消打斷,有點像上面舉的事件呼叫控制 Promise,~最典型的是翻頁:
使用者正在看第 1 頁 → 開始 render page 1
        ↓
突然跳到第 30 頁
        ↓
第 1 頁的 render 已經沒有價值 → renderTask.cancel()
所以 PDF.js 不會只回一個 Promise,而是回一個 task 物件,讓呼叫端在完成前也能觀察、干預:
task 物件
├─ promise        ← 等這項工作完成
├─ onProgress     ← 觀察進度
└─ cancel / destroy ← 決定「還要不要繼續」
renderTask.cancel():取消目前這次 render。loadingTask.destroy():中止相關的 network request 並銷毀 worker。一句話總結這個情境:
Deferred 特別適合「工作已經開始,但在完成以前,外部還需要觀察或干預它」的場景。
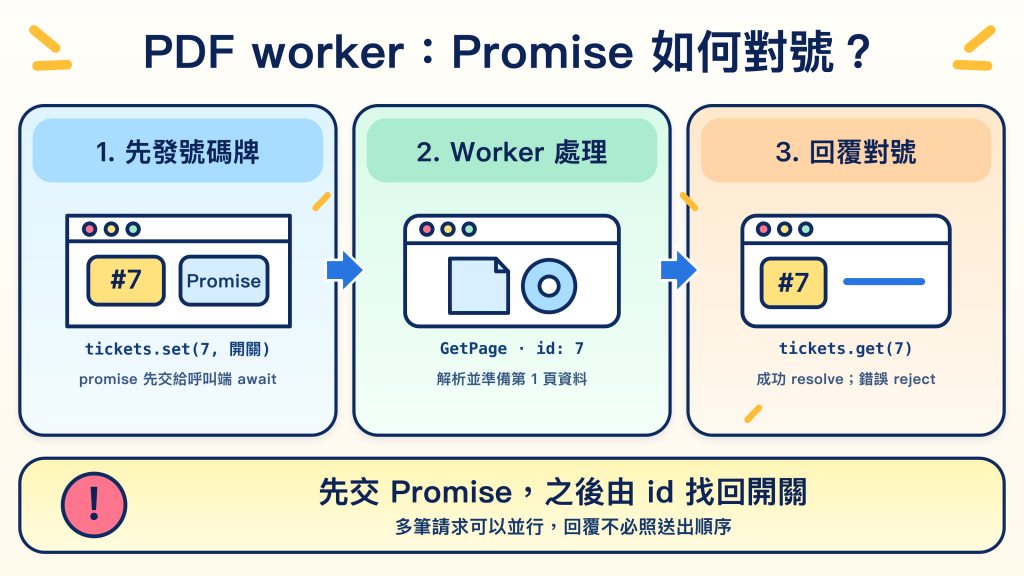
PDF.js 最常用它的地方,是主執行緒和 worker 的「一問一答」:
主執行緒請 worker「幫我解析第 1 頁」,worker 要算一下才有結果,但呼叫端現在就想要一個能 await 的 Promise。
這就像去餐廳點餐、拿號碼牌:
你(主執行緒)              廚房(worker)
點餐「第 1 頁」
  → 拿到號碼牌 promise         …做菜中…
  → 先拿著等 await
                       ← 叫號「1 號好了!」
  → 對號取餐 resolve()
promise(現在就拿得到)resolve,把結果交給你這個「發號碼牌」大致長這樣(簡化示意):
// ── 主執行緒:發號碼牌的小工具 ──
let nextId = 1;
const tickets = new Map(); // id → { resolve, reject }(號碼牌存根)

function sendWithPromise(worker, action, payload) {
  const { promise, resolve, reject } = Promise.withResolvers();

  const id = nextId++;
  tickets.set(id, { resolve, reject });        // ① 記下這張號碼牌
  worker.postMessage({ id, action, payload }); // ② 點餐(送去廚房)

  return promise;                              // ③ 先把號碼牌交出去
}

// ── 廚房叫號(worker 回覆)→ 對號取餐 ──

worker.addEventListener("message", (e) => {
  const { id, result, error } = e.data;
  const ticket = tickets.get(id);
  if (!ticket) return;
  tickets.delete(id);  // 取得之前 Promise.withResolvers 發出來的 reject/reslove

  if (error) ticket.reject(error);
  else ticket.resolve(result);                 // ④ 把結果交給當初 await 的人
});
呼叫端用起來就跟一般 async 一樣自然:
const page = await sendWithPromise(worker, "GetPage", { pageNumber: 1 });
那張 tickets 表是必要的:同時可能點很多餐(多個請求並行),回覆又不一定按順序回來,靠 id 才能把每則回覆對回當初的 promise。這也是為什麼不能只用一個函式的 return——resolve 是被「叫號事件」觸發的,而且號碼牌得先交出去。
是不是很熟悉這類模式:Deferred 特別適合「工作已經開始,但在完成以前,外部還需要觀察或干預它」的場景,worker 需要某段非同步流程的控制權,操作完畢後交還資料給它。
這招也不是 PDF.js 自己發明的。它以前用手寫版本,2024 年直接換成原生的 Promise.withResolvers()(PR #17854),正好說明:原生 API 就是把大家寫了很多年的老寫法收進語言。
小提醒:
Promise.withResolvers()是 ES2024 的新語法,較舊的 Safari/Node 可能出現is not a function,上線前記得確認執行環境(替代寫法見文末)。
不要因為它是新 API 就到處改寫。先問「完成點在哪裡」:
| 情境 | 較適合的做法 |
|---|---|
| 自己控制的線性非同步流程 | async / await |
建立 Promise 時就能註冊完成 callback(如 setTimeout) |
new Promise() |
| Promise 必須先交出,完成權由未來的事件 / 資料流節點決定 | Promise.withResolvers() |
| 要逐筆處理持續到達的多筆資料 | Async Iterable / Stream(Day 12–16) |
一句話記住 Deferred:
async適合描述「怎麼一步步走到完成」;Deferred 適合描述「完成這個狀態,何時、由誰觸發」。
今天把 Promise 的心智模型往前推了一步:
初階直覺:資料回來 → fulfilled
        ↓
升級後:  資料流處理到「可用節點」 → fulfilled
Promise.withResolvers() 沒有魔法,它只是把一個舊的處理模式——Deferred——收進語言:
先交出承諾,完成權留給真正掌握生命週期的地方。 從一個確認視窗,到 SSE 的 ready 訊號,再到 PDF.js 的 loading / render / cancel,都是同一個問題的不同規模:
完成的時機,不一定由建立 Promise 的那個函式決定。
下一篇希望能稍微暫緩腳步,把 Day 10–18 提到很多非同步和資料流動概念的心智模型放回同一張地圖。
Promise.withResolvers()——最貼本篇主題:從「把完成權交到外部」的角度講用途。Promise.withResolvers()——資深 JS 作者的清楚範例與動機說明。Promise.withResolvers() in Node.js tests——測試裡「先交出 promise、之後再 resolve」的實戰案例。


 iThome鐵人賽
 看影片追技術