
🔁 worker 可以換,已做過的工作不能只留在它的 memory 裡。接手前先查進度,別急著重做。
昨天在 Day 6,我們把使用者按下停止之後要做的事情拆開:停畫面、停工作、擋住舊結果,還有處理已經發生的效果。今天換另一種中斷。
先把前幾天用過的名詞接回來。沿用 Day 4 的分法,Run 是這次任務,Attempt 是 Run 裡某一步的第幾次嘗試;worker 則是跑 loop 的 process。
Checkpoint 是存到 process 外、讓接手者能讀回的進度紀錄。它不會自動把磁碟上的檔案一起保存下來。
Day 6 講的執行權今天也會一直用到。它是一個版本號,用來表示「現在誰有資格提交進度」。換人接手就換一版,舊版本不能再寫。今天要處理的,就是新的 worker 怎麼找回這些資料,接著同一個 Run 做下去。
CI 還沒回來,部署先把正在工作的 worker 換掉了。新 worker 啟動後,對話最後一句是「正在等待測試結果」,接下來該怎麼做?
假設 Coding Agent 已經找過程式碼、改了檔案,也送出 CI。worker 消失後,接手者只拿到對話,找不到工作目錄和原本的 CI job,只好重新搜尋、再改一次,最後又送出第二筆 CI。
畫面看起來繼續跑了,但剛才做過的工作又做了一次。這次沒有人要求停止,任務還要繼續,執行它的 worker 卻不在了。除了對話,系統還要留下什麼,新 worker 才知道哪些已經做完、哪些還在等?
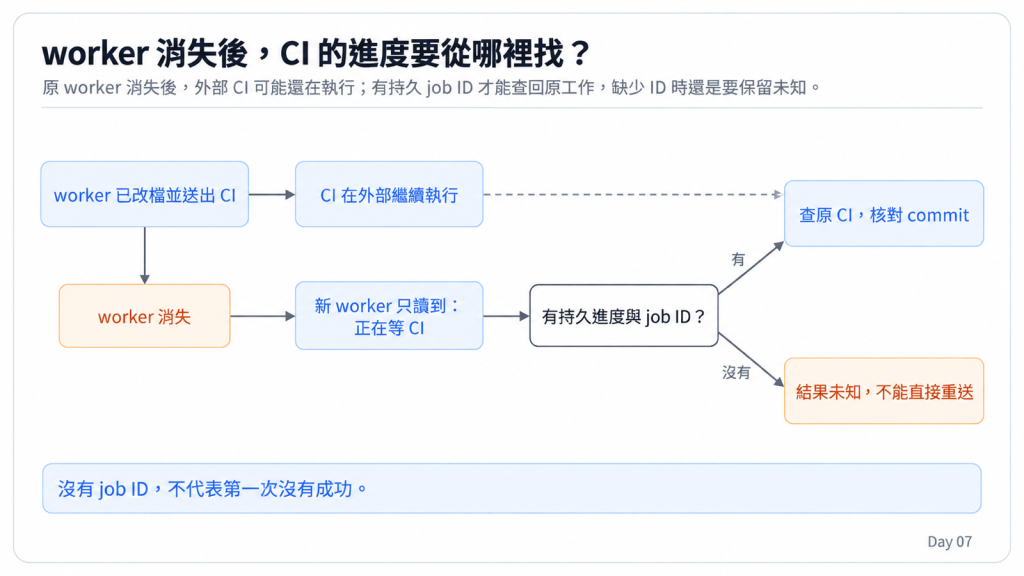
圖:worker 改完檔、送出 CI 之後就消失了,外部那筆 CI 還在跑。新 worker 只讀到「正在等 CI」,接不接得回去,看有沒有持久進度和 job ID:有就查原本那筆 CI、核對 commit;沒有就停在結果未知,不能直接重送。
今天沿著這筆 CI 回答四個問題:要保存哪些資料、接手者從哪裡開始、結果查不到怎麼辦,以及舊 worker 回來後誰能更新進度。最後用同一筆工作驗證:換了 worker,能否接回原本的 CI,而不是再送一次。
先把範圍縮小:這裡只討論工作因部署、pod 替換或機器故障而中斷的情況。恢復時不只要擋住舊結果,還要判斷前面做過的成果能不能繼續用。
要看對話實際存了什麼。Transcript 可以包含使用者訊息、模型輸出、工具呼叫和結果,如果環境版本和工作識別也有保存,當然能成為恢復資料的一部分。
但只留「正在等測試」,就還缺很多資訊:等哪一筆 CI,測的是哪個 commit,檔案改在哪個目錄,外部工作到底送出去了沒有?這些都無法靠一句摘要確認。
我希望接手者至少能分清楚三件事:哪些結果已經完成而且還有效、哪些外部工作還在跑,以及哪些 request 的結果目前不知道。Checkpoint 的作用,就是把已確認的進度存下來,讓後續有地方接,不必再從整段對話猜一次。
新 worker 要接得回去,至少有三塊資料不能只留在舊 process 裡。我會分成三組來看,下面幾個 Production 案例也能幫我們看清楚它們各自負責什麼。
第一組是對話和工具紀錄:使用者要求什麼,模型提出什麼工具,執行結果如何,目前為什麼在等。Shopify 的 Aquifer把這些 Session 歷史放在 Postgres,用 append-only 的方式持續追加。這提供了一個實作例子,儲存方式不用照抄。
第二組是工作環境:檔案、commit、依賴、image、工作目錄和還在跑的工作。可以用 snapshot 保存,也可以從 Git、image 和 lockfile 重建,取決於重建成本及未提交的資料能不能丟。外部 CI 還需要 job ID,本機目錄重建了,不會自動找到原本那筆 CI。
第三組是流程進度:哪些步驟的結果已經存好,現在等什麼,哪些操作還沒確認。DBOS 的 durable execution 說明就示範了保存 workflow 步驟和結果,恢復時取回已記錄的結果。不過外部操作能不能安全重做,還是要看那個操作的規則。
這三組不一定要分成三個資料庫,但必須能從同一個 Run 找回對應的工作目錄、checkpoint 和每一步的結果。
換 worker 本身,不代表所有步驟都多了一次 Attempt。 新 worker 如果只是繼續查原本的 CI,追的還是同一件外部工作;只有真的重試某一步,那一步的 Attempt 才增加。至於誰有權提交進度,一樣沿用 Day 6 的執行權版本判斷。
少了任何一塊都可能接錯。只有檔案,不知道當初為什麼改;只有流程位置,又不知道測試對應哪一版程式。
Cursor 的 Cloud Agent 回顧提到,他們早期讓一個 worker 拿到 Agent 後,就一路把 loop 跑到底。模型服務故障、pod 被換掉或 EC2 節點失效,都可能讓整段工作中斷。後來,他們把 loop 搬到 Temporal,並把對話、機器狀態和工作進度分開管理。
Temporal 是工作流程引擎。開發者用 SDK 寫 Workflow 和 Activity,再連到自架的 Temporal Service 或 Temporal Cloud。Temporal Worker 負責執行這些程式,服務則保存歷史和安排派工。這裡的 Temporal Worker,是執行 Workflow/Activity code 的 process;不一定等同於前面所說、承接整個 Agent Run 的 worker。Temporal 本身也不是會直接操作 repository 的 Coding Agent。
這個案例我覺得值得參考的,是把進度移出單一 VM,讓 worker 可以替換。只有 queue 還不夠:queue 能把工作再送一次,卻不會順便判斷哪一步可以重做。已有 workflow engine,就先用它的保存、等待和派工功能,Harness 不必再寫一套排程器。
這也有維護成本。Cursor 後來發現長期不結束的 workflow 難升級,改用較短的 workflow,版本和遷移一樣要處理。採用 durable runtime,恢復方式還是得想清楚。
Temporal 的 Agent 架構說明把 LLM 呼叫和外部 I/O 放進 Activity,也就是實際做事的函式;Workflow 負責安排它們的順序。恢復時,Workflow 依歷史重播,遇到已記錄完成的 Activity 就取回結果,不會為了重播再叫一次模型。如果 Activity 已在外部做完、完成紀錄卻還沒存好,重試還是可能重複效果,不能把這當成外部操作的 exactly-once 保證。
把同一筆 CI 放進這個模型,可以這樣理解。這是依 Temporal 官方執行模型整理的教學例子,不是 Cursor 內部實作的還原。應用程式把「送出 CI、等待、讀取結果」寫成 Workflow;真正呼叫 CI API 的函式則寫成 Activity,交給 Temporal Worker 執行。
這裡有個缺口:CI 已建立 job 471,但 Activity 的完成結果還沒存進 Temporal,worker 就掛了。 引擎可能重試 Activity;是否再開一筆 CI,取決於你有沒有用可查證的操作識別,或 CI 提供的去重能力。Temporal 保存流程,不會替外部 CI 補出它沒有的去重協定。Temporal|Activity Execution
工作目錄也還是由應用程式保存或重建。Temporal 記得「改檔已完成」,不等於舊 VM 裡未提交的 patch 已經搬到新 VM。
Resume 就是中斷後接著做,但實際從哪裡開始,要看 runtime 的執行方式。有些 runtime 會重跑控制流程,再取回已保存的結果;有些則會從某個 node 的開頭重新執行。不能假設原本的 function 呼叫堆疊會原封不動地回來。
如果直接重新呼叫模型,它可能選到不同工具,搜尋結果和環境也可能已經變了。所以接手時,我會先分清楚哪些結果已經確認而且還能沿用,再處理尚未確認的工作。這不是另一套 Run status,只是把接手時會遇到的情況攤開來看:
| 中斷時狀態 | 接手動作 |
|---|---|
已確認完成(checkpointed_complete) |
核對結果、commit、工作目錄和環境版本,還適用才沿用 |
外部工作還在跑(pending_external) |
使用原本的外部 Job ID 查詢,不立刻重送 |
能證明尚未開始(not_started) |
只有持久紀錄和執行協定足以證明請求尚未送出時,才直接開始;沒有 Job ID 不算證明 |
結果未知(outcome_unknown) |
查詢原操作,依下游規則使用同 key retry,或交給人對帳 |
版本不相容(incompatible) |
先停止,確認是否需要遷移或人工處理 |
冪等性(idempotency)指同一個操作重做,不會多產生一份效果。例如下游支援 idempotency key,使用相同 key 和參數重送,才可能回到同一筆工作。timeout 只表示沒有及時拿到回應,對方可能早就做完了。
已完成的測試也不能永遠沿用。checkpoint 記的是 commit A 和依賴版本 L1,新 worker 卻改用 commit B 或另一個 image,原本的通過結果未必適用。所以保存結果時,也要知道它對應的輸入和環境。
有三種情況,在本地紀錄裡可能看起來一模一樣:request 還沒送出;外部已經完成,但回應遺失;worker 已拿到回應,還沒存下來就掛了。
如果只記「準備送出」,這三種情況都可能沒有結果。要安全地接著做,得先用外部操作的識別去查,不能從空值直接猜第一種。
我會照手上有哪些證據決定下一步:
| 手上有什麼 | 可以做什麼 | 如何確認結果 |
|---|---|---|
| 可查詢的 External Job ID | 查原工作目前狀態 | 已完成或失敗就記錄結果;還在跑就繼續等,避免重送 |
| 沒有 Job ID,但下游支援穩定 idempotency key | 用同一把 key 重送 | 相同參數而且還在去重有效期內,就能依下游規則取得同一操作的結果 |
| 沒有 Job ID、不支援冪等,但操作可補償 | 先查出原操作到底做了什麼,再針對那個效果做補償;查不出來就停下對帳 | 補償本身也會失敗,一樣要追結果;還沒確認前不能再補一次 |
| 以上皆無 | 不要自動重試 | 維持 outcome_unknown,交人工對帳 |
最後一列停在未知,是刻意保留的選擇。付款或寄信查不到結果,又沒有去重保證,自動 retry 可能多做一次,不能只因為想讓工作繼續就放行。
這也表示,送出前要先保存自己這邊的操作 ID 或 idempotency key。外部 job ID 通常得等對方建立工作後才知道,可以收到再補,但自己的操作識別要先有。
先存再送,即使中斷,至少還有一筆能追查的操作;先送再存,可能外部已經做完,本地卻連該查哪件事都不知道。
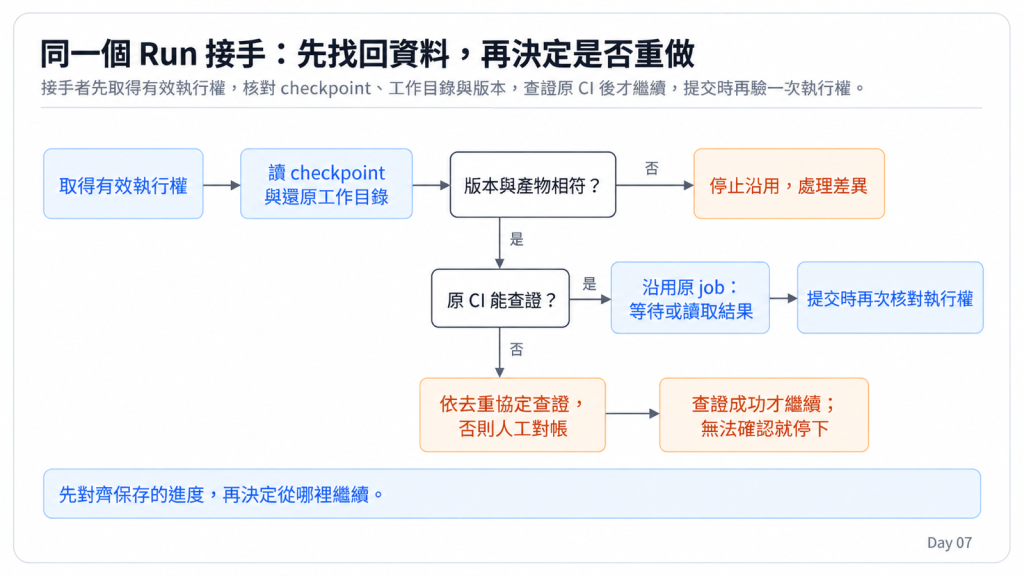
圖:接手先取得有效的執行權,讀 checkpoint、還原工作目錄,再核對版本和產物對不對得上。對不上就停止沿用、處理差異;對得上再看原 CI 查不查得到:查得到就沿用原本那個 job 等結果,提交時再核對一次執行權;查不到就依去重協定查證,否則交人工對帳,確認不了就停下。
這些資料可以直接放進現有的 Run 儲存。沿用等待 CI 的情境,我會至少留下下面幾項。欄位名稱只是示意,不需要為此另外建一套 schema。
| 資料 | 情境裡的值 | 誰在什麼時候使用 |
|---|---|---|
| Run/Attempt | 同一個 Run;每個步驟各自保留 Attempt 紀錄 | Harness 找回各步驟結果;只有實際重試該步驟,才增加它的 Attempt |
| checkpoint 與版本 | 已送出 CI;commit A、依賴 L1、執行程式版本 | 接手的 worker 判斷舊結果能否沿用、是否需要遷移 |
| 工作目錄的保存方式 | commit 加未提交的 patch,或持久保存的 snapshot | worker 啟動時還原;只記舊機器上的路徑找不回檔案 |
| 外部操作識別 | 送出前存的 operation ID/key,收到後補的 CI job ID | executor 送出時寫入;接手時查原工作,避免再送一筆 |
checkpoint 如果指向 patch 或 snapshot,要先確認那份產物已存到 worker 消失後還讀得到的位置。否則記錄寫著「已改檔」,檔案卻只在舊機器上,還是接不起來。
接手也要沿用 Day 6 的執行權檢查。假設舊 worker 持有版本 1,新 worker 接手後取得版本 2;兩邊都回報 CI 結果時,保存進度的入口只接受目前有效的版本。核對版本、Run 還能不能繼續,以及寫入進度,必須用條件更新這類做法協調成一次提交,不能先查再無條件寫。
這只能擋住過期的進度提交,不能阻止舊 shell 直接改檔或遠端 CI 繼續執行。 工作目錄隔離、process 停止和外部操作去重,還是各有自己的責任。如果已經用了 workflow engine,就先沿用它的派工與結果接受機制;只有引擎之外的共享資源,才另外檢查誰有權寫入。
下面只示意呼叫順序;查詢外部工作可能先得到「還在跑」,這時保持等待,不重送:
接手同一個 Run,取得目前有效的執行權
讀 checkpoint,確認程式與資料版本相容
還原對應的工作目錄,核對已完成結果
查原 CI job;沒有 job ID 就依操作識別查證
結果未知 → 保留未知,停止自動重做
確認可繼續 → 讓 loop 接著處理
| 誰呼叫 | 何時呼叫 | 拿到什麼 |
|---|---|---|
| Harness | 派工給接手的 worker 時 | 目前有效的執行權;步驟的 Attempt 另行記錄 |
| worker/executor | loop 繼續之前 | 可沿用的結果與原 CI 狀態;查不清就停在未知 |
假設你已經做到 Day 6:能禁止已取消的 Run 繼續派工,也能拒收過期執行的結果。今天先補「沒有取消、worker 卻消失」的恢復路徑。
先選一條會等待 CI 的任務,把外部操作識別和工作目錄保存方式補進既有紀錄,再測 worker 被換掉後能否接回原工作。
Run 再次顯示 running,只代表工作啟動了,還不能證明恢復正確。接著我會確認它拿到預期的 checkpoint 和正確檔案、沿用原本的 CI job,而且沒有多建立一筆外部工作。
恢復動作本身也要留下紀錄:誰接手、從哪份 checkpoint 開始、使用哪個程式和資料版本、環境怎麼重建,未完成或未知的操作如何處理。
測試時可以刻意在幾個時間點 kill worker:模型回覆存下來前後、工具 request 送出前後、等待 CI 時,以及寫 checkpoint 的途中。恢復後對照不中斷的結果,看檔案、外部 job 數量和任務狀態是否符合預期。外部系統沒提供查詢或去重能力,正確結果也可能是停在未知,等人對帳。
這套設計會帶來儲存、版本相容性、查帳和測試成本。值不值得做,我會一起看重做成本和外部影響;工作已經跑了幾分鐘,只是其中一個條件。
如果工作很短、能安全重做,重跑一次也不貴,那麼保存輸入後整段重來,反而可能更簡單。只有單一 worker 和少量短工作時,先用既有 DB 加上持久工作目錄,就可能已經足夠;等到跨機器、長時間等待、多步重試和版本遷移都變多,再評估工作流程引擎。
Day 18 會把外部操作的去重與查證展開,Day 30 再接在途工作的版本升級。
接手者看到「正在等 CI」,卻找不到 job ID,能不能直接再送一筆?原本的測試通過了,換到不同版本的工作目錄後,又能不能繼續沿用?
沒有 job ID,不代表第一次沒有成功。查原操作、依下游有效的去重規則使用相同 key,或保留未知交給人處理,都可能是正確的恢復方式;測試結果也要對應同一份 commit 和環境,版本換了就要重新確認。
先對齊保存的進度,再決定從哪裡繼續。結果未知的操作不能直接重做。 對話、工作目錄、checkpoint 和外部 job 要對得起來。
到這裡,任務怎麼開始、等待、停止和接手,已經有了基本輪廓。明天把視角移到每輪送出去的模型輸入:同一批規則和工具一直重送,哪些計算可以靠 prompt cache 重用,又有哪些看起來沒改的小地方,會讓它突然失效?


 iThome鐵人賽
 看影片追技術