
🧠 Agent 記下的 memory 會過期。寫進去時連當時的條件一起存,讀回來先看它多舊、條件還在不在;有了新說法,舊的標成已取代,別直接蓋掉。
昨天在 Day 11,我們讓摘要查得回原始證據,那些都發生在同一個任務裡。今天把時間拉長,看上次交代過的事,到了下一個 session 還該不該照做。
快速回顧一下:Day 4 說過 Session 之間預設互相看不到,要跨對話記住東西,得另外定寫入規則和有效期,今天就來補這一塊;Day 4 用來擋掉過期更新的 version 欄位,今天也會用到。Day 10 看過 Claude Code 在 session 開始時,把 CLAUDE.md 和 auto memory 一起放進模型輸入,今天打開 auto memory 看裡面存了什麼。
假設你用 Claude Code 維護一個電商 repo。三個月前 staging 很不穩,e2e 測試(開瀏覽器把結帳流程從頭點到尾)常常莫名失敗,你跟 Claude 說:「這陣子 staging 很不穩,e2e 先別跑,跑 unit test 就好。」畫面跳出一行提示,說存了一筆 memory。這是 Claude Code 的 auto memory:Claude 自己寫筆記,存在你電腦上的一個目錄,下次開 session 會讀回來。目錄裡多了兩樣東西:
~/.claude/projects/<專案>/memory/
├── MEMORY.md             ← 索引,每個 session 開始時放進模型輸入
└── feedback_testing.md   ← 這筆 memory 本身
MEMORY.md 多的那一行是:
- [測試只跑 unit test](feedback_testing.md) — 改完不跑 e2e
兩週後 staging 修好了,沒人想到要改這筆 memory。三個月後,你開了一個新的 session:「修一下 checkout 的折扣計算,改完跑測試。」Claude 改完、跑了 npm test,回報測試全過。PR 開出去,CI 上的 e2e 掛了。你問它怎麼沒跑 e2e,它說你之前交代過先別跑。這句話你早就忘了,當時那段對話的紀錄檔,Claude Code 預設 30 天後就刪掉了。
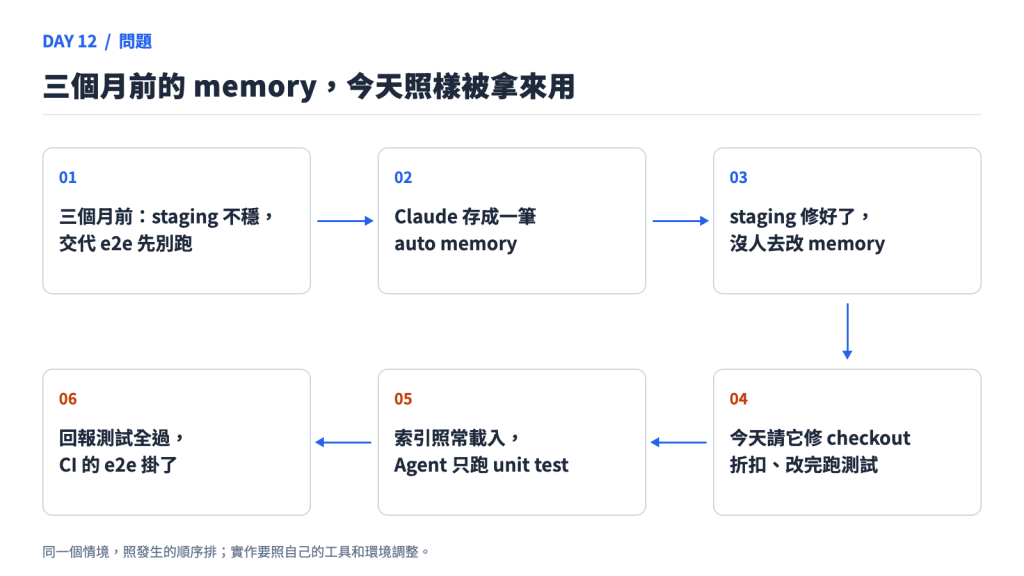
圖:三個月前 staging 不穩,交代 e2e 先別跑 → Claude 存成一筆 auto memory → staging 修好了,沒人去改 memory → 今天請它修 checkout 折扣、改完跑測試 → 索引照常載入,Agent 只跑 unit test → 回報測試全過,CI 的 e2e 掛了。這是示意,實作要照自己的工具和環境調整。
你當時說的沒錯,Claude 也照著做了,只是那句話帶著「這陣子 staging 很不穩」這個條件,今天已經不成立。這筆 memory 當初存成什麼樣子、Agent 讀到時看不看得到它多舊、有沒有機會先問一句,都可能影響這次跑了哪些測試。
下面先把記憶分類,講清楚今天談哪一塊,再看 Claude Code 的 auto memory 怎麼存、怎麼讀,接著沿著這筆 memory 走三段:寫進去時少了什麼、三個月後讀回來看不看得出過期、你給了新說法之後舊的怎麼處理,最後看自己刻 Harness 至少要存什麼。
Letta(一個主打持久記憶的 Agent 框架)有篇文章主張 memory 沒辦法當成外掛裝上去:CLAUDE.md 怎麼載入、skill 的說明放在哪、compaction 之後留下什麼、互動紀錄查不查得到,都是 Harness 在決定,對過去的對話做搜尋只是其中一小塊。這些前幾天碰過一部分,先把記憶分個類,比較好說今天講哪一塊。
常見的分法來自 CoALA 論文,它把語言 Agent 的記憶分成四種。對到 Claude Code 上:
| 種類 | 存什麼 | Claude Code 裡的例子 | 哪一天講 |
|---|---|---|---|
| working memory | 手上這件事正在用的資料 | 這個 session 的對話和工具結果 | Day 4 的任務狀態、Day 8 的目前工作摘要 |
| episodic(經歷) | 以前發生過的事 | session 紀錄檔,三個月前那段對話的原文 | Day 11 的原始歷史 |
| semantic(知識) | 關於外界和使用者的事實 | auto memory 裡的「e2e 先別跑」 | 今天 |
| procedural(做法) | 怎麼做事:模型本身,和程式、prompt、skill | CLAUDE.md、skill |
Day 10 看怎麼載入,Day 30 看怎麼改 |
四種可以放在同一個地方,差別在誰能寫、多久有效、怎麼更新。CoALA 也提醒,讓 Agent 自己改 procedural 這一類,風險比寫 episodic 或 semantic 高很多,容易寫出 bug,也可能讓 Agent 繞過設計者的意圖。Claude Code 的兩種檔案剛好分在這條線兩邊:CLAUDE.md 是你寫的規則;Claude 自己記的放在 auto memory,你叫它「記住」什麼也是存到那裡,要寫進 CLAUDE.md 得明講「加到 CLAUDE.md」,或自己改。
今天只講 semantic 這一塊,也就是 Claude 自己寫的 auto memory,看一筆 memory 從被記下、被讀回來用,到被新說法取代。沿著開頭的情境,會碰到三個問題,發生的時間點不一樣:
| 問題 | 什麼時候發生 | e2e 的例子 |
|---|---|---|
| 過期了沒(新鮮度) | 拿出來用之前 | staging 早就修好了,沒人告訴 Agent,「先別跑 e2e」還留在 memory 裡 |
| 這次要求和記憶,聽誰的 | 你這次講的跟 memory 不一樣 | 你這次明講「連 e2e 一起跑」,memory 寫先別跑 |
| 新說法怎麼取代舊的 | 你給了新說法 | 你說「staging 修好了,以後都跑 e2e」,舊的那筆要改掉,還是留著標成已取代? |
第二個問題的規則最單純:這次講清楚了,就照這次的做,後面用一段帶過。重點在第一和第三個,一個是還沒有新說法,舊的卻可能已經不成立;一個是新說法來了,舊的要怎麼處理。Day 4 說要另外定的「有效期」和「寫入規則」,對到的就是這兩個;寫入規則還包括一開始要記什麼,三段裡先講這個。
跟 memory 有關、但今天不展開的,交給其他幾天:memory 什麼時候載入模型輸入是 Day 10;多個 Agent 分工、成果怎麼合併是 Day 13;查詢時用誰的身分、能看哪些人的資料是 Day 22;外部內容怎麼把模型帶偏是 Day 24;skill 和團隊規則怎麼改是 Day 30。
Claude Code 的文件把跨 session 帶東西的機制分成兩種,並排比過:
CLAUDE.md |
auto memory | |
|---|---|---|
| 誰寫 | 你 | Claude |
| 寫什麼 | 指示和規則 | 從你的糾正和偏好學到的東西 |
| 範圍 | 專案、使用者或整個組織 | 一個 git repo 一份,所有 worktree 共用 |
| 什麼時候載入 | 每個 session | 每個 session,只放索引的前 200 行或 25KB |
Day 10 講的是左邊那欄怎麼進到模型輸入,今天看右邊。
auto memory 的目錄就是開頭那個 ~/.claude/projects/<專案>/memory/,<專案> 照 git repo 算,同一個 repo 底下的子目錄和 worktree 共用一份。Claude 每寫一筆,會在檔案開頭標一個 type,文件列了四種:
type |
記什麼 | 放到電商 repo 會是 |
|---|---|---|
user |
你的角色、專長和工作偏好 | 「後端工程師,前端比較不熟」 |
feedback |
你給的糾正,和你確認過的做法 | 「e2e 先別跑,跑 unit test 就好」 |
project |
進行中的工作、期限和決定,程式碼和 git 歷史看不出來的 | 「月底前 checkout 只修 bug,不加功能」 |
reference |
專案外的資訊去哪裡找 | 「e2e 的結果看 CI 的哪個 dashboard」 |
程式碼看得出來的東西,像架構、檔案路徑、修過的 bug,還有 CLAUDE.md 已經寫了的,Claude 不會存。也不是每個 session 都會存,要看它判斷下次用不用得到。
讀的時候分兩層。MEMORY.md 在每個 session 開始時放進輸入,只放前 200 行或前 25KB,所以一筆一行、細節放在各自的檔案;feedback_testing.md 這種單筆的檔案,Claude 覺得需要時才用一般的讀檔工具去讀。畫面上看到 Saved 2 memories、Recalled 2 memories 這種提示,就是它在寫、在讀這個目錄。檔案都是一般的 markdown,打 /memory 可以開資料夾瀏覽、直接改或刪。
索引寫滿了也有處理。Claude 寫完 MEMORY.md,Claude Code 會量它的大小,接近上限就提醒 Claude 縮短:一筆一行、細節搬進各自的檔案、合併或刪掉過時的;超過上限,寫入照樣成功,但會回一個錯誤要它重寫,因為超過的部分下次不會載入。這個清理是看索引多長才觸發,跟每一筆寫了多久無關。
還有幾種情況,後面會用到:
| 情況 | 會怎樣 |
|---|---|
| 換一台電腦、在雲端跑 | 讀不到,auto memory 只存在這台機器上;同事的 Claude Code 也看不到你的 |
| 同一個 repo 開另一個 worktree | 共用同一個目錄,兩邊都會讀、也都會寫 |
| 交給 subagent 做 | 文件說主對話的 auto memory 不會帶過去;我用 v2.1.280 實測,一般的 subagent 收得到 MEMORY.md 索引,內建的 Explore 收不到 |
| session 紀錄檔放了 30 天 | 預設會被自動刪掉;memory 目錄不在清理範圍,會留到有人改或刪 |
最後,這兩種檔案對模型來說都只是 context,不是強制設定。不管 Claude 怎麼判斷都要擋下的動作,文件建議用 Day 10 提過的 PreToolUse hook。
開頭那句話,存成 memory 可以長成兩種樣子。上面是情境裡 Claude 存下來的(照我用 v2.1.280 存出來的格式,省略兩個欄位),下面把條件和原話也寫進去:
只存結論
  ---
  name: feedback-testing
  description: 改完程式只跑 unit test,不跑 e2e
  metadata:
    type: feedback
    modified: 2026-06-22T03:10:00.000Z
  ---
  改完程式只跑 npm test,不要跑 npm run test:e2e。

連條件和原話一起存
  (開頭那幾欄同上)
  改完程式只跑 npm test,不要跑 npm run test:e2e。
  條件:staging 修好之前。
  原話(6/22):「這陣子 staging 很不穩,e2e 先別跑,跑 unit test 就好。」
只存結論,三個月後就沒有任何東西提醒它可能過期。
Claude Code 的 memory 檔最上面那幾欄,記的是名稱、描述、type 和寫入時間,沒有放條件的欄位,條件有沒有存,要看 Claude 寫內文時有沒有寫進去。我手上的版本還會多記一欄是哪個 session 寫的(文件沒寫這欄),可是那個 session 的紀錄檔 30 天後就刪了。三個月後,這份檔案寫了什麼,就是 Agent 和你手上全部的線索。
用 Claude Code 的話,我會在講的時候就把結束條件講出來:「staging 修好之前,e2e 先別跑。」看到存了 memory 的提示,打 /memory 打開那份檔案看一眼,條件沒寫進去就自己補。
誰說的也要記。這筆是你明講的;Claude Code 的 feedback 還包括你確認過的做法,也就是 Claude 提出、你點頭的那種。自己刻 Harness 可以分得更細:使用者明說的可以直接記;模型從幾次操作猜出來的,只能當候選,標成推測,不能寫成使用者說過;網頁、文件或工具結果裡的文字,不能自己變成 memory。我會讓寫入的工具收一段使用者原話,Harness 在這個 Session 的使用者訊息裡找得到這段話,才記成使用者明說。
範圍也是存的時候要記的。如果你當時說的是「checkout 的 e2e 先別跑」,存成「不跑 e2e」,其他模組的 e2e 也會一起跳過。Claude Code 的 memory 本來就一個 repo 一份,不會跑到別的 repo,但 repo 裡面的範圍,還是要寫進內文。一份 2026 年的研究 BenchPreS 量過這類情況:模型常把記住的偏好當成到處都適用的規則,越會照偏好做事的模型,套錯的比例越高。
Agent 自己不會知道 staging 修好了沒。
Claude Code 在這裡做了兩件事。一件寫在文件裡:Claude 每次寫 memory 檔,Claude Code 會在檔案開頭記一個 modified,也就是寫入時間(v2.1.214 起),讓你和 Claude 讀回來時都看得出這件事有多新。另一件文件沒寫,是我實測看到的:Claude 用讀檔工具讀一份 memory 檔,工具結果前面會多一段提醒。我讀的那份是 7 天前寫的:
This memory is 7 days old. Memories are point-in-time observations, not live state — claims about code behavior or file:line citations may be outdated. Verify against current code before asserting as fact.
意思是:這份 memory 已經 7 天了,memory 記的是當時觀察到的,不是現在的狀態,講到程式行為或行號的地方可能過時,當成事實講出來之前,先對照目前的程式碼。寫完不到兩天的讀回來沒有這段。打開那個 session 的紀錄檔(~/.claude/projects/<專案>/<session>.jsonl)搜 days old 就看得到。
拿開頭的情境對一下,這兩件事幫得上忙,但不一定夠。session 開始時放進去的是 MEMORY.md 那一行索引,只有檔名和一句描述,沒有日期;Agent 看索引就照做的話,不會看到三個月這個數字。就算讀了那份檔案,提醒要它對照的是程式碼,staging 修好了沒,程式碼裡查不到,檔案裡也沒寫條件,它不知道該問什麼。
STALE 這份研究專門量這種情況:使用者之前說每天騎車上班,Agent 記了下來;幾個月後使用者說打球摔斷了腿,沒提到騎車,再請 Agent 排通勤。測過的模型裡最好的(Gemini-3.1-pro),整體也只答對 55.2%。認得出狀況變了,也不一定會照新的做:Qwen3.5-27B 被直接問「還騎車上班嗎」能答對 76%,實際排通勤時只有 39% 用上新的狀況。
Harness 能做的,是讓帶條件的舊 memory 看起來就像需要確認的東西。Claude Code 是照天數,讀單筆檔案時附上它多舊;自己刻 Harness 可以再往前一步:寫入時存了條件,組輸入時把有條件、又超過確認期限的標成「待確認」,連原話和日期一起放進去。情境裡那筆,模型讀到的差別是這樣:
session 開始時放進去的索引(Claude Code)
  - [測試只跑 unit test](feedback_testing.md) — 改完不跑 e2e

讀那份檔案時看到的(Claude Code)
  This memory is 94 days old. Memories are point-in-time observations...
  改完程式只跑 npm test,不要跑 npm run test:e2e。

組輸入時標過的(自己刻的 Harness)
  [待確認] #3 改完只跑 unit test,不跑 e2e|條件:staging 修好之前|原話:「這陣子 staging 很不穩,e2e 先別跑」|使用者明說,6/22
模型看到「待確認」、條件和三個月前的日期,比較有機會先問一句「之前說 staging 不穩先別跑 e2e,現在修好了嗎?」。有沒有真的問,要拿同一題對跑才知道。
確認期限看種類定。project 那類記的本來就常是期限和進行中的工作,我會讓它早一點問;你的角色和專長變得慢,可以久一點。「這陣子」也不要讓模型自己換算成到期日,它沒有根據可以算。
自己刻 Harness 的話,Anthropic API 有一個 memory tool:模型發出「看這個目錄」「改這個檔的哪一段」這類請求,實際存在哪、怎麼存,由你的程式決定。它的文件建議定期刪掉很久沒被讀過的 memory 檔。這條清不掉開頭那筆,它每次跑測試都會被讀一次。
如果你這次直接講了,例如「這次連 e2e 一起跑」,就照這次的做,memory 不用拿出來比。memory 也不必跟著改,這次可能只是例外,等你說「以後都…」再改。
CI 掛了之後,你跟它說:「staging 早就修好了,以後改完都跑 e2e。」
在 Claude Code 裡,Claude 會直接改 feedback_testing.md 的內文,modified 換成今天,原本那句就不在了。文件沒提到 memory 檔會留舊版,這個目錄預設也不在任何 git repo 裡。
一個人用 Claude Code,這樣通常就夠了。做給很多使用者用的 Agent,舊的那筆有兩種處理方式。Mem0(一套給 Agent 用的記憶服務)的論文裡,新事實跟舊記憶衝突時,一般版本直接刪掉舊的;圖的版本改成把舊的關係標成失效,不實際刪除。Zep 開源的 Graphiti 也是標記:舊的那筆設上 expired_at,文章的例子是 Maria 升職,原本的「Maria 是 junior manager」被改寫成「Maria 以前是 junior manager,直到升上 senior manager」。
我會選標記。舊的那筆標成已取代、指向新的那筆,組輸入時就不會再放進去;它還留著,之後有人問「以前為什麼都不跑 e2e」答得出來,模型誤會了使用者的意思也改得回去。只有使用者明說的新說法才取代舊的,模型從「這次跑了 e2e」推測使用者改了習慣,只能存成候選。Letta 的 Context Repositories 走的是另一條路:memory 存成 git 版本,每一版都留著,多個 subagent(分出去做子任務的 Agent)各自在 worktree 裡整理,再用 git 合併。
還有一種覆蓋要擋:別人剛改過,又被拿舊的內容寫回去。auto memory 是同一個 repo 的所有 worktree 共用,你在兩個 worktree 各開一個 session,兩邊都可能去改 feedback_testing.md。Claude Code 的編輯工具有擋這件事,工具文件寫到:檔案在 Claude 讀過之後被改過,要換掉的那段文字還跟檔案現在的內容一字不差,才准改;對不上就要重讀。
我也試了整份覆寫:讓 Claude 讀完一個檔,我從外面改一行,再叫它整份寫回去,它直接收到錯誤,要它先重讀。這跟 Day 4 的 version 是同一件事,寫入時比對當初讀到的東西,變了就寫不進去。資料存在一般資料庫裡,就要自己加這個欄位。
你如果說「不要再記這個」,是另一種更新:memory 檔刪掉,之後不會再讀進來。這跟把資料刪乾淨是兩件事,那段對話的紀錄檔在被清掉之前都還在;memory 如果放進 git,GitHub 的敏感資料清理文件提醒,改寫歷史之後,clone 和 fork 裡還可能留著舊內容。「以後不會再用」和「資料已經刪掉」,產品上要分開講。
最後一件:「改完一定要跑 e2e」如果是團隊的規則,不要只放在 memory。auto memory 只在你這台機器上,同事的 Claude Code 看不到;它對模型也只是 context,照不照做沒有保證。這種規則寫進 CLAUDE.md 跟著 repo 走,再讓 e2e 沒過的 PR 合不進去。prompt 擋不住的事交給誰,Day 20 會細講。
用 Claude Code 的話,上面講的大多靠習慣:講的時候帶條件、存完看一眼、隔一陣子開 /memory 清。自己刻 Harness,或用 memory tool 自己接儲存,就要落在資料上。沿用 e2e 這筆,至少要有下面這幾欄,少了哪一欄,前面某一段就判斷不了;第三欄對照 Claude Code 有沒有。資料放在既有的資料庫就好,不用為 memory 另外搭一套。
| 欄位 | 這個情境的值 | Claude Code 裡 | 誰讀寫 |
|---|---|---|---|
| content | 改完只跑 unit test,不跑 e2e | 檔案內文 | 寫入工具存;組輸入時放進去 |
| type | feedback | 有,四種 | 決定多久要重新確認 |
| quote/source | 「這陣子 staging 很不穩,e2e 先別跑」/使用者明說 | 沒有;原本那段對話 30 天後刪掉 | 寫入工具照原話找不找得到來判斷;推測的另存候選 |
| scope | 這個 repo 的所有 e2e | 一個 repo 一份;repo 裡的範圍要寫在內文 | 寫入時記;模型判斷適不適用 |
| condition | staging 修好之前 | 沒有,要寫在內文 | 寫入時記;有條件的才會被標待確認 |
| confirmed_at | 6/22 | modified,但任何一次寫入都會更新它 |
使用者每確認一次就更新 |
| status/superseded_by | active 變成 superseded,指到新的那筆 | 沒有,直接改檔 | 更新時寫;組輸入時只放 active |
| version | 1 變成 2 | 編輯工具比對檔案目前的內容 | 更新時比對,擋掉拿舊版本寫回來的 |
組輸入和更新各一個函式。memory_lines() 在每個 session 開始時跑,決定哪幾筆放進去、要不要標待確認;supersede() 處理新說法,找不到使用者原話就只存候選,舊的標成已取代和新的寫入放在同一個 transaction。
RECONFIRM_AFTER = {"feedback": timedelta(days=30),      # 每種 memory 各自定
                   "project": timedelta(days=14)}       # 沒列的種類不標

def memory_lines(memories, now):
    lines = []
    for m in memories:
        if m.status != "active":                         # 已取代、撤回的不放
            continue
        limit = RECONFIRM_AFTER.get(m.type)
        stale = m.condition and limit and now - m.confirmed_at > limit
        tag = "待確認" if stale else "有效"
        lines.append(f"[{tag}] #{m.id} {m.content}|條件:{m.condition or '無'}"
                     f"|原話:{m.quote}|{m.source},{m.confirmed_at:%m/%d}")
    return lines

def supersede(old_id, read_version, new_content, quote, user_messages, now):
    if not any(quote in msg for msg in user_messages):   # 找不到使用者原話
        return save_candidate(old_id, new_content)       # 推測的只當候選
    with transaction():
        old = load(old_id)
        if old.version != read_version:                  # 讀了之後有人改過
            return {"status": "conflict"}                # 重讀再決定
        new = insert(type=old.type, scope=old.scope, content=new_content,
                     quote=quote, source="使用者明說", confirmed_at=now)
        update(old_id, status="superseded", superseded_by=new.id,
               version=old.version + 1)
    return {"status": "ok", "id": new.id}
| 誰呼叫 | 什麼時候 | 結果 |
|---|---|---|
Harness 組輸入的地方呼叫 memory_lines() |
新 session 開始,組第一輪輸入時 | 已取代、撤回的不放;#3 有條件又超過 30 天沒確認,標成待確認放進去 |
模型透過 memory 工具呼叫 supersede() |
你說「staging 早就修好了,以後改完都跑 e2e」 | 原話找得到:#3 標成已取代、新的寫入,版本從 1 變 2;找不到就存成候選 |
另一個 worktree 的 session 呼叫 supersede() |
同一段時間也想改這筆 | 帶著它讀到的版本 1 來寫,這時已經是 2,寫入被擋下,要重讀 |
模型不用自己帶版本號:Harness 在組輸入時記下這個 session 讀到的是第幾版,memory 工具被呼叫時由它填進 read_version。
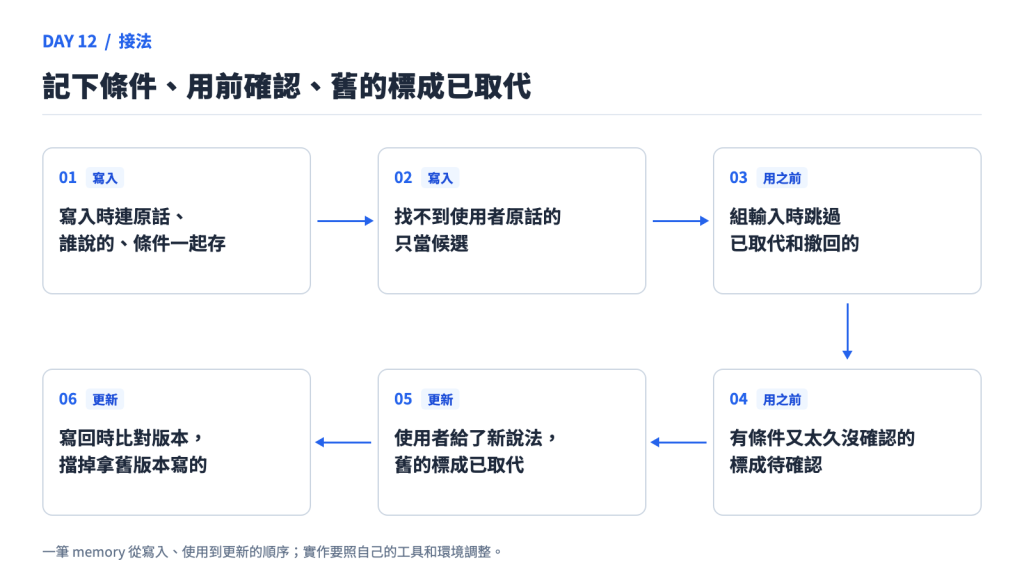
圖:寫入時連原話、誰說的、條件一起存 → 找不到使用者原話的只當候選 → 組輸入時跳過已取代和撤回的 → 有條件又太久沒確認的標成待確認 → 使用者給了新說法,舊的標成已取代 → 寫回時比對版本,擋掉拿舊版本寫的。這是示意,實作要照自己的工具和環境調整。
假設你已經做到 Day 11:同一個任務裡,摘要查得回原文。現在要讓 Agent 跨 session 記住事情,我會照這個順序加:
第一步,看得到 Agent 記了什麼、什麼時候記的。 用 Claude Code 的話這一步已經有了:看到存了 memory 的提示就打 /memory 點開看,隔一陣子把整個資料夾翻一次。自己的 Harness 就讓每筆 memory 存成看得懂的文字、帶寫入時間,使用者查得到、改得掉。
第二步,帶條件的,連條件和原話一起存,讀的時候標出來。 用 Claude Code,講的時候就把結束條件講出來,存完確認內文有寫。自己的 Harness 照上面的欄位存 condition 和 confirmed_at,組輸入時標待確認,再拿「修個 bug、沒說要跑哪些測試」這類題目,對跑有標和沒標兩個版本,看 Agent 會不會先問。標了不保證它一定會問,要量過才知道。
第三步,更新走自己的工具,比對版本。 舊的標成已取代、新的寫入,放在同一個 transaction,再比對版本。Claude Code 的編輯工具已經會比對檔案目前的內容,只是舊的不會留下來。
一定要照做的規則,不管做到哪一步,都寫進 CLAUDE.md,再用 CI 或 hook 擋,不要只放在 memory。
一個人用 Claude Code、memory 只有十幾筆的話,做到第一步、講話時記得帶條件就夠了,內建的已經記了寫入時間,讀回來也會提醒多舊。Agent 要給很多使用者用,或有好幾個 session、背景工作同時在寫,才需要第三步的版本比對和留下舊版。
多個 Agent 分工時,subagent 看不到主對話講過的話,要交代的東西怎麼帶過去,Day 13 接著看;查詢時用誰的身分、能看哪些人的資料是 Day 22 的題目;外部內容怎麼把模型帶偏是 Day 24;skill 和團隊規則怎麼經過驗證再更新,Day 30 再談。
回到 e2e 的例子,可以試著問自己:Claude Code 讀那份 memory 時,已經附上「這份 memory 94 天了」,為什麼 Agent 還是可能只跑 unit test?你說「staging 早就修好了,以後都跑 e2e」,Claude 直接把檔案改掉、舊的就沒了,這樣有問題嗎?
第一題,那段提醒要它對照的是程式碼,staging 修好了沒,程式碼裡看不到;檔案裡也沒寫「staging 修好之前」這個條件,它不知道該問什麼。session 開始時放進去的索引那一行,更是連日期都沒有。第二題看是誰在用。一個人用 Claude Code,舊的沒了通常無所謂;做給很多使用者用的 Agent,改寫之後就查不到「以前為什麼不跑、哪天改的」,模型誤會了也救不回來,標成已取代留著,兩件事都做得到。
memory 要連當時的條件一起記,用之前先看它多舊、條件還在不在,換新的時候別直接蓋掉。
明天換一個分工問題:資料和狀態都有了,多找幾個 subagent 一起做,真的會比較快嗎?我們會把派工、等待、合併和驗證的成本一起看。
查核日期:2026-09-26。Claude Code 的行為照官方文件;讀回 memory 時附上的天數提醒、整份覆寫被擋、memory 檔的欄位格式、subagent 收不收得到 MEMORY.md 索引,是我用 v2.1.280 實測的。Letta 的 Context Repositories 是 2026-02-12 介紹 Letta Code 的文章,Why Memory Isn't a Plugin 是 2026-04-03 的文章。STALE 和 BenchPreS 的數字是論文裡那批題目和模型量出來的,換成自己的任務要重新量。電商 repo、e2e 那句話和日期是情境裡編的。
CLAUDE.md 由人寫、auto memory 由 Claude 寫,兩者對模型都只是 context;叫 Claude 記住的存進 auto memory;目錄一個 git repo 一份、worktree 共用、只在這台機器;四種 type 和不存的東西;MEMORY.md 載入前 200 行或 25KB,接近上限時提醒合併或刪掉過時的,單筆檔案需要時才讀;modified 寫入時間(v2.1.214 起);文件寫不帶給 subagent;紀錄檔清理不含 memory 目錄。cleanupPeriodDays 自動刪除,預設 30 天。expired_at,不刪除;Maria 升職的例子。

 iThome鐵人賽
 看影片追技術