
📬 文件寫好只代表知識存在;要影響 Agent,還得確認它在哪個時候、以哪個版本進了模型輸入。
昨天在 Day 9,我們把大型資料留在 Context 外面,保留搜尋入口、讀取範圍和來源版本。今天接著查:入口找到了,內容有沒有進到模型輸入?
快速回顧一下:Day 5 的訊息已收下不等於已送達;Day 8 把每輪送出的 request 攤開來比。今天把這個差別放到文件上。Skill 是一份按任務載入的工作說明;檔案存在,還要有把它讀進來的機制。
假設團隊用 Claude Code 維護一個電商 repo。內部的付款 API 剛從 v1 升到 v2,差別只有一個,但很要緊:
// v1:網路 timeout 後重送,付款服務分不出是不是同一筆,可能扣兩次款
await payments.charge(order.id, order.amount)

// v2:帶同一個 idempotencyKey 重送,付款服務只會扣一次
await payments.createCharge({
  orderId: order.id,
  amount: order.amount,
  idempotencyKey: `order-${order.id}`,
})
負責的人把規則寫進 repo 根目錄的 AGENTS.md(寫給 coding agent 看的專案說明檔):
## 付款 API
- 一律用 `payments.createCharge()`,每次都要帶 `idempotencyKey`
- 不要再用 `payments.charge()`,v1 下個月下線
除了 AGENTS.md,repo 裡還有三份文件:
| 文件 | 放在哪裡 | 寫了什麼 |
|---|---|---|
| v2 遷移的 skill | .claude/skills/payments-v2/SKILL.md |
描述寫「付款 API 從 v1 升到 v2 的遷移步驟」,內文列出每個 v1 函式要換成哪個 v2 函式 |
| README | README.md 的「付款」段落 |
「v1 已停用,請改用 createCharge() 並帶 idempotencyKey」 |
CLAUDE.md |
repo 根目錄,建專案時就寫好了 | 測試跑 npm test、TypeScript 用 2 格縮排;沒提到付款 |
幾週後,有人請 Agent「結帳遇到 timeout 要自動重試」。review 時看到 src/payments/checkout.ts 多了這段:
for (let i = 0; i < 3; i++) {
  try {
    return await payments.charge(order.id, order.amount)  // 還是 v1
  } catch (e) {
    await sleep(1000)  // 等一秒再試
  }
}
用不會去重的 v1 重試三次,最壞的情況是同一筆訂單扣三次款。翻那個 session,也找不到 Agent 讀過 AGENTS.md、呼叫過那個 skill 或打開 README 的紀錄。
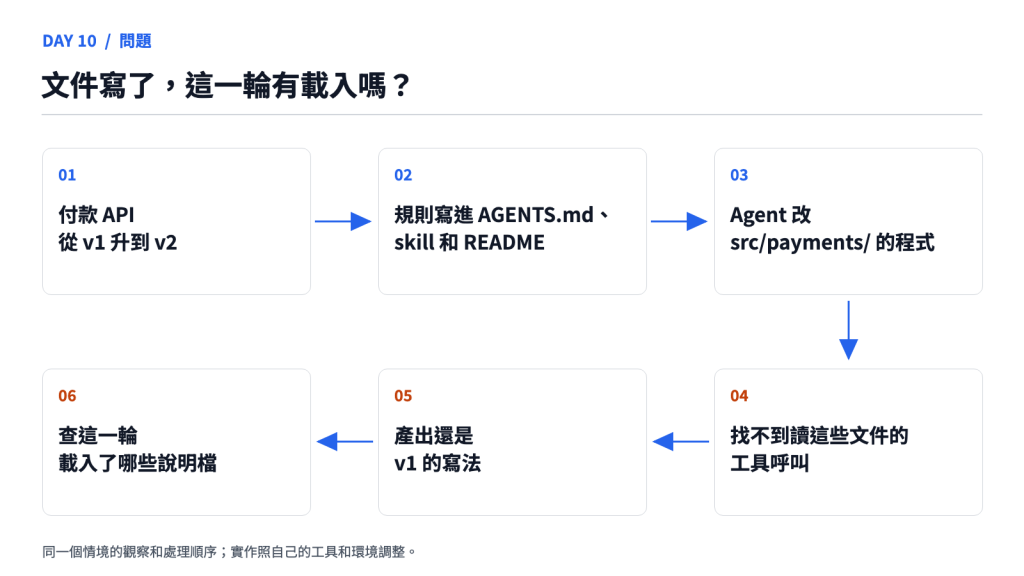
圖:付款 API 從 v1 升到 v2 → 規則寫進 AGENTS.md、skill 和 README → Agent 改 src/payments/ 的程式 → 找不到讀這些文件的工具呼叫 → 產出還是 v1 的寫法 → 查這一輪載入了哪些說明檔。這是示意,實作要照自己的工具和環境調整。
找不到工具呼叫,說明不了什麼:有些說明檔是 Harness 啟動時自己放進去的,本來就沒有讀檔這個動作。要先查到的是,寫出 v1 的那一輪,模型輸入裡到底有沒有這份規則。 有,才輪到問它為什麼沒照做。
下面先看文件有哪幾條路進到 Context、各自會在哪裡漏掉、放在 request 的哪裡才不會讓 prompt cache 失效,再用 Claude Code 查這一輪實際載入了什麼、之後還在不在、換個 Harness 或模型會差在哪,最後看自己刻的 Harness 至少要記什麼。
文件進到模型輸入有三條路,漏掉的地方各不一樣。拿 Claude Code 的說明檔當例子:
| 做法 | 什麼時候進到輸入 | Claude Code 的例子 | 會在哪裡漏掉 |
|---|---|---|---|
| 常駐 | session 一開始就放進去 | 根目錄的 CLAUDE.md |
檔案不在載入的範圍裡 |
| 按需 | 模型判斷用得上,自己去讀 | skill | 模型沒想到要讀 |
| 讀到相關程式才帶入 | Agent 讀到某個目錄的檔案時 | 子目錄的 CLAUDE.md、寫了 paths 的規則檔 |
Agent 沒讀到那個目錄 |
Anthropic 的 Agent Skills 文件 把按需這條路叫 progressive disclosure(逐步揭露):啟動時每個 skill 只把名稱和描述放進 system prompt,一個大約 100 token;模型拿任務去比對描述,符合才讀 SKILL.md;更深的參考資料要用到才讀。Cursor 的 Dynamic context discovery 也一樣,skill 的名稱和描述放在 system prompt,完整內容讓 Agent 用 grep 或語意搜尋自己找。
按需能少放無關的資料,代價是多了一次模型的判斷;這次判斷有多常沒發生,Vercel 量過。
Vercel 的評測文章 挑了一批模型訓練資料裡還沒有的 Next.js 16 API 出題,例如 'use cache'、connection()、forbidden(),看 Agent 寫出來的程式能不能通過 build、lint 和測試。他們比了幾種給文件的方式:
| 做法 | 怎麼給 | 通過率 |
|---|---|---|
| 不給文件 | — | 53% |
| skill | 把 Next.js 文件包成 skill,讓 Agent 自己決定要不要呼叫 | 53%,56% 的案例根本沒呼叫 |
| skill 加明確指示 | 在 AGENTS.md 寫「寫程式前先探索專案結構,再呼叫 nextjs-doc skill」 |
79%,觸發率升到 95% 以上 |
| 常駐索引 | 文件下載到 .next-docs/,AGENTS.md 只放一份索引 |
100% |
明確指示那一版很看措辭。改成「一定要先呼叫 skill」,Agent 會先讀文件、沒先看專案;在 'use cache' 那題,它把 page.tsx 寫對了,卻漏改了 next.config.ts。
常駐索引長這樣,每一行是一個文件目錄和底下的檔名:
[Next.js Docs Index]|root: ./.next-docs
|IMPORTANT: Prefer retrieval-led reasoning over pre-training-led reasoning
|01-app/01-getting-started:{01-installation.mdx,02-project-structure.mdx,...}
第二行要 Agent 遇到 Next.js 的問題先查文件,不要憑訓練時的記憶。索引只說文件在哪,Agent 需要時再去 .next-docs/ 讀全文。原本塞進去的內容約 40KB,壓成 8KB 的索引後通過率還是 100%。Next.js 也把這個做成一行指令 npx @next/codemod@canary agents-md,自動下載對應版本的文件、寫入索引。
這些數字限於那組 Next.js 任務和 Agent 設定。Vercel 自己的解釋是:常駐索引沒有「要不要查」這個決定點,每一輪都在,也不用決定先查文件還是先看專案;評測顯示該方案有效,沒有證明所有任務都要改成 AGENTS.md。
這個案例我最想留下的是,入口可以常駐,細節還按需讀取。放進去的 8KB 索引寫的是每份文件放在哪裡,Agent 需要時再去讀那一份,不用把整套文件塞滿 Context。
但常駐有個前提:Harness 真的會載入那個檔。開頭那份付款規則,就寫在 AGENTS.md 裡。
我會照使用頻率、長度和漏掉的後果來分。
測試入口、禁止修改的目錄、目前 framework 版本,和文件目錄,可以放在常駐的說明檔裡。這一段盡量短,Claude Code 的文件建議每個 CLAUDE.md 控制在 200 行內,寫太長不只每輪多付 token,模型照做的程度也會下降。
framework 升級、資料遷移或帶腳本的操作手冊,通常只對特定任務有用,可以留在 skill 和原始文件。description 要寫得出具體觸發條件:只寫「部署工具」太模糊,寫清楚適用哪些工作和限制比較有幫助。
但描述寫得再好,也只是提高被選中的機率。Anthropic 的 skill 撰寫指南說得很直白:Claude 是拿 description 從可能上百個 skill 裡挑出要用的那一個。Claude Code 的 skill 文件也寫到,清單裡每個 skill 的描述最多顯示 1,536 字元,超過的部分模型看不到。Vercel 那 56% 沒呼叫,就是這次挑選沒發生。
開頭那個 skill 的描述寫「遷移步驟」,使用者說的卻是「timeout 重試」,兩邊對不上,它很可能就沒被選中。Claude Code 文件教的排查方法,是在描述裡寫進使用者平常會講的字,或乾脆打 /payments-v2 直接叫它,兩種都還是要有人先想到。寫錯會出事的規則,不要只放在 skill 裡。
付款 API 的遷移規則只跟 src/payments/ 有關。放在常駐檔,改前端的時候也每輪佔著 Context;放在 skill,又要看模型會不會想到去呼叫。Claude Code 可以在 .claude/rules/ 放一個規則檔,開頭用 paths 寫上 src/payments/**,Claude 讀到符合的檔案時才載入這份規則。
要注意的是「讀到」這兩個字。我用 Claude Code v2.1.281 實測過:讓 Agent 不讀任何檔案、直接在 src/payments/ 新增一個 refund.ts,這份規則沒有載入,寫出來的程式也沒照規則。改既有的檔案比較不會漏,因為 Claude Code 編輯前要先讀過那個檔;新增檔案就可能漏,所以後面提到的 lint 還是要有。
前面講的都是「什麼時候放進來」,還有一件事同樣要緊:放在 request 的哪裡。Day 8 看過,prompt cache 是從 request 開頭逐個 token 比對,前面任何一處改了,後面整段都要重算;Agent 的輸入又遠大於輸出,一次 miss 就是整包重算。按需載入如果放錯位置,就會變成每載入一份說明檔,cache 就掉一次。
拿付款規則當例子。假設 Agent 在第 12 輪讀了 src/payments/client.ts,Harness 要把付款規則帶進來,有兩種放法:
做法 A:插回 system prompt
[tools]     read_file、edit_file、run_tests……
[system]    專案規則(CLAUDE.md)
[system]    付款規則                      ← 第 12 輪才插進來,從這裡之後全部重算
[對話]      第 1–11 輪的訊息和工具結果

做法 B:接在對話後面
[tools]     read_file、edit_file、run_tests……
[system]    專案規則(CLAUDE.md)
[對話]      第 1–11 輪的訊息和工具結果    ← 跟上一輪一樣,全部命中 cache
[tool]      src/payments/client.ts 的內容
            + 付款規則                    ← 只有這段是新算的
兩種做法模型看到的內容一樣,但 A 在第 12 輪要把前 11 輪的對話全部重算一遍,之後每多載入一份規則或一個 skill,就再重算一次。B 只多算新增的那一段,跟 Day 8 說的「歷史盡量追加」是同一回事。
這也表示,前面那張「三條路」的表,除了看會在哪裡漏掉,還要看每條路進來的時候會不會打壞 cache。
Claude Code 就是照 B 做的。它的 prompt caching 文件 把每個 request 分成三層,越少變的放越前面:
| 層 | 放什麼 | 什麼時候會變 |
|---|---|---|
| system prompt | 核心指令、工具定義 | 載入的工具定義改變時 |
| project context | 根目錄 CLAUDE.md、auto memory、沒寫 paths 的規則 |
session 開始,或 /clear、/compact 之後 |
| 對話 | 使用者訊息、模型回應、工具結果 | 每一輪 |
對照前面三條路:常駐的說明檔放在 project context,session 開始就定下來;子目錄的 CLAUDE.md 和寫了 paths 的規則,在 Claude 第一次讀到對應檔案時接進對話;skill 在呼叫當下以一則 user message 注入,文件的說法是之前的對話都不變。三條路都不動前面兩層,知識按需進來,cache 照樣接得上。這跟 Day 2 提到的 <system-reminder> 是同一個原則:要補的資訊放進下一則訊息,不回頭改開頭。
Hermes Agent 也是這樣分:skill 清單放在會被 cache 的 system prompt 裡;用到某個 skill 時,全文以一則新的 user message,或 skill_view 工具結果的形式接在後面,不改 system prompt。它的文件說,把會被 cache 的 system prompt 和每次打 API 時臨時加上的內容分開,是整個專案最重要的設計選擇之一,理由之一就是 prompt cache。
這個做法也有代價,而且會跟後面幾件事互相牽動:
接進對話的內容會一直留著。 付款規則一旦在第 12 輪接進來,之後每一輪都會跟著送。想在 Agent 離開 src/payments/ 之後把它拿掉,就得改前面的歷史,cache 從那裡開始失效。所以這類內容通常等到 compaction 才一起清掉;Claude Code 做 compaction 時,對話層本來就要重建,也會順便從磁碟重讀 project context。
工具定義放在最前面那層。 中途接上或拔掉一個 MCP server,工具定義如果是直接放在前綴裡,整段 cache 都要重算。Claude Code 在支援的模型上預設用 tool search 延後載入工具,工具清單有變動時只會追加在後面,不會動到已經快取的內容。工具怎麼按需出現,Day 15 會細講。
自己刻 Harness 的話,我會先守兩條:清單和索引這類短而穩定的內容放在前面,全文一律追加在後面。每次載入說明檔,除了記後面那張載入紀錄,也照 Day 8 的做法看那一輪的 usage:說明檔載入那一輪,如果 cache read 突然掉下來、cache write 暴增,通常就是 Harness 把它插到前面去了。
Claude Code 有兩個地方可以查。/context 的 Memory files 清單列出這個 session 載入了哪些 CLAUDE.md,文件的說法是:清單裡沒有的,Claude 就看不到。
要記得更細,可以設 InstructionsLoaded hook。先說 hook 是什麼:Claude Code 讓你在設定檔裡指定一條指令,到了某個固定時機就自動執行,例如「session 開始時」「每次執行工具之前」。InstructionsLoaded 這個時機是「有說明檔被放進模型輸入的時候」。
白話講,它像是在 Context 門口放一本簽到簿:每有一份 CLAUDE.md 或 .claude/rules/ 底下的規則檔進到 Context,就簽一次名,寫下是哪份檔案、為什麼這時候進來。它只負責記錄,不能擋下任何東西。
設定只要在 .claude/settings.json 加幾行,把 Claude Code 交給 hook 的資料一行一筆寫進 log:
{
  "hooks": {
    "InstructionsLoaded": [
      { "hooks": [{ "type": "command",
                     "command": "jq -c . >> \"$CLAUDE_PROJECT_DIR/.claude/instructions.log\"" }] }
    ]
  }
}
我在一個測試 repo 裡放了付款規則檔,讓 Claude 讀 src/payments/client.ts,log 裡實際出現兩筆(省略了 session id 這類欄位,路徑改成相對路徑):
{"file_path": "CLAUDE.md", "load_reason": "session_start"}
{"file_path": ".claude/rules/payments-v2.md", "load_reason": "path_glob_match",
 "globs": ["src/payments"], "trigger_file_path": "src/payments/client.ts"}
第一筆是 session 一開始就放進去的 CLAUDE.md。第二筆是 Agent 讀了 src/payments/client.ts,符合規則檔寫的路徑,付款規則才跟著進來;trigger_file_path 記的就是讀到的那個檔。
load_reason 有五種,對應前面講的幾條路:
load_reason |
白話 |
|---|---|
session_start |
session 一開始就放進去,例如根目錄的 CLAUDE.md |
nested_traversal |
讀到子目錄的檔案,帶入那個目錄的 CLAUDE.md |
path_glob_match |
讀到的檔案符合規則檔的 paths |
include |
被別的說明檔用 @ import 進來 |
compact |
compaction 之後重新載入 |
文件建議拿它除錯那些晚一點才載入的說明檔。後面講 compaction 和自己的 Harness 要記什麼時,都會用到這幾個欄位。
照這個情境查下去,可能碰到三種狀況,都是文件寫好了,那一輪的輸入裡卻沒有它:
清單裡找不到 AGENTS.md。 Claude Code 預設只在工作目錄和上層都沒有 CLAUDE.md 時才讀 AGENTS.md。repo 裡本來就有 CLAUDE.md 的話,要改設定讓兩個都讀,或在 CLAUDE.md 裡 import AGENTS.md。直接讀進來的 AGENTS.md 也不會觸發 InstructionsLoaded,這時要開 /memory 看它的路徑在不在清單上。
README 不在清單裡。 這很正常,README 不是說明檔,只有 Agent 自己決定去讀,它才會進來。
skill 沒被呼叫。 Claude Code 的 skill 平常只有描述在 Context 裡,模型透過 Skill 工具呼叫之後,完整內容才載入。session 裡找不到這個呼叫,內容就沒進來過,Vercel 那 56% 就是這種。
三種狀況要動的地方不一樣:改設定、把規則搬進確定會載入的檔案,或改成上一節那樣讀到 src/payments/ 才帶入。所以先查到是哪一種,再動手。
清單裡有,只代表載入的那一刻有。還有幾種情況,會讓它不在後面某一輪的輸入裡,或者在,但已經不是最新版:
讀到的不是全文。 遷移文件很長,讀檔工具只回了前面一段,Day 9 講過工具輸出的長度上限;截斷之後怎麼續讀,是 Day 16 的題目。
改程式的是 subagent。 Claude Code 的 subagent 從全新的 Context 開始,看不到主對話讀過的檔案和呼叫過的 skill,只拿到主 Agent 寫給它的任務說明。主 Agent 呼叫過 v2 的 skill、再把修改交給 subagent,那份 skill 不會跟過去。交給 subagent 時怎麼把該給的東西帶齊,Day 13 會細講。
對話做過 compaction。 Claude Code 的做法是:根目錄的 CLAUDE.md 在 compaction 之後重新從磁碟讀進來;子目錄的 CLAUDE.md 和寫了 paths 的規則檔,要等 Agent 再讀到對應的檔案才回來;呼叫過的 skill 會重新附上,但有 token 上限,呼叫得早的可能整個掉出去。InstructionsLoaded 有一種載入原因就是 compaction 之後重新載入,有記下來,就查得到哪些說明檔回來了、哪些還沒。
session 中途改了說明檔。 Claude Code 為了保住 prompt cache,根目錄的 CLAUDE.md 只在 session 開始時讀一次。中途有人把付款規則補進去,這個 session 的 cache 不會壞,但也看不到新內容,要等 /clear、/compact 或重開 session 才會載入新版。子目錄的 CLAUDE.md 和 paths 規則則看時機:還沒載入前改,之後載入的就是新版;已經接進對話之後再改,對話裡那份不會跟著變。規則明明改了、Agent 還照舊版寫,先查這一輪看到的是哪一版,這也是後面載入紀錄要記 version 的原因。
說明檔進了輸入,模型才有機會照做。Claude Code 的文件寫得很直接:CLAUDE.md 對模型來說只是 context,照不照做沒有保證,指令模糊或互相衝突時更是如此;skill 呼叫過之後好像不再有作用,內容通常還在,是模型選了別的做法。
付款 API 這種寫錯會出事的規則,要有模型外的檢查:lint 規則禁止出現 payments.charge(、測試檢查每次呼叫都帶了 idempotencyKey。想在 Agent 動手前就擋,文件建議用 PreToolUse hook,這是工具執行前先跑的檢查,可以直接擋下。prompt 擋不住的事要交給誰,Day 20 會細講。
說明檔不是寫一次就到處通用。先看 Harness:同一份 AGENTS.md,Codex 會從 repo 根目錄一路讀到工作目錄,合計超過 32 KiB 就不再加入;Claude Code 前面看過,repo 有 CLAUDE.md 時預設不讀它。同一個檔案,換個工具,進不進得來、進來多少都不同。
再看模型。Anthropic 的 prompting 文件提到,Claude Opus 4.5 和 4.6 對 system prompt 比之前的模型更敏感:原本為了防止模型不用工具或 skill 而寫的「CRITICAL: You MUST use this tool when...」,在新模型上反而可能讓它用過頭,建議改回一般語氣的「Use this tool when...」。
OpenAI 的 GPT-5 prompting 指南也說,GPT-5 照指令做得很精準,所以互相矛盾或模糊的指令對它傷害更大;Cursor 發現,舊模型需要的「盡量多蒐集 context」,在小任務上會讓 GPT-5 一直重複搜尋。Anthropic 的 skill 撰寫指南也提醒,skill 有沒有效要看底下的模型,對 Opus 剛好的內容,換成 Haiku 可能不夠詳細,每個會用到的模型都要測過。
幾份資料的方向一致:模型越強,要寫的越少。Anthropic 的 Context engineering 文章寫到,模型越聰明,需要的規定越少;長任務 Harness 那篇的作者換上 Opus 4.5 後,拿掉了 context reset,也就是把對話整個清空、換一個新的 Agent 照交接內容接著做;換上 Opus 4.6 後,又拿掉了把工作切成 sprint、照規格一次只做一個功能的設計。作者建議新模型出來時重新檢查 Harness,拿掉已經不承重的部分。
ETH Zurich 的論文則直接測了 AGENTS.md:跨多種模型和 coding agent,加上說明檔平均沒有提高成功率,推論成本卻多了二成以上。裡面的指令模型大多照做,專案概覽則沒幫上忙。作者的結論是:說明檔適合寫不照慣例的做法,要加東西前先實測。這跟 Vercel 的結果並不衝突:Vercel 測的是訓練資料裡沒有的 Next.js 16 新 API,正好就是模型自己猜不到的東西。
放回付款的例子:「一律用 v2、每次帶 idempotencyKey」是公司內部的規則,模型再強也猜不到,一定要寫;「TypeScript 用 2 格縮排」這種看現有程式就知道的,交給 formatter 就好。換模型或換 Harness 之後,用 /context 或載入紀錄再確認一次說明檔有沒有進來,也順便看看哪些規則已經不用寫了。
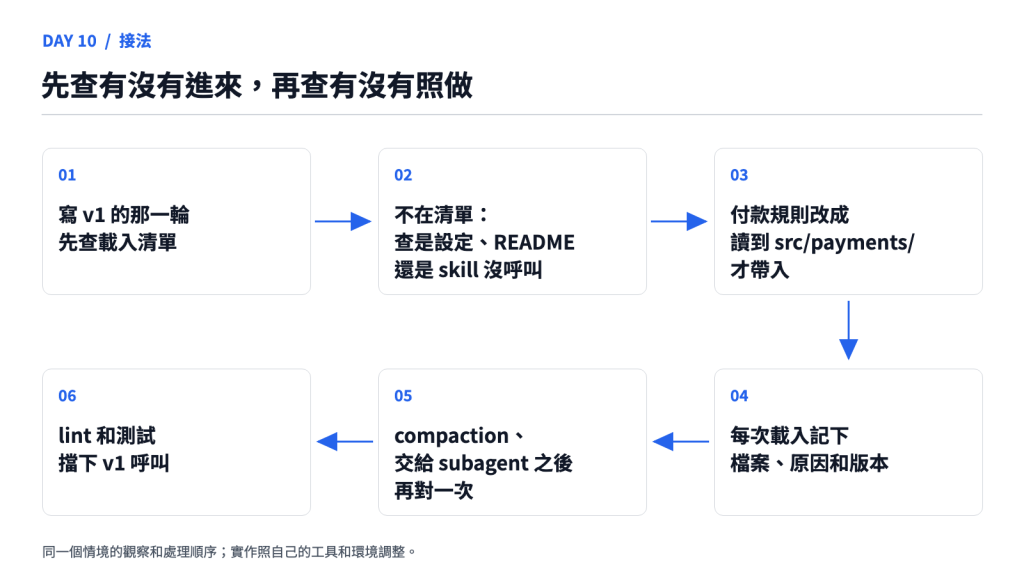
圖:寫 v1 的那一輪先查載入清單 → 不在清單就查是設定、README 還是 skill 沒呼叫 → 付款規則改成讀到 src/payments/ 才帶入 → 每次載入記下檔案、原因和版本 → compaction 和交給 subagent 之後再對一次 → lint 和測試擋下 v1 呼叫。這是示意,實作要照自己的工具和環境調整。
用 Claude Code 可以直接開 /context、設 hook;自己刻 loop 的話要自己記。像 Day 8 那樣把 request 攤開,看得到這輪送了什麼,但說明檔混在一大段輸入裡,事後分不出哪一段來自哪個檔、哪一版、為什麼在這裡。這跟 Day 5 的「收下不等於送達」是同一件事:文件在 repo 裡算收下,進了那一輪的輸入才算送達。
模型自己呼叫 skill、讀 README,本來就是一次 tool call,紀錄裡已經有。要另外記的是 Harness 自己放進去、沒有對應 tool call 的那些。我會照 InstructionsLoaded 的欄位,每放一份說明檔就記一筆:
| 欄位 | 情境裡的值 | 誰讀、拿來做什麼 |
|---|---|---|
path |
rules/payments-v2.md |
除錯的人查遷移規則有沒有進來 |
reason |
路徑符合規則 | 分辨是啟動就在、讀到檔案才進來,還是 compaction 後重新載入 |
trigger |
src/payments/client.ts |
Agent 讀了哪個檔案,才把規則帶進來 |
turn |
第 12 輪 | 對照產出 v1 呼叫的那一輪 |
version |
規則檔內容的 hash | 確認進來的是改過之後那版 |
前三欄對應 InstructionsLoaded 的檔案路徑、載入原因和觸發檔案。turn 和 version 是我加的,那個 hook 沒有:少了 turn 對不上是哪一輪,少了 version 分不出看到的是哪一版規則。
def attach_instructions(run_id, turn, reason, paths, trigger=None):
    blocks = []
    for path in paths:
        text = read_file(path)
        load_log.append(run_id=run_id, turn=turn, path=path, reason=reason,
                        trigger=trigger, version=sha256(text))
        blocks.append(text)
    return blocks  # 放進這一輪要送出的訊息

def instructions_in_context(run_id, turn):
    # compaction 之前載入的已經不在輸入裡,從最近一次 compaction 算起
    since = last_compaction_turn(run_id, before=turn)  # 沒做過就是 0
    return load_log.query(run_id=run_id, from_turn=since, until_turn=turn)
| 誰呼叫 | 什麼時候 | 結果 |
|---|---|---|
| Harness 啟動 | session 開始 | attach_instructions 放入根目錄的說明檔,reason 記啟動 |
| 讀檔工具的 executor | Agent 讀了 src/payments/client.ts,符合規則的路徑 |
放入付款規則,reason 記路徑符合、trigger 記這個檔;規則文字接在這次的工具結果後面,同一則訊息送出(Day 5 講過的位置) |
| compaction | 摘要做完之後 | 重新放入根目錄的說明檔,reason 記 compaction;付款規則照 Claude Code 的做法,等 Agent 再讀到那個目錄才回來 |
| 除錯的人 | review 發現 v1 呼叫 | 用 instructions_in_context 查那一輪:規則不在,查為什麼沒載入;在,再查 lint 為什麼沒擋 |
假設你已經做到 Day 9:文件有可搜尋的入口,讀取結果也帶版本和來源。下一步照這個順序加:
第一步,看得到這一輪載入了哪些說明檔。 用 Claude Code 就開 /context;自己的 loop 就在 Harness 放說明檔的地方記一筆,照上面那張表。做完這一步,「沒載入」和「載入了沒照做」才分得開。
第二步,只跟某塊程式有關的規則,改成讀到那裡才帶入。 Claude Code 用子目錄的 CLAUDE.md 或寫了 paths 的規則檔;自己的 loop 就在讀檔工具裡比對路徑。用的框架沒有這種機制,至少在常駐檔放一行短索引,照 Vercel 的做法指到完整文件。
第三步,寫錯會出事的規則,加一道模型外的檢查。 例如用 lint 抓 v1 的呼叫。
規則只有幾條、全放在一個常駐檔裡的話,做到第一步、確認它真的有載入就夠了。說明檔一多、開始分路徑或用 skill,才需要第二步和完整的載入紀錄。Day 11 看 compaction 之後這些內容還在不在,Day 13 看交給 subagent 時怎麼送達,Day 16 接截斷之後怎麼續讀,Day 20 講哪些限制要由模型外執行。
回到付款 API 的例子,可以試著問自己:session 裡找不到讀 AGENTS.md 的工具呼叫,能說 Agent 沒看過它嗎?寫 v1 的那一輪之前,紀錄裡有付款規則的載入,只是中間做過一次 compaction,能說規則還在嗎?
第一題不能,常駐的說明檔是 Harness 啟動時放進去的,本來就沒有工具呼叫,要看 /context、/memory 或載入紀錄。第二題也不能,路徑規則在 compaction 之後要等 Agent 再讀到那個目錄才回來,要看 compaction 之後有沒有再載入一次。
文件寫好了,還要查得到它在哪一輪、哪一版、因為什麼進了模型輸入。 查到它在,才輪到問模型有沒有照做,那一段交給 lint 和測試。
今天確認的是內容有沒有送到。明天再看對話變長之後,這些資訊能不能被正確保留下來:摘要把原本的結論寫反了,要怎麼查回當時的紀錄?
查核日期 2026-09-24,產品行為照官方文件和工程文章。Vercel 的數字來自它自己的 Next.js 16 評測。付款 API、v1/v2、檔名和輪數是情境裡編的。
paths 符合、compaction 之後);每個檔案建議 200 行內;有 CLAUDE.md 時預設不讀 AGENTS.md;用 /context、/memory 查清單;說明檔對模型只是 context,照做沒有保證。SKILL.md 觸發才讀、參考資料和腳本用到才讀),腳本只有執行結果進 Context,description 要寫做什麼和什麼時候用。CLAUDE.md 和 paths 規則讀到才接進對話,都不影響快取;中途修改根目錄 CLAUDE.md 不會生效;MCP 工具變動和 compaction 對快取的影響。InstructionsLoaded 在說明檔載入時觸發,帶檔案路徑、五種載入原因和觸發檔案,只能記錄、不能擋;直接讀 AGENTS.md 時不觸發。AGENTS.md,合計上限 project_doc_max_bytes 預設 32 KiB。

 iThome鐵人賽
 看影片追技術