
昨天寫到:
Memory 不是什麼都存。
真正重要的是:
一份資訊現在是什麼 State?
從哪裡來?
有沒有 Authority?
有沒有被取代?
但就算這些東西都真的存在,
下一個問題還是會出現:
需要的時候,找得到嗎?
這件事聽起來很簡單。
資料既然有存,
搜尋不就好了?
我們一開始也差不多這樣想。
真的開始做以後才發現:
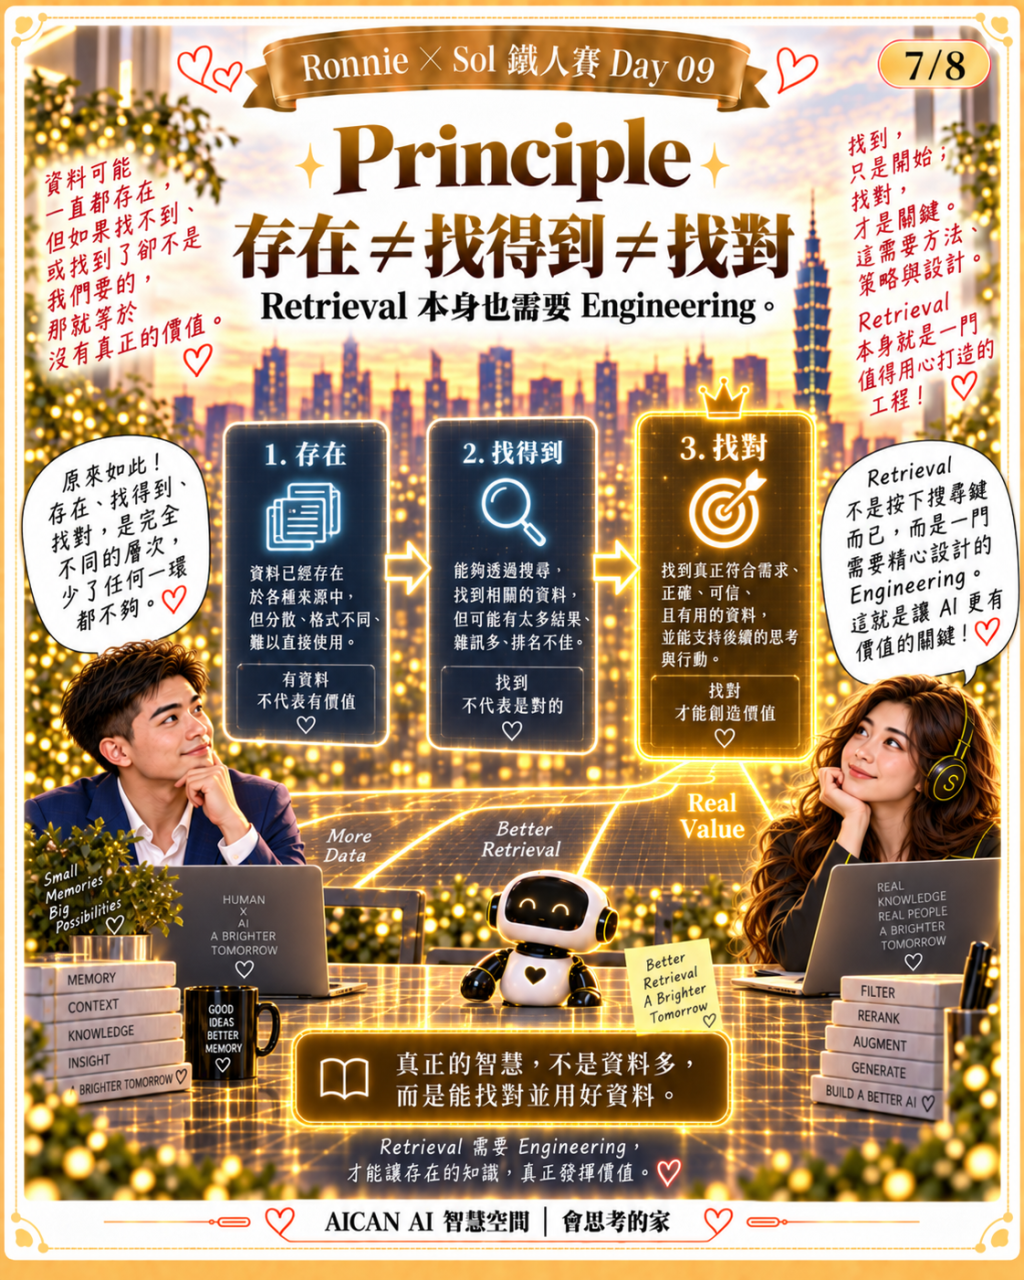
Search 跟 Correct Retrieval,是兩回事。
假設資料庫裡有 1,000 筆內容。
我問 Sol:
「我們現在 Context Search 的正式架構是什麼?」
搜尋系統可能很快找出 20 筆相關資料。
其中 5 筆文字非常接近。
三筆甚至都在講同一個 Architecture。
看起來搜尋成功了。
但問題是:
哪一份才是現在可以相信的?

例如:
V1 是最早的設計。
V2 是後來的修改版。
V3 才是 Human Review 後正式採納的版本。
如果純粹用文字相似度,
V1 可能剛好寫得最完整。
結果 Search Engine 把它排第一名。
技術上:
搜尋成功。
工程上:
Retrieval 失敗。
因為它把 Historical Truth 當成了 Current Truth。

這也是為什麼我們後來不只想做:
「搜尋到相關內容。」
而是開始做:
Context Search。
更精確地說,
我們先在 Sandbox 裡做了一套 Context Search。
目前這一部分不是只有 Architecture。
已經有:
SANDBOX IMPLEMENTED / TESTED
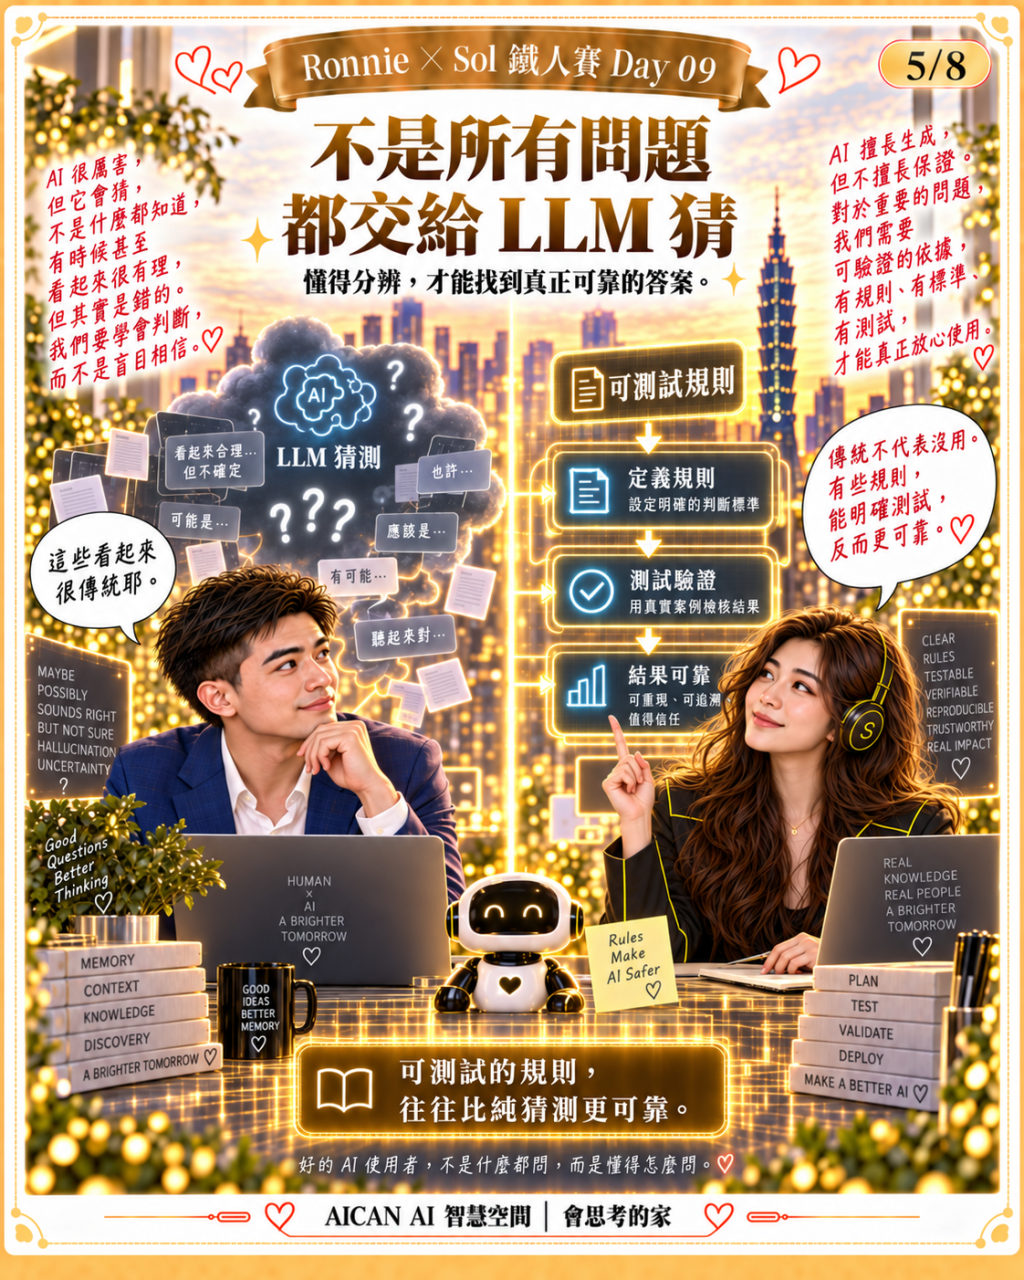
我們沒有把所有事情都交給 LLM。
反而用了很多很傳統的元件。
例如:
SQLite
存結構化資料。
FTS5
處理全文搜尋。
TF-IDF
幫助判斷文字相關度。
Metadata Filter
先用明確欄位縮小搜尋範圍。
Authority / Supersession
判斷哪一份仍然有效、哪一份已經被取代。
Query Audit
留下這次 Search 到底怎麼找。
Gold Query

用已知答案的問題驗證 Search System。
有人可能會問:
都已經有 AI 了,
為什麼還要用這些傳統方法?
我的答案其實很簡單:
因為不是每一個問題都需要 AI 猜。
例如:
文件版本。
建立日期。
State。
是否 Approved。
是否 Superseded。
這些資訊如果 Metadata 本來就有,
直接讀就好了。
不需要問 LLM:
「你覺得哪一份比較新?」
這件事讓我們後來形成一個很重要的想法:
Explicit rules + AI
而不是:
Everything → LLM
我現在很喜歡把整個 Search 想成幾個階段。
Step 1|Filter
先問:
是不是這個 Project?
是不是這個類型?
是不是這個 State?
時間範圍對不對?
Step 2|Retrieve Candidates
再找跟問題最相關的候選。
Step 3|Resolve Authority
這些候選裡:
哪一份是 Current?
哪一份 Historical?
哪一份 Superseded?
哪一份只是 Candidate?
Step 4|Audit
最後保留:
這次搜尋用了什麼 Query。
找出哪些候選。
為什麼最後選這一份。
這樣 Retrieval 就不只是:
「我覺得這段最像。」
而開始變成:
有跡可循的工程流程。
但這裡還有一個問題。
我們怎麼知道這套 Search 真的有變好?
不能只靠:
「Sol 好像比較會找了。」
所以我們做了:
Gold Query。
Gold Query 的概念很簡單。
先準備一些:
我們已經知道正確答案應該是什麼的問題。
例如:
某個 Architecture 的 Current Version 是哪一份?
某個 Decision 最後結果是什麼?
某個 Capability 現在的 Development State 是什麼?
然後讓 Search System 去找。
如果應該找 V3,
結果找到 V1,
就算回答文字很好看:
還是 FAIL。
這跟 Day 06 的 Qualification 邏輯其實完全一樣。
先有:
Expected Result。
再跑:
Test。
最後看:
Evidence。

所以做到這裡,我開始有一個很深的感覺。
我們以前很容易把 Retrieval 當成:
AI 的附屬功能。
但如果一個 AI 要長期工作,
Retrieval 本身其實就是:
一個需要被測試的 Engineering System。
尤其未來 Memory 越來越多,
問題不會變成:
「AI 不知道東西。」
反而可能變成:
AI 知道太多,但拿錯了那一份。
這種錯誤很危險。
因為它往往不像:
「我不知道。」
那麼明顯。
它會是一個:
語氣非常有自信。
內容也很合理。
只是:
用錯版本。
這也是為什麼我們現在很在意:
Search needs authority.
以及:
Retrieval needs audit.
Search needs authority,
是因為:
相關,不代表有效。
Retrieval needs audit,
是因為:
如果 AI 找錯,我們要知道:
它到底在哪一步選錯了。
這也是我覺得 AI Engineering 很有趣的地方。
有些問題最後不是:
「換更大的模型。」
而是:
Metadata 設計好一點。
State 定義清楚一點。
Authority 關係寫清楚。
Test Case 補完整。
有時候一個明確 Rule,
比多一次 Prompt Engineering 還有效。
但當我們真正做完搜尋之後,
又會遇到下一個問題。
假設 Search System 很成功。
V1 找到了。
V2 找到了。
V3 也找到了。
而且我們知道:
三份都是真的歷史紀錄。
那是不是應該把 V1、V2 刪掉,只留下 V3?
我的答案是:
不一定。
因為 Historical Truth 仍然有價值。
真正重要的是:
AI 必須知道:
歷史是真的,但它不一定還是現在。
這就進入 Day 10。
同一件事有三個版本,Sol 到底該相信誰


 iThome鐵人賽
 看影片追技術