
昨天寫了第一則告警,門檻是「300 毫秒內完成的比例 < 95%,撐 10 分鐘」。今天要拆掉這個設計,因為它有問題,而且問題不小。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=false LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
今天主要在寫規則和算數字,故障留到明天一起觸發。
SLI < 95% 持續 10 分鐘就叫人,聽起來很合理。實際上它會在兩個方向出錯。
情境一:某分鐘掉到 94.5%,撐了 11 分鐘後自己好了。 告警響了,你起床,發現一切正常。誤報。
情境二:SLI 穩定停在 95.5%,持續三天。 告警從來沒響,因為 95.5% > 95%。但這三天已經燒掉整個月的錯誤預算了。漏報。
問題出在同一個地方:這個告警看的是「瞬間的比例」,但 SLO 講的是「一整個週期的累積」。 兩者根本不是同一件事。
要修好它,得回到 Day 2 那個訂了之後一直沒用的概念。
Day 2 講過:延遲 SLO 訂 95%,就代表允許 5% 的請求超過 300 毫秒,這 5% 叫錯誤預算。用 30 天算,5% 是 36 小時。
重點在「把穩定性變成一種可以花的資源」。既然是預算,那真正該關心的就不是「現在的數字是多少」,而是我花錢的速度,會不會讓我在月底之前就用光。
burn rate(燃燒率)= 實際壞掉的比例 ÷ 預算允許的比例。
| burn rate | 意思 | 預算撐多久 |
|---|---|---|
| 1 | 剛好照計畫花 | 剛好 30 天 |
| 2 | 兩倍速 | 15 天 |
| 6 | 六倍速 | 5 天 |
| 14.4 | 很快 | 約 50 小時 |
換成 PromQL 就是「實際壞掉的比例除以 0.05」:
(1 - (
  sum(rate(http_request_duration_seconds_bucket{job="gateway",path="/checkout",le="0.3"}[1h]))
  / sum(rate(http_request_duration_seconds_count{job="gateway",path="/checkout"}[1h]))
)) / 0.05
括號裡是昨天那條 SLI,1 - 之後變成「壞掉的比例」,再除以預算 0.05。
這個數字的好處是它自己會講話。burn rate 等於 14.4 的意思是「照這個速度,兩天後預算就沒了」,這比「有 72% 的請求超過 300 毫秒」直觀得多,也直接回答了昨天的條件一:該不該現在起床。
Google 的 SRE Workbook 提出一組實用的設定,叫 multi-window multi-burn-rate。想法是:燒得愈快愈早叫,燒得慢就不要吵人。
| 燒掉的預算 | 長視窗 | 短視窗 | burn rate | 動作 |
|---|---|---|---|---|
| 2% | 1 小時 | 5 分鐘 | 14.4 | 叫醒人 |
| 5% | 6 小時 | 30 分鐘 | 6 | 叫醒人 |
| 10% | 3 天 | 6 小時 | 1 | 開工單 |
這三組數字不是隨便挑的,它們互相有關係。以第一列為例:一小時用掉 30 天預算的 2%,換算就是 0.02 × 720 小時 ÷ 1 小時 = 14.4 倍速。另外兩列同樣算得出來。短視窗一律是長視窗的十二分之一。
三條規則同時存在,快速的災難由第一條抓,緩慢的失血由第三條抓。
每條規則要兩個時間窗,長的判斷嚴重性,短的確認現在還在燒。少了短視窗會怎樣?
假設 14:00 出了一次大事故,14:10 修好了。但一小時的視窗會記得這件事直到 15:00——告警會在問題已經解決之後繼續響 50 分鐘。
加上短視窗之後,問題一解決,五分鐘的視窗馬上恢復正常,and 就不成立,告警跟著解除。這叫快速恢復,是這個設計最精巧的地方,也是很多教學會漏掉的部分。
完整的規則長這樣:
- alert: CheckoutLatencyBudgetBurnFast
  expr: |
    (1 - ( ...[1h] )) / 0.05 > 14.4
    and
    (1 - ( ...[5m] )) / 0.05 > 14.4
  for: 2m
  labels:
    severity: page
    team: checkout
  annotations:
    summary: "延遲錯誤預算以 {{ $value | printf \"%.1f\" }} 倍速燃燒,約 50 小時用完本月預算"
注意那句 summary。它不是「有 72% 的請求超過 300 毫秒」,而是「50 小時後預算會用完」。收到通知的人立刻知道嚴不嚴重——這就是昨天講的上下文。
寫完規則我做了一件事:把故障二開著那幾天的資料撈出來,算算看 burn rate 是多少。
Prometheus 還留著 Day 20 那段——故障二開著的時候,延遲 SLI 掉到 0.77 左右。代入公式:
(1 - 0.77) / 0.05 = 4.6
實際查歷史資料,那段時間的一小時 burn rate 是 4.21。
4.21 倍速是什麼概念?預算是一個月份的,用 4.21 倍的速度花:
30 天 ÷ 4.21 ≈ 7 天
照這個速度燒,七天後預算會用完。 對照上面那張表:14.4 和 6 倍速才叫醒人,1 倍速是開工單。4.21 落在 1 和 6 之間,比較靠近工單那一端。
然後我發現一件尷尬的事。昨天我把故障二貼的標籤是 severity: page,理由是「它直接違反延遲 SLO」。但今天算出來,它其實是 ticket 等級的。
兩個判斷不一樣,我認為 burn rate 那個是對的。差別在於:
| 「違反 SLO」 | 「burn rate 4.21」 | |
|---|---|---|
| 是什麼 | 是非題 | 有單位的數字 |
| 告訴你 | 有沒有超標 | 還剩多少時間 |
| 能不能分級 | 不能,超標就是超標 | 能,4.21 和 14.4 差三倍 |
昨天那條規則會在 SLI 掉到 94.9% 和掉到 40% 的時候發出一模一樣的通知,而這兩件事的急迫性差了幾十倍。把所有違反都當成一樣嚴重,收到通知的人就沒辦法決定要不要現在處理,久了就變成昨天講的抗體。
(順帶一提,現在故障全關,同一條查詢的 burn rate 是 0.00。)
最後處理 Day 6 的第三個故障,記憶體洩漏。它有一個尷尬的性質:它現在完全沒有症狀。 使用者沒受影響、SLI 是滿分、錯誤預算一毛都沒花。
但昨天才說「對症狀告警,不要對原因告警」。那這個該不該告警?
該。而且這是那條原則的例外,值得說清楚為什麼。
原則的完整版是「對症狀告警,除非你能可靠地預測某個原因即將造成症狀」。記憶體洩漏就是這種:它會 OOM、會重啟、重啟時進行中的請求會失敗。這是可預測的因果,不是猜的。
而且時機很重要——在它造成症狀之前處理,比事後處理便宜太多。
為什麼不能用固定門檻:
| 設法 | 問題 |
|---|---|
memory > 90% |
OOM 前十分鐘才叫,來不及 |
memory > 70% |
正常運作也會到,每天都在叫 |
| 任何固定值 | 重啟後歸零,告警自動解除,隔天再犯 |
最後一項最麻煩。這是一個會自己好的告警,而會自己好的告警沒有人會認真追——每次你去看都已經正常了。
解法是看趨勢不看瞬時值。Prometheus 有一個函式 predict_linear,拿一段時間的資料做線性回歸,預測未來某個時間點的值:
predict_linear(container_memory_working_set_bytes{namespace="default"}[1h], 4 * 3600)
  > on(namespace, pod, container)
kube_pod_container_resource_limits{namespace="default", resource="memory"}
翻譯:照過去一小時的趨勢,四小時後會不會超過記憶體上限? 會的話現在就告警,你有四小時可以從容處理。
這裡有一個坑。大部分教學寫的是拿 container_spec_memory_limit_bytes 當上限,但我查出來是空的——kind 上的 cAdvisor 沒有輸出這個指標。要改用 kube-state-metrics 的 kube_pod_container_resource_limits,而且因為兩邊的標籤集不一樣,要加 on(namespace, pod, container) 指定比對哪幾個標籤。這跟 Day 12 那條 node_load1 要加 on(instance) 是同一件事。
predict_linear 用在磁碟空間預測是 Prometheus 官方文件的經典例子,記憶體是同一個道理:它們都是「單調上升、有硬上限」的資源。
這則告警的分級是 ticket 不是 page——四小時的緩衝代表可以等到上班時間。這正好示範了「可行動」的完整意義:不只是「有事可做」,還包括什麼時候做。
現在 k8s/alerts.yaml 裡有五條規則,分成兩類:
| 看什麼 | 分級 | 抓什麼 | |
|---|---|---|---|
| burn rate | 症狀(SLI) | page / ticket | 已經在影響使用者的事 |
predict_linear |
原因(資源) | ticket | 還沒影響、但即將影響的事 |
第一種是主力,第二種是少數例外。判斷一個「原因告警」該不該存在的標準:你能不能寫出一句「照這個趨勢,X 時間後會發生 Y」? 寫不出來就不該告警,該畫成圖。
kubectl apply -f k8s/alerts.yaml
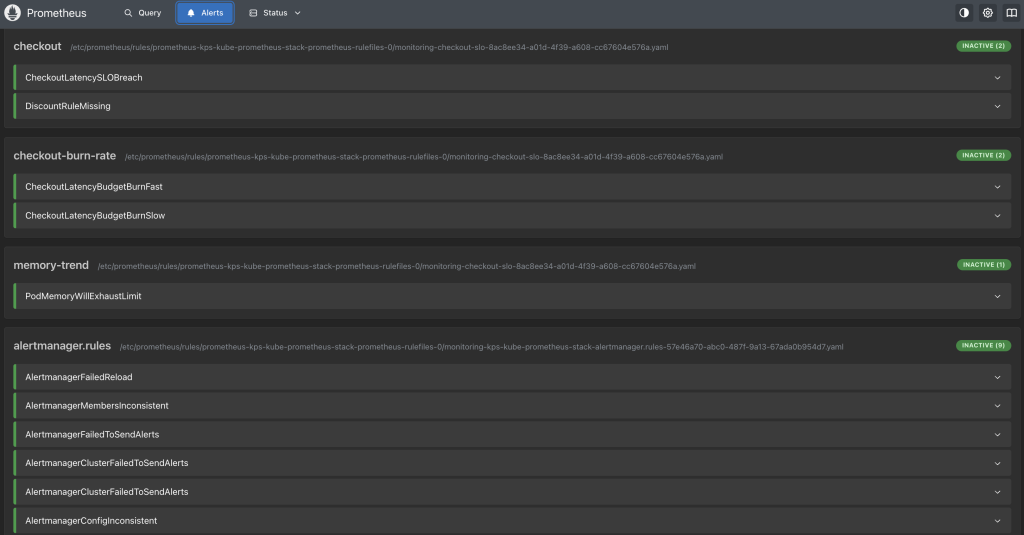
三個群組、五條規則,右上角 INACTIVE (2) / (2) / (1)——條件都不成立,因為故障全關著。
兩個細節值得看一眼。一是三個群組的檔案路徑是同一個 monitoring-checkout-slo-....yaml,那是 Operator 把我寫的 k8s/alerts.yaml 轉成的,檔名前面接了 namespace 和資源名稱。二是往下捲就是 alertmanager.rules,chart 內建的那批——我的五條是混在那 132 條裡面的,沒有「我的規則」和「別人的規則」之分,Prometheus 眼中它們完全平等。這也是為什麼昨天要先把誤報關掉:不然新加的東西根本找不到。
昨天那條 CheckoutLatencySLOBreach 我先留著,明天要拿它跟 burn rate 的版本做對照——看同一個故障,哪一條先響、哪一條講得比較清楚。
明天是告警區塊最後一天,講一件我確定會發生的事:這些告警第一次上線一定會誤報,以及誤報之後該怎麼檢討。


 iThome鐵人賽
 看影片追技術