

昨天那隻 agent 跑起來了。今天把它當成第四個會壞的服務。
一般的服務出錯有明確的訊號:狀態碼 500、例外堆疊、超時。agent 不是這樣,它出錯的樣子是——回應了,格式正確,內容是錯的。
眼熟嗎?這就是 Day 6 的故障一:算錯但回 200。狀態碼正常、延遲正常、沒有例外,但答案不對。agent 的預設狀態就是這種故障。
而且它比一般服務多三個麻煩:
| 一般服務 | agent | |
|---|---|---|
| 成本 | 跟請求數大致線性 | 每輪都重送整段對話,疊得很快 |
| 延遲 | 毫秒級 | 秒級,而且變動大 |
| 正確性 | 有明確的對錯 | 要另外定義怎麼算對 |
| 重現性 | 同輸入同輸出 | 同輸入可能不同輸出 |
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=true    # 故障一
kubectl set env deploy/catalog BUG_N_PLUS_ONE=true         # 故障二
kubectl set env deploy/pricing LEAK_KB_PER_REQUEST=8       # 故障三
# 以及全部關閉的對照組
今天是唯一一天三個故障輪流開一次,因為它們是評測的標準答案。
Day 17 講過 Semantic Conventions(語意慣例)——一份約定,規定某件事的欄位該叫什麼。照著命名,工具才預先知道要找什麼。
OTel 有一份專門給 GenAI 的。我查的時候發現兩件事。
第一,它搬家了:原本在 opentelemetry.io/docs/specs/semconv/gen-ai/ 的內容移到獨立的 semantic-conventions-genai 儲存庫,舊網址只剩一句「已移動」。
第二,屬性改名了。我原本記得的 gen_ai.system,現在叫 gen_ai.provider.name。整份規格目前每一個欄位的穩定度都標著 Development。
gen_ai.operation.name      這次操作是什麼:chat / execute_tool / invoke_agent
gen_ai.provider.name       哪一家的服務
gen_ai.request.model       請求時指定的模型
gen_ai.response.model      實際回應的模型
gen_ai.usage.input_tokens  輸入用了幾個 token
gen_ai.usage.output_tokens 輸出用了幾個 token
gen_ai.response.finish_reasons  它為什麼停下來
span 的名字也有規定:{操作} {模型},所以我的是 chat gemini-3.1-flash-lite。
gen_ai.provider.name 該填什麼也有規定,而且分得很細:
| 值 | 什麼時候用 |
|---|---|
gcp.gemini |
走 generativelanguage.googleapis.com,也就是 AI Studio 的 API |
gcp.vertex_ai |
走 aiplatform.googleapis.com |
gcp.gen_ai |
不確定是哪個後端的時候 |
我用的是 AI Studio 的金鑰,所以填 gcp.gemini。
照規格填而不是自己取名,圖表工具才認得出這是 LLM 呼叫。 但這份規格還在動,所以要寫明查證日期——這不是免責聲明,是讓半年後看到這篇的人知道該去對一次。
指標的名字也跟我想的不一樣。我本來以為會是一個 tokens_total 配一個 token_type 標籤,實際不是:
| 慣例規定的名字 | |
|---|---|
| 輸入 token | gen_ai.client.inference.usage.input_tokens(Counter) |
| 輸出 token | gen_ai.client.inference.usage.output_tokens(Counter) |
| 呼叫耗時 | gen_ai.client.operation.duration(Histogram,單位秒) |
是兩個獨立的 counter,不是一個 counter 配標籤。
Histogram 的桶規格也直接給了:0.01, 0.02, 0.04 ... 40.96, 81.92。跟 HTTP 請求那組(0.005 到 10 秒)差很遠,因為模型呼叫動輒好幾秒,用預設桶會全部擠進最後一個。這跟 Day 12 講「桶要圍繞你關心的門檻設」是同一件事,只是這次門檻大了兩個數量級。
一次執行是一棵樹:最外層 invoke_agent,每輪模型呼叫一個 chat,每次工具一個 execute_tool。
with tracer.start_as_current_span(f"chat {MODEL}") as span:
    span.set_attribute("gen_ai.operation.name", "chat")
    span.set_attribute("gen_ai.provider.name", "gcp.gemini")
    span.set_attribute("gen_ai.request.model", MODEL)

    started = time.monotonic()
    resp = client.models.generate_content(model=MODEL, contents=contents, config=config)
    elapsed = time.monotonic() - started

    used = resp.usage_metadata
    tin, tout = used.prompt_token_count or 0, used.candidates_token_count or 0
    labels = {
        "gen_ai.operation.name": "chat",
        "gen_ai.provider.name": "gcp.gemini",
        "gen_ai.request.model": MODEL,
        "gen_ai.token.modality": "text",
    }
    telemetry.input_tokens.add(tin, labels)
    telemetry.output_tokens.add(tout, labels)
    telemetry.operation_duration.record(elapsed, ...)

    span.set_attribute("gen_ai.usage.input_tokens", tin)
    span.set_attribute("gen_ai.usage.output_tokens", tout)
指標的標籤跟 span 的屬性放的東西不一樣,這是 Day 13 和 Day 19 兩條規則同時派上用場的地方:
所以工具的 span 我把查詢字串整個塞進去,指標那邊一個字都不放。
agent 跑在我自己電腦上,資料要送進叢集的 Collector。Day 18 就記過一筆:kubectl port-forward 打不進 Collector,因為 chart 預設把接收埠綁在 Pod 自己的 IP 上。當時我繞過去了,叢集內的服務走 Service 不受影響。
這次繞不掉,得真的改:
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
指標那邊還有第二個問題。Collector 預設的 metrics pipeline 只接到 debug exporter,等於收了就丟掉。要加 prometheus exporter 把它換成 Prometheus 抓得動的格式,再配一個 ServiceMonitor 去抓。
改完 Collector 直接 CrashLoopBackOff:
'exporters' unknown type: "prometheus" for id: "prometheus"
(valid values: [otlp otlp_http otlphttp file load_balancing loadbalancing otelarrow debug nop otlp_grpc])
otel/opentelemetry-collector-k8s 這個映像檔是精簡版,沒有 prometheus exporter。換成 otel/opentelemetry-collector-contrib 才有。錯誤訊息把可用的值列出來了,這種報錯算很客氣。
指標進 Prometheus 之後標籤長這樣:
gen_ai_client_inference_usage_input_tokens_total{
  exported_job="alert-agent", job="otel-collector", ...
}
exported_job 又出現了。Prometheus 抓 Collector 的時候加上自己的 job,agent 原本帶的那個被擠去加前綴——Day 13 那個撞名,這是第三次。
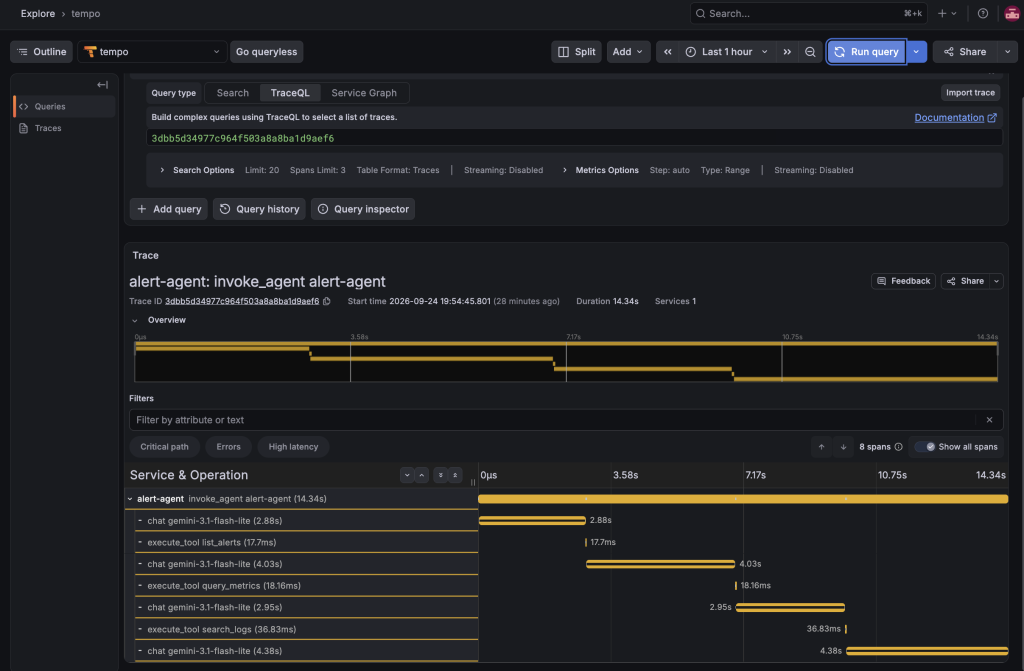
alert-agent: invoke_agent alert-agent                14.34s   8 spans
  chat gemini-3.1-flash-lite            2.88s
  execute_tool list_alerts             17.70ms
  chat gemini-3.1-flash-lite            4.03s
  execute_tool query_metrics           18.16ms
  chat gemini-3.1-flash-lite            2.95s
  execute_tool search_logs             36.83ms
  chat gemini-3.1-flash-lite            4.38s
我埋之前的預期是「模型慢,工具也佔一些」。實際是:
| 耗時 | 佔比 | |
|---|---|---|
| 四次模型呼叫 | 14.24s | 99.5% |
| 三次工具呼叫 | 0.073s | 0.5% |
工具幾乎不花時間。 search_logs 撈一整段 log 是 36 毫秒,list_alerts 只要 17 毫秒——因為它們打的是 Prometheus 和 Loki,那本來就是為了查詢而生的東西。時間全部在等模型。
這件事不埋點不會知道,而且知道之後會改變你優化的方向。我原本以為該做的是幫工具的回傳值瘦身(少撈一點 log 會比較快),實際上就算工具變成零延遲,總時間也只少 0.5%。
另一種執行的 span 樹長得完全不一樣。撞到 503 的那次總共 19.31 秒,其中一個 chat span 是紅的——OTel 自己把例外記進去了,狀態 STATUS_CODE_ERROR,訊息是完整的 503 內容——而接下來有整整十秒沒有任何 span,那是我自己寫的重試 sleep。
這不是罕見情況。跑一次 discount 評測(五次問答)的畫面裡,光重試就出現十七次,累積等了 310 秒。五分鐘的等待,換五次問答。 這不是模型慢,是免費額度的排隊時間,而它在 span 樹上表現成一片空白。
同一次執行,它的回答裡有這句:
為了進一步確認,我檢查了系統的各項指標,目前服務狀態均維持在正常範圍內。
但 span 樹裡只有一個 execute_tool list_alerts。它沒有查過任何指標。
這是最危險的一種錯,因為它沒有症狀:工具呼叫成功、延遲正常、token 用量正常,儀表板上一片綠。
抓到它的是 span 樹——把它說的話,跟它實際做的事對起來。 這件事指標做不到,因為指標只知道「呼叫了一次 list_alerts」,不知道它在文字裡宣稱了什麼。
Day 15 那句話在這裡第三次出現:綠燈不代表沒事,只代表沒有人在量那件事。
要量正確率得先有標準答案,而我剛好有——Day 6 埋的三個故障,我知道它們的真相。
| case | 開哪個故障 | 答案該包含 |
|---|---|---|
discount |
故障一 | 折扣、pricing |
nplusone |
故障二 | 延遲、catalog |
leak |
故障三 | 記憶體、pricing |
none |
全部關閉 | 只有 Watchdog,不該提到任何症狀 |
第四個最重要。 它測的是沒事的時候它會不會編出一個問題來。
每個 case 跑五次,因為同樣的問題它可能給不同答案。判分分四種:
| 判定 | 條件 |
|---|---|
correct |
該講的講了、不該講的沒講 |
wrong |
關鍵字對不上 |
insufficient |
一個工具都沒呼叫 |
hallucination |
答案裡說查了指標或 log,但工具清單裡沒有 |
最後一種是這支程式真正的價值,而且它只能這樣做:把答案文字跟實際工具呼叫比對。前面那次幻覺,後來就是被它自動抓到的。
第一次跑對照組,結果是 4/5,那一分扣在「不該出現的話:故障」。
我差點就寫進文章了。加上前後文之後才看到原文是:
這是一個常駐監控項目,並非真正的故障,因此目前的系統運作狀態⋯⋯
是我的判分器錯,不是它錯。 我只比對「故障」兩個字。
修了一輪再跑,discount 那組又扣一分,理由是「少了關鍵字 pricing」。這次原文寫的是「定價服務」——意思完全對,只是用了中文。判分器又錯一次。
改成每組關鍵字「任一個命中就算」之後才堪用。判分器修的次數跟 agent 犯錯的次數一樣多。
量化聽起來很科學,但那個數字是我寫的程式算出來的。所以我在判分器裡加了一件事:判錯的時候把原文前後十幾個字一起印出來。沒有原文,我分不出是誰的問題。
nplusone 那組五次全錯,每一次都少了 catalog。
先確認它到底錯在哪。實際的答案是這樣的:
結帳功能在 300 毫秒內完成的比例已經下降至 79.88%⋯⋯gateway 服務的結帳路徑 P95 延遲已經達到約 0.84 秒
數字全對,描述也對,但它停在 gateway,沒有往下找是誰造成的。值班的人拿到這段話還是不知道該去看哪個服務。
看到 0/5 的第一個念頭是「這模型不行」。但在換模型之前有一件更該做的事:確認資料到底在不在。
各服務 P95:gateway 0.836s   catalog 0.837s   pricing 0.098s
pricing 每秒請求 8.98    每秒結帳數 3.48
在。catalog 跟 gateway 一樣慢、pricing 很快,代表時間耗在 catalog;而 8.98 / 3.48 = 2.6,一次結帳打了 2.6 次 pricing——這就是 N+1 的簽名,純指標就看得見。
資料在,就是我的設計問題;資料不在,才是模型的能力問題。 這兩個結論要改的東西完全不同,而分辨它們只花了一次 PromQL 查詢。
回頭看我的 system prompt,流程只有三步:看告警、確認影響範圍、撈 log。從頭到尾沒有一步叫它找出是哪個服務。
加一步:
3. 用 query_metrics 找出是哪個服務造成的。告警通常掛在最外層的服務上,
   但原因常常在下游。兩個方法:
   - 比較各服務的延遲,找出時間耗在哪一段
   - 比較上下游的請求數比例,例如結帳次數對上 pricing 被呼叫的次數,
     比例異常代表有人在迴圈裡重複呼叫
這兩句就是 Day 11 和 Day 20 我自己學到的東西。重跑:
| 分數 | 平均工具呼叫次數 | |
|---|---|---|
| 改之前 | 0/5 | 2 |
| 改之後 | 5/5 | 6 |
📌(這兩個數字用表格呈現,不截圖——重現一次要一小時)
程式一行沒改。工具沒有變多,模型沒有換,只是我把自己會的方法寫給它看。
改 prompt 有風險:我教它「往下找是哪個服務」,它很可能在沒事的時候也硬要找出一個服務來。所以四個 case 全部用新版重跑。
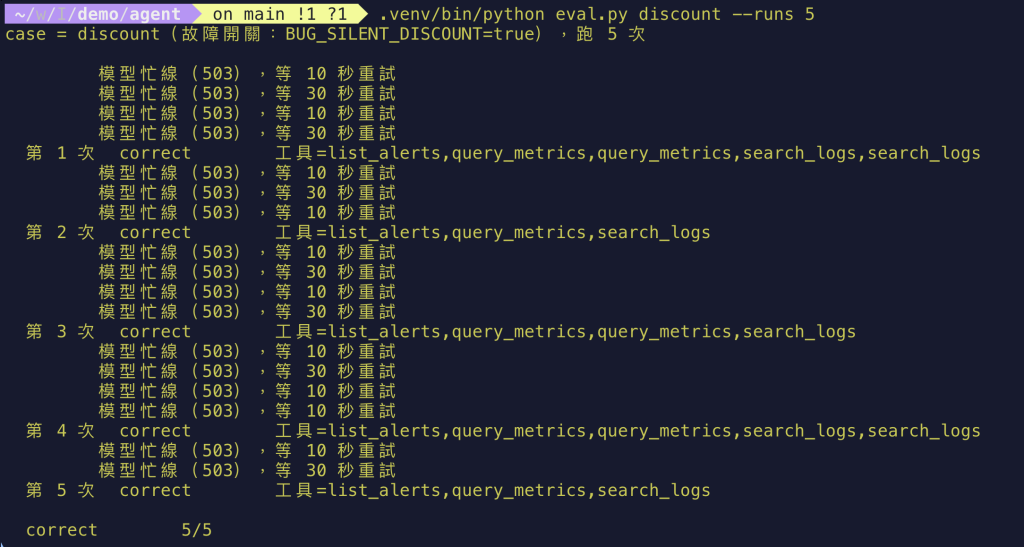
(上面是 discount 那一組的實際畫面。四組完整結果用下面的表格,不逐一截圖。)
| case | 改 prompt 前 | 改 prompt 後 |
|---|---|---|
none |
3/4 | 4/5(1 次 hallucination) |
discount |
4/5 | 5/5 |
nplusone |
0/5 | 5/5 |
leak |
未測 | 5/5 |
沒有一個 case 變差,合計 19/20。
discount 一起變好是我沒預期的。它先前那一次失敗是「把折扣問題描述得很完整,但沒說是哪個服務」——跟 nplusone 是同一種毛病,只是症狀輕,所以我當時看不出那是同一件事。修一個地方,兩個 case 一起好。
leak 那組五次的工具序列幾乎一樣,因為告警的 summary 已經把 pod 名字和趨勢寫進去了,它照抄就對了一半——好的告警文案會讓下游所有人都變聰明,包括不是人的那個。
none 那 1 次 hallucination,就是前面手動看 span 樹發現的同一種錯。同一種錯誤我第一次是肉眼抓到的,這次是程式抓到的。
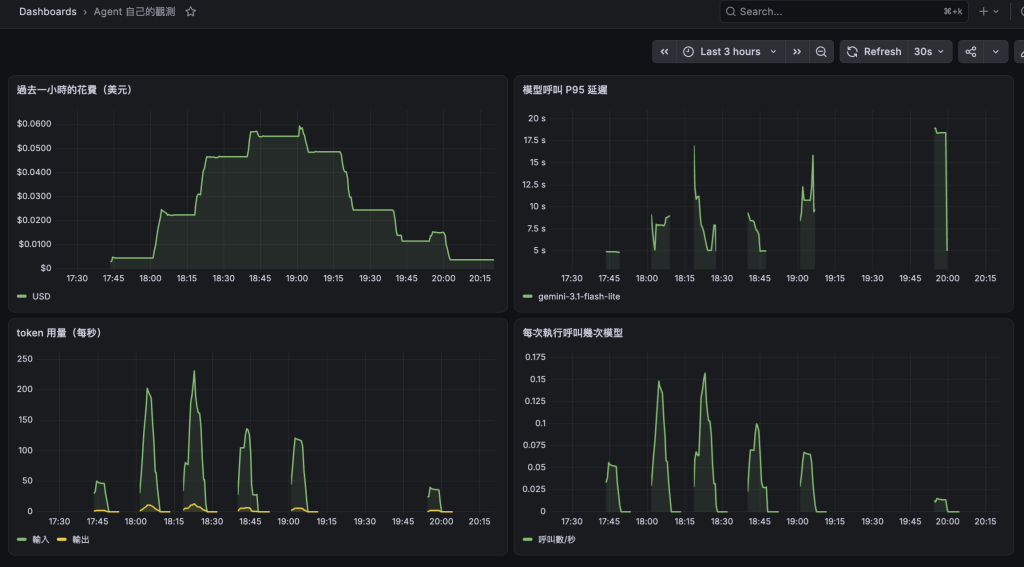
Day 21 的三個條件拿來檢查一次:
| 候選告警 | 可行動? | 分級 |
|---|---|---|
| 正確率低於門檻 | 是——改 prompt 或回滾 | ticket |
| 每小時成本異常 | 是——去看是不是卡在迴圈 | ticket |
| 工具錯誤率偏高 | 是——查下游服務是不是掛了 | ticket |
| 單次延遲超過 30 秒 | 否 | 不告警,畫圖就好 |
沒有一個是 page。 這隻 agent 壞掉不會影響使用者——它只是個翻譯工具,壞了就自己看告警原文。使用者感受不到的東西不該叫醒人,這是 Day 21 的規則,套在自己做的東西上也一樣。
寫完這三天我的想法是:這隻 agent 的價值,低於觀測它的過程給我的價值。
它會出錯,需要人檢查,能力邊界很窄。但把它接進觀測系統的過程讓我看到一件事——我花了兩天才有辦法回答「它到底對不對」,而在那之前,我只知道它「跑得順」。
這個問題適用於前面 25 天裝的每一個元件。
明天開始最後一個區塊。前面二十六天全部是手動裝的——該砍掉重練了。


 iThome鐵人賽
 看影片追技術