
昨天處理了 Grafana 裡面的設定,今天處理叢集裡面的東西。
前天盤點出三個洞:Loki 的設定只存在叢集裡、Tempo 全吃預設、五個 chart 的版本號沒有一個地方記著。今天要做的就是把它們補起來,順便把五條散在終端機歷史裡的 helm install 收成一個檔案。
這是最後一天的準備工作。收完之後,砍掉叢集重建才有東西可跑。
Loki 的設定當初是用 --set 打在指令列上的,但它其實一直好好地存在叢集裡——Helm 會記住你給過什麼:
helm get values loki -n monitoring | tail -n +2 > helm/loki-values.yaml
一行就搬完了。tail -n +2 是為了拿掉第一行的 USER-SUPPLIED VALUES:,那是標題不是設定。
Tempo 就沒這麼簡單,因為 helm get values tempo 回的是 null——它從頭到尾吃預設值,沒有東西可以匯出。
這裡有個查法值得記:同一個指令加上 -a,看到的是完整生效的設定,也就是 chart 預設值疊上你給的值之後的結果。Tempo 那份有 199 行。
$ helm get values tempo -n monitoring        # 只有我給過的
null

$ helm get values tempo -n monitoring -a     # 實際生效的全部
...199 行...
persistence:
  enabled: false        ← 在這裡
兩個指令的用途不一樣:匯出成 values 檔要用不加 -a 的版本,因為 -a 會把 chart 當下的預設值全部寫死進你的檔案,等於凍結在這個版本,以後升級反而變成阻礙。但要查「現在到底是什麼設定在生效」,一定要用 -a。
我當初如果用 -a 看過一眼,那行 persistence: enabled: false 就在眼前。我沒看,因為我以為「沒有自訂設定」等於「沒什麼好看的」。
實際去查才發現不是:
kubectl -n monitoring get sts tempo -o jsonpath='{.spec.template.spec.volumes[*].name}'
# tempo-conf
只有一個設定檔的 volume,沒有任何儲存。 Tempo 的設定裡寫著 trace 寫到 /var/tempo/traces,而那個路徑在 Pod 的暫存檔案系統上。Pod 重啟,trace 就沒了——它已經重啟過三次。
這是同一個教訓學第二次。Grafana 被 helm upgrade 洗掉之後,我補了 Grafana 和 Prometheus 的持久化,也回頭查了 Loki,唯獨沒查 Tempo。因為 Tempo 從來沒出過事,所以我從來沒看它一眼。
# helm/tempo-values.yaml
persistence:
  enabled: true
  size: 5Gi
到這裡為止,五個元件各自有一份 values 檔了。但還缺三件事:chart 從哪個 repo 來、要裝哪個版本、誰先誰後。這三件事現在只存在我的終端機歷史裡。
一個做法是寫一支 shell script,把五條 helm upgrade --install 排好順序。可以,但那是命令式的——它描述「怎麼做」,不是「要什麼」。跑到一半失敗了,你得自己想清楚重跑會不會出事。
Helmfile 是管這件事的工具。一個 YAML 描述我要裝哪些 chart、什麼版本、用哪份 values、誰先誰後,然後它自己算出該做什麼。
repositories:
  - name: prometheus-community
    url: https://prometheus-community.github.io/helm-charts
  - name: grafana
    url: https://grafana.github.io/helm-charts
  - name: open-telemetry
    url: https://open-telemetry.github.io/opentelemetry-helm-charts

releases:
  - name: kps
    namespace: monitoring
    createNamespace: true
    chart: prometheus-community/kube-prometheus-stack
    version: 90.0.0
    values:
      - helm/kube-prometheus-stack-values.yaml

  - name: tempo
    namespace: monitoring
    chart: grafana/tempo
    version: 1.24.4
    values:
      - helm/tempo-values.yaml

  - name: otel-collector
    namespace: monitoring
    chart: open-telemetry/opentelemetry-collector
    version: 0.173.1
    values:
      - helm/otel-collector-values.yaml
    needs:
      - monitoring/tempo
三個指令,跟昨天的 OpenTofu 是同一個節奏:
helmfile deps     # 拉 chart repo
helmfile diff     # 看「如果執行會改什麼」
helmfile apply    # 執行
先看再做是 IaC 的通用習慣,不是某個工具的特色。昨天是 tofu plan,今天是 helmfile diff,同一件事。
needs 那幾行宣告誰要先裝好:
kps(Prometheus + Grafana + Alertmanager + Operator 的 CRD)
loki  ────────────►  alloy            Alloy 把 log 送給 Loki
tempo ────────────►  otel-collector   Collector 把 trace 送給 Tempo
寫這幾行的時候我才發現:這條鏈我從來沒完整寫下來過。
前面二十八天是一次裝一個,每次只知道「這個要先裝好」,但整張圖長什麼樣、哪兩個其實可以並行,是被這個檔案逼出來的。IaC 除了可重現之外的另一個價值就是這個——它逼你把架構寫成一句能執行的話。
版本全部釘死之後,第一次跑 helmfile diff 對著現在的叢集比:
| release | 差異 |
|---|---|
| kps | 一致 |
| loki | 一致 |
| tempo | 新增 16 行 |
| otel-collector | 一致 |
| alloy | 一致 |
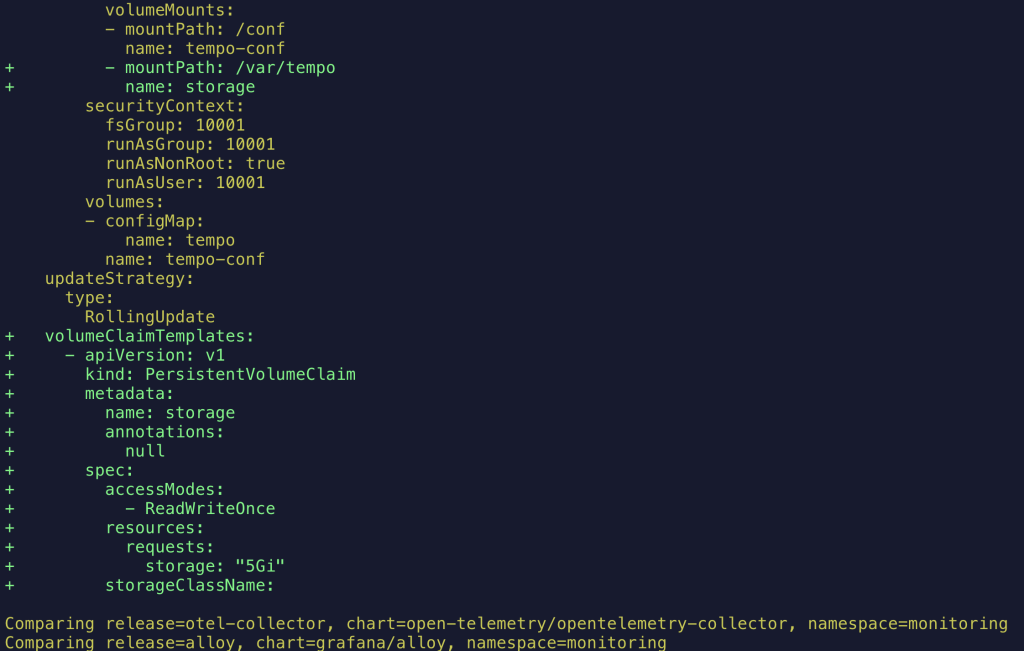
只有 Tempo 有差,而且差的正好是我剛加的持久化。其他四個完全一致,代表這份檔案真的描述了現在跑著的叢集,不是我照記憶重寫的另一份東西。
這個比對本身就是驗收。如果有哪個 release 冒出我沒預期的差異,那就代表叢集裡有東西不在檔案裡。
helmfile apply,然後爆了:
level=WARN msg="this chart is deprecated"
Error: UPGRADE FAILED: StatefulSet.apps "tempo" is invalid:
spec.volumeClaimTemplates: Invalid value: [...]: field is immutable
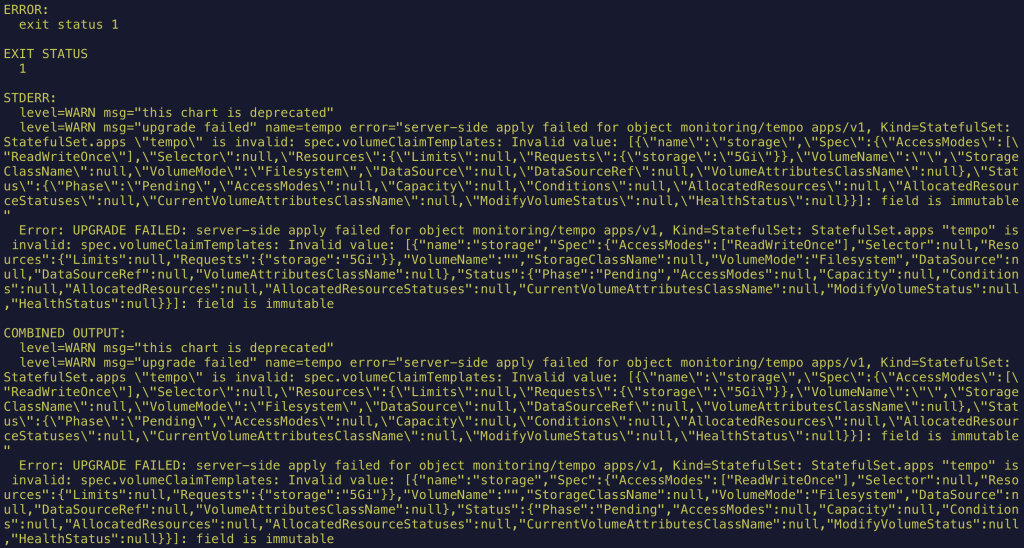
StatefulSet 的儲存宣告建立之後改不了。 不能替一個已經在跑的 StatefulSet 加上持久化,只能把它砍掉重建。
這件事很符合這幾天的主題:有些改動本質上就是砍掉重來,不是修改。 而如果你不知道這件事,看到這個錯誤會以為是自己 YAML 寫錯。
接下來這段是今天最重要的發現,而且我是不小心撞到的。
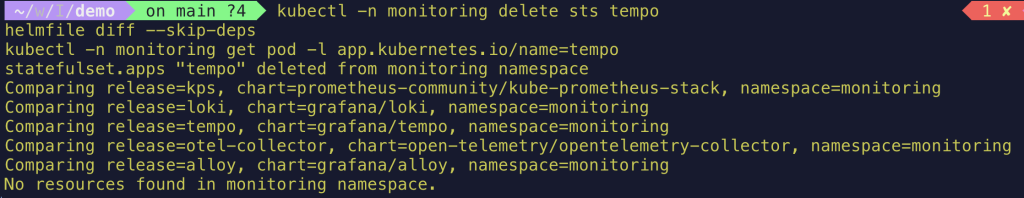
我照著錯誤訊息的意思,把 StatefulSet 刪掉重跑:
kubectl -n monitoring delete sts tempo
helmfile apply
回傳 exit=0,看起來成功了。結果去看叢集:
$ kubectl -n monitoring get pod -l app.kubernetes.io/name=tempo
No resources found in monitoring namespace.
Tempo 不見了,而 apply 說一切正常。
順著查下去,鏈條是這樣的:
| 發生什麼 | |
|---|---|
| 1 | 升級因為不可變欄位失敗 |
| 2 | 但 Helm 還是把新的 manifest 記成 revision 2,狀態 failed |
| 3 | 我手動刪掉 StatefulSet |
| 4 | helmfile diff 說沒有差異 |
| 5 | helmfile apply 什麼都沒做 |
確認第 2 步:
helm get manifest tempo -n monitoring | grep -c volumeClaimTemplates
# 1
Helm 記的那份 manifest 已經有持久化了,而我的檔案也有持久化,兩邊一樣,所以 diff 是空的。
helm diff 比對的是「你的檔案」跟「Helm 資料庫裡記的上次部署內容」,不是叢集的實際狀態。 我在叢集上刪掉的東西,它完全看不見。
這跟昨天那個工具剛好相反。tofu plan 的第一行是:
grafana_folder.observability: Refreshing state... [id=1:observability]
它會真的打一次 API,去確認那個資料夾還在不在。所以昨天我把資料夾從 state 移掉之後,plan 馬上就發現「線上已經有一個了」。
兩個工具的 plan 和 diff 長得很像,可信度不一樣。 用 helmfile 的時候,「沒有差異」的意思是「跟上次部署的內容一樣」,不是「叢集就是這樣」。
修法是把那個失敗的 release 整個移掉重裝:
helm uninstall tempo -n monitoring
helmfile apply
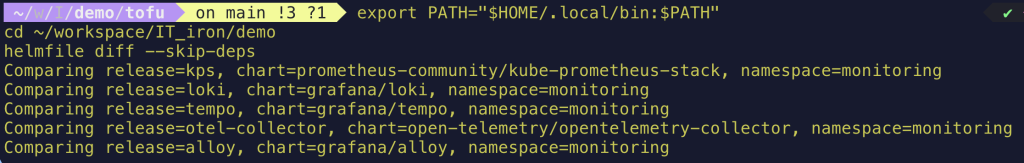
這次 Tempo 帶著 5Gi 的 PVC 回來了。五個 release 全部收斂:
順帶一提,helm uninstall 不會刪掉 StatefulSet 建立的 PVC。我重裝之前那個 storage-tempo-0 還好好地留在叢集裡,重裝之後新的 Pod 直接接手用它。這是刻意的設計——資料比工作負載值錢,不該被一個 uninstall 帶走。但它也意味著「移除 release」離「清乾淨」還有距離。
那次失敗的 apply 還順手告訴我另一件事,夾在一堆錯誤訊息中間:
level=WARN msg="this chart is deprecated"
查一下:
helm show chart grafana/tempo --version 1.24.4 | grep deprecated
# deprecated: true
我釘的是一個已經棄用的 chart 的版本。
這件事把「版本鎖定」的意義切得更清楚了:
而且這個警告只在 upgrade 的時候跳出來。helm search repo tempo 的輸出裡完全看不出來,helm install 當初也沒攔我。要查得自己去讀 Chart.yaml。
我這次不換,因為換成 tempo-distributed 是把單機模式改成微服務模式,對一個筆電上的 kind 叢集是反方向。但我把這件事寫進 values 檔的註解裡——已知的技術債要寫下來,不然它就只是忘記。
今天真正花時間的不是寫 YAML,那個檔案四十行、半小時就好了。花掉一整個晚上的是把工具裝起來:
| 卡在哪 | 怎麼過 |
|---|---|
brew install 失敗 |
連不到 ghcr.io,改抓官方二進位檔 |
| 二進位檔下載中斷兩次 | curl -C - 續傳 |
helm plugin install 被拒 |
新版 Helm 預設要驗證外掛簽章,加 --verify=false |
| 外掛裝好了卻不能執行 | helm plugin list 有它,但 bin/diff 沒下載到 |
helmfile diff 說 repo 連不上 |
不是連不上,是索引檔太大逾時,先單獨 helm repo update |
第四個最值得講。helm plugin list 明明列出 diff 3.15.13,執行卻是 no such file or directory——登記了,但檔案不在。安裝腳本要去抓一個 34 MB 的執行檔,抓不完就結束了,而且沒有回報失敗。
這個系列一路在收集的那種錯誤,又一個:它告訴你成功了,實際上沒有。
Helmfile 只管 Helm release,管不到 k8s/ 底下那些用 kubectl apply 部署的東西——三個示範服務、ServiceMonitor、告警規則。
要收進來的話,正規做法是把它們包成一個自己的 chart,變成 Helmfile 的第六個 release。這樣做有一個好處:故障開關可以變成 values,改檔案就能切換,而且 git 上看得到誰在什麼時候開了哪個。
我不做,兩個理由。
那些檔案已經在版控裡了。 包成 chart 不會讓它們「更在版控裡」,只是多一層樣板語法。這跟昨天決定不把儀表板搬到 Terraform 是同一個判斷。
它們沒有需要參數化的地方。 Helm 的價值在於「同一份樣板,不同環境給不同的值」。我只有一個環境,套上樣板之後每個值都只會有一種可能,那層抽象就是純成本。
代價是最後一天的重建會有兩個步驟:helmfile apply 之後還要 kubectl apply -f k8s/。兩行指令換掉一層抽象,我覺得划算。
清點一下:
| 路徑 | 管什麼 |
|---|---|
kind-config.yaml |
叢集本身 |
helmfile.yaml + helm/*.yaml |
叢集裡的五個元件,含版本 |
k8s/*.yaml |
三個示範服務、ServiceMonitor、告警規則 |
grafana/*.yaml |
兩張儀表板 |
tofu/main.tf |
Grafana 的資料夾 |
agent/ |
那隻 agent、它的埋點與評測 |
這六個就是前面二十九天的全部。 明天要驗證的就是這句話對不對。
helm get values 可以把只存在叢集裡的設定倒出來變檔案helmfile diff 比的是上次部署的紀錄,不是叢集實際狀態——這點跟 tofu plan 不一樣明天砍掉整個叢集,用這六個目錄重建一次。


 iThome鐵人賽
 看影片追技術