
告警區塊最後一天。前三天講原則、寫設定、算門檻,今天講這些東西上線之後會發生什麼事。
先講結論:它們不會照你想的跑。 我昨天那則記憶體預測告警,今天實際跑一次,三個地方跟我寫的時候想的不一樣。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=false LEAK_KB_PER_REQUEST=8
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
LEAK_KB_PER_REQUEST=8 是算出來的。pricing 每秒收 5.6 個請求,每個請求平均 4.2 件商品,每件洩漏兩次,所以是每秒 47 次洩漏。乘上 8 KB 就是每分鐘 22 MB,從 60 MiB 爬到 512 MiB 的上限大約 20 分鐘。
Day 21 我第一次打開 Alertmanager,15 則誤報從裝好那天就在響,我十三天沒看過一次。那些不是我加的,是 chart 的預設值,但結果一樣:我對那個畫面已經免疫了。
真實團隊的版本只是換一個加的人。出事、檢討、加一則告警,重複幾次變成十幾則;其中幾則偶爾誤報,沒人有空修就先忍著;再過一陣子,「先看一下、通常沒事」變成預設反應。這個過程只有加,沒有減。
所以除了「怎麼設好告警」,還要有辦法知道哪一則該拿掉。而那要等它實際跑過一次。
10:44 打開洩漏,然後每分鐘記一次記憶體和告警狀態:
| 時間 | 記憶體 | 告警狀態 |
|---|---|---|
| 10:44 | 60 MiB | inactive |
| 10:49 | 161 MiB | pending |
| 10:54 | 275 MiB | pending |
| 11:00 | 406 MiB | firing |
| 11:05 | 506 MiB | firing |
| 11:06 | 94 MiB | firing |
11:06 那一行就是 OOM。確認一下:
kubectl get pods -l app=pricing -o custom-columns=\
'POD:.metadata.name,RESTARTS:.status.containerStatuses[0].restartCount,\
LAST:.status.containerStatuses[0].lastState.terminated.reason,\
EXIT:.status.containerStatuses[0].lastState.terminated.exitCode'

exit code 137 是 128 + 9,也就是被 SIGKILL 砍掉——不是程式自己結束的,是核心的 OOM killer 動的手。這個畫面是我讓它跑了三個多小時之後截的,RESTARTS 已經 14 次,每二十分鐘一輪。
把同一段時間畫成圖會更清楚。先開 Grafana(另開一個終端機,這行會一直佔著):
kubectl port-forward -n monitoring svc/kps-grafana 3000:80
到 http://localhost:3000 → 左邊選單 Explore → 資料源選 Prometheus(不是 loki 或 tempo),查詢輸入:
container_memory_working_set_bytes{namespace="default", container="pricing"}
右上角時間選 Last 3 hours。我第一次畫出來長這樣:
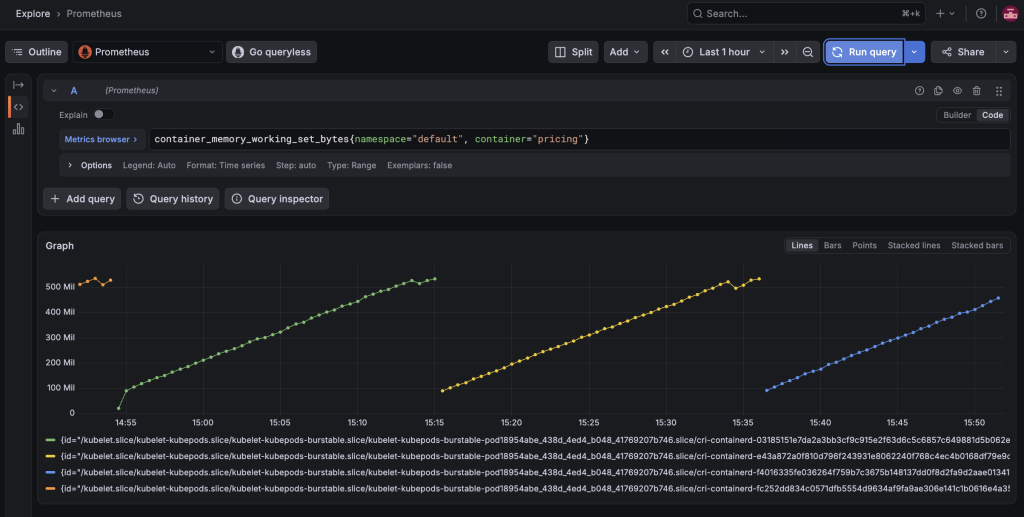
不是一條鋸齒,是四條各自往上爬的線,圖例是四串看不懂的 cri-containerd-xxxx。
那四條不是四個 Pod。這裡有個容易搞混的地方:OOMKilled 殺掉的是容器,不是 Pod。 Pod 這個殼一直在,名字和 UID 都沒變,只是裡面的容器被換掉十幾次——上面那個 RESTARTS: 14 就是在數這個。所以四條線是同一個 Pod 裡的四代容器,pod 標籤完全一樣,差別在 cAdvisor 給每個容器實例的 id 和 name。
這個現象等一下會變成今天的第三個發現,先講怎麼畫得好看。max by (pod) 的意思是「把 pod 以外的標籤全部丟掉,剩下的按 pod 分組、每個時間點取最大值」——那四條的 pod 一樣,所以合成一條。順便把 Options 裡的 Legend 填成 {{pod}},圖例就會變成 Pod 名字:
max by (pod) (container_memory_working_set_bytes{namespace="default", container="pricing"})
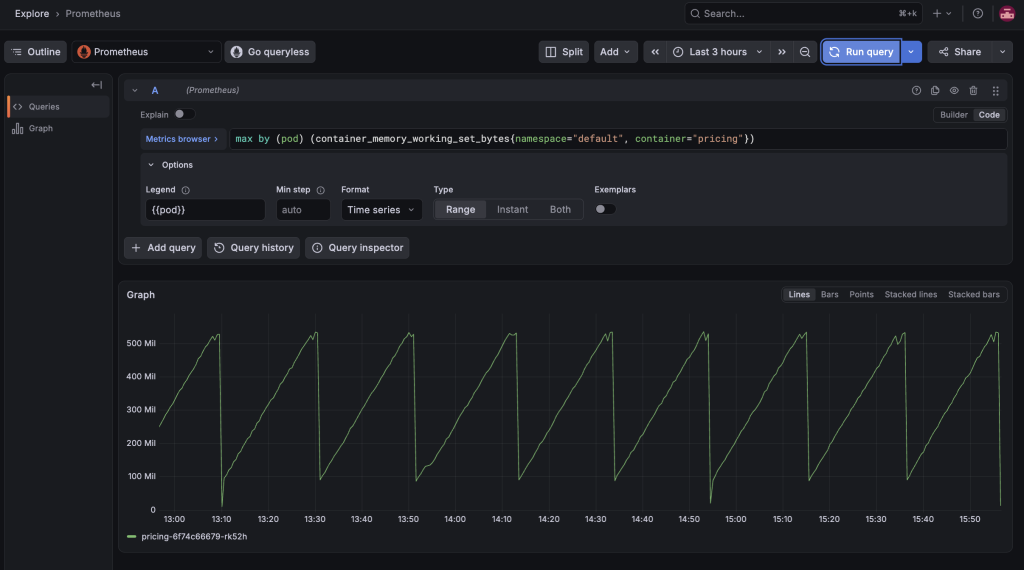
三小時九輪,每一輪都是同一個形狀:斜著爬二十分鐘到 5 億 bytes 左右(memory limit 是 512 MiB),然後垂直掉到底,再從頭來。圖例只有一行,因為從頭到尾就只有一個 Pod。
垂直掉下來那一刀之所以乾淨、沒有重疊,是因為容器死掉之後 cAdvisor 就不再回報它的序列,Prometheus 會把它標記成失效——所以那個時間點只剩新容器一條有值,max 自然取到它。
Y 軸那個「500 Mil」是原始的位元組數,Explore 裡沒有換算單位的選項——那是儀表板面板才有的 Standard options。真的想看 MiB 就在查詢後面除一下:... ) / 1048576。
alert-sink 也收到了:
PodMemoryWillExhaustLimit ticket pricing 照目前趨勢,4 小時內會撞到記憶體上限
告警有響、分級是 ticket、summary 讀得懂。看起來一切正常。但有三個地方不對。
我在 annotation 裡寫的是「4 小時內會撞到記憶體上限」。實際上,從收到通知到 OOM 只有五分鐘。
把時間攤開來看:
| 時間 | 發生什麼 |
|---|---|
| 10:44 | 打開洩漏 |
| 10:46 | predict_linear 算出「會撞上限」,告警進 pending |
| 11:01 | 撐滿 for: 15m,轉成 firing,通知送出 |
| 11:06 | OOMKilled |
條件在第 2 分鐘就成立了,但通知第 17 分鐘才送出。 中間那 15 分鐘是 for 要求的等待。
for 本身沒有錯,它存在的理由是避免瞬間抖動變成通知(Day 21 講過)。錯的是我沒有把它跟這個問題的發展速度放在一起看:我設的洩漏速度是每分鐘 22 MB,二十分鐘就撞上限,而我要它等十五分鐘。
判準是:for 要遠小於問題從發生到造成傷害的時間。 真實的記憶體洩漏是以小時或天為單位的,for: 15m 放在那種速度下完全不影響。我這個每分鐘 22 MB 是為了在一篇文章裡演完硬調出來的,配 15 分鐘就太久。
11:06 容器被殺掉重啟,記憶體從 506 MiB 掉回 94 MiB。我以為告警會跟著解除,結果它繼續 firing。
原因是 predict_linear 看的是過去一小時的資料。那一小時裡有五十幾分鐘是陡峭的上升,只有最後那一下是垂直下墜。一條直線穿過這一小時,斜率還是往上,所以它還是預測「會撞上限」。要等下墜之後的新資料填滿整個視窗,斜率才會轉負。
這個行為是對的。 重啟不代表洩漏修好了,告警不該因為記憶體歸零就消失——那正是昨天說固定門檻不能用的理由。
但我昨天給的理由是錯的。我寫的是「趨勢不會被重啟洗掉」,聽起來像 predict_linear 天生免疫。實際上它只是因為視窗夠長,那一下下墜佔的比例太小。視窗改成五分鐘的話,一樣會被洗掉。
這個最嚴重。重啟之後我去看規則狀態:
state = firing
lastError = multiple matches for labels: many-to-one matching must be explicit (group_left/group_right)
它同時在 firing,也同時在報錯。
原因就是上面那張四條線的圖:容器每重啟一次,cAdvisor 就對同一個 (namespace, pod, container) 多留一條序列,靠 id 和 name 標籤區分。畫圖的時候那只是圖例很醜,但我的規則寫的是:
predict_linear(container_memory_working_set_bytes{...}[1h], 4*3600)
  > on(namespace, pod, container)
kube_pod_container_resource_limits{...}
左邊變成兩條、右邊一條,on(...) 就成了多對一,Prometheus 拒絕計算。修法跟剛才畫圖那招一樣,兩邊都先用 max by 收斂成一條:
max by (namespace, pod, container) (
  predict_linear(container_memory_working_set_bytes{namespace="default", container!=""}[1h], 4 * 3600)
)
  > on(namespace, pod, container)
max by (namespace, pod, container) (
  kube_pod_container_resource_limits{namespace="default", resource="memory"}
)
值得注意的是這個錯誤出現的時機:規則寫好、apply、看到 Inactive 的時候一切正常,因為那時候還沒有任何容器重啟過。 它要等到第一次 OOM 才會出現,而那正好是你最需要這則告警的時候。
這個錯誤在 Alerts 分頁看不到。要去 Status → Rules(網址是 http://localhost:9090/rules),找到 memory-trend 這個群組,規則旁邊會標一個紅色的 err,底下就是那行錯誤訊息:
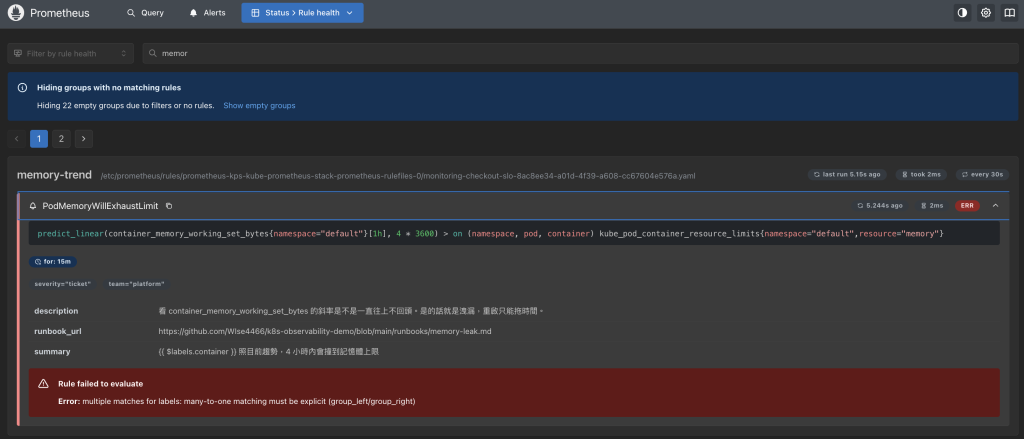
同一時間回 Alerts 分頁看同一則規則:
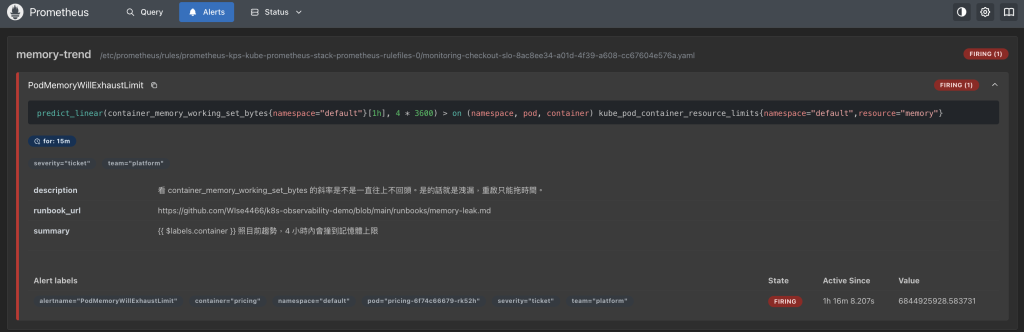
FIRING (1),Active Since 1 小時 16 分,一切正常。右下角的 Value 還印著 6844925928——也就是 predict_linear 算出四小時後會用到 6.8 GB(上限是 512 MiB)。它一邊報錯一邊算得出數字、一邊照樣送通知。 只有一個地方會告訴你出事了,而那個地方不是你平常會看的那一頁。也可以從 API 撈,欄位叫 health 和 lastError:
curl -s http://localhost:9090/api/v1/rules | python3 -c "
import json,sys
for g in json.load(sys.stdin)['data']['groups']:
    for r in g['rules']:
        if r.get('lastError'): print(r['name'], '→', r['lastError'])"
這是這個系列第九次遇到同一種事:東西看起來在運作,實際上壞了,而且沒有任何地方會告訴你。 前八次都是別人的預設值,這次是我自己寫的。
從上面三件事回到設計。我用三級:
| 分級 | 什麼時候用 | 送去哪 | 我的例子 |
|---|---|---|---|
| page | 使用者正在受影響,需要立刻處理 | 立即通知 | burn rate 快燒 |
| ticket | 真的有問題,但可以等 | 每日彙整 | 記憶體洩漏預測、折扣算錯 |
| info | 值得知道,不需要行動 | 只進儀表板 | 部署完成、擴縮容 |
大部分的告警疲勞來自把 ticket 當成 page。 分級的意義不是標記嚴重程度,是決定它可不可以打斷別人。
一個好用的檢驗:這則告警半夜三點響,你會起床嗎?答案是「應該不用」的話,它就不該是 page。Day 23 我用 burn rate 把故障二從 page 降成 ticket,用的就是這個判準,只是那次有數字撐腰。
告警是會腐爛的。服務改了、門檻過時了、當初擔心的問題已經不存在了。我打算每個月問三個問題:
第三個最重要,因為前兩個都在看現有的告警,只有它會發現缺口。
但刪除告警比新增難得多,因為刪除要承擔「萬一以後出事」的責任,而新增不用。這個不對稱就是告警愈長愈多的根本原因。我的做法是:把「刪掉一則沒用的告警」當成跟「新增一則告警」同等的成果。
predict_linear 預測四小時後會超過上限,分級 ticketfor: 15m 讓預警時間只剩六分鐘;而且容器重啟後規則會因為序列變兩條而報錯做完把它關掉:
kubectl set env deploy/pricing LEAK_KB_PER_REQUEST=0
Day 7 那四句:
| 天花板 | 被誰解決 | 哪一天 |
|---|---|---|
| 只有現在,沒有歷史 | Prometheus | Day 8 |
| 只有文字,不能聚合 | Loki + LogQL | Day 16 |
| 只有單點,無法跨服務關聯 | OpenTelemetry + exemplar | Day 20 |
| 只能被動查,不會主動通知 | Alertmanager + burn rate | 今天 |
三個故障也全部結案。如果面試官現在再問我一次「服務出問題時你怎麼查」,我答得出來了。
for、預測視野、問題發展的速度,這三個數字要一起挑,只想一個就會像我一樣把四小時預警變成六分鐘明天開始最後兩個區塊。先做一隻會讀告警的 agent,然後把它自己也放進這套觀測系統裡。


 iThome鐵人賽
 看影片追技術