
昨天講原則,今天寫設定。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=false LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
先講一件我一開始搞不清楚的事:Prometheus 和 Alertmanager 是兩個不同的程式,分工是這樣:
為什麼要拆成兩個?因為判斷跟通知的變化頻率完全不同。告警規則跟著服務走,通知規則跟著組織走——今天值班的是誰、半夜要不要吵、哪些事走信件哪些走電話。兩者混在一起會互相綁架。
這也是為什麼它們的設定在不同地方:規則是 PrometheusRule 這個 CRD,用 kubectl apply;路由是 Alertmanager 自己的設定,走 helm values。
動手之前先把昨天那 14 則假的關掉,不然待會兒新加的告警會淹在裡面。把 Alertmanager 的分組展開,看得到它們的名字:
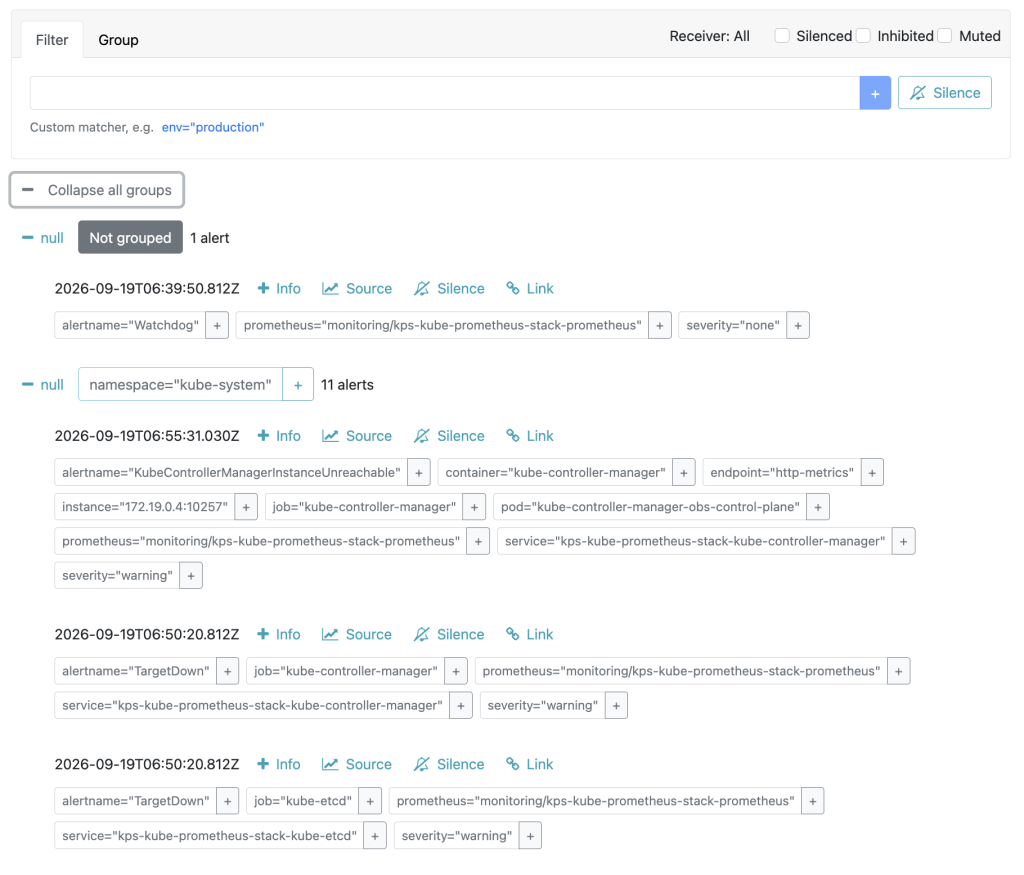
KubeControllerManagerInstanceUnreachable、TargetDown job="kube-controller-manager"、TargetDown job="kube-etcd"⋯⋯每個抓不到的元件都貢獻兩則:一則「這個 target 掛了」、一則「這個元件掛了」。
chart 裡四個控制平面元件各有一個開關,關掉之後它的 ServiceMonitor 和告警規則會一起消失:
kubeControllerManager: {enabled: false}
kubeScheduler: {enabled: false}
kubeProxy: {enabled: false}
kubeEtcd: {enabled: false}
節點校時那兩則不屬於任何元件,要用另一個欄位針對單條規則關:
defaultRules:
  disabled:
    NodeClockNotSynchronising: true
    NodeClockSkewDetected: true
這裡要說清楚一件事:我關掉的是「在 kind 上一定是假的」那幾條,不是「我不想看到的」那幾條。 這個區別很重要,因為關告警是一個很容易上癮的動作。判準是:這則告警在我的環境裡有沒有可能是真的?etcd 在 kind 裡綁 localhost,Prometheus 永遠抓不到,那它永遠是假的;但 KubeletDown 我就留著,因為 kubelet 真的可能掛。
順帶一提我去數了一下,這個 chart 預設帶 155 條告警規則,關完剩 132 條。我從 Day 8 裝到現在,一條都沒看過。
關誤報的時候我順便去看了 Alertmanager 的預設設定,看到這個:
route:
  receiver: 'null'
  routes:
    - receiver: 'null'
      matchers: [alertname = "Watchdog"]
receivers:
  - name: 'null'
null 是一個什麼都不做的 receiver。chart 的預設是把所有告警都丟掉。
所以昨天那 15 則的狀況不是「我沒去看」,是就算我設好了信箱也收不到——它們在 Alertmanager 的畫面上列著,但沒有任何一則被送出去過。連 Watchdog 也是,那個專門用來證明「通知管線是通的」的告警,被設定成不通知。
這其實是合理的預設值:chart 不知道你要送去哪,總不能亂猜。但它安靜得過分——不會有任何東西告訴你「你的告警沒有出口」。這是這個系列第八次了。
新增 k8s/alerts.yaml,用 PrometheusRule 這個 CRD:
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: checkout-slo
  namespace: monitoring
  labels:
    release: kps               # ⚠️ 漏了就靜默失效
spec:
  groups:
    - name: checkout
      rules:
        - alert: CheckoutLatencySLOBreach
          expr: |
            sum(rate(http_request_duration_seconds_bucket{job="gateway", path="/checkout", le="0.3"}[5m]))
              / sum(rate(http_request_duration_seconds_count{job="gateway", path="/checkout"}[5m]))
              < 0.95
          for: 10m
          labels:
            severity: page
            team: checkout
          annotations:
            summary: "結帳在 300ms 內完成的比例只有 {{ $value | humanizePercentage }},SLO 是 95%"
            description: "先看 P50 有沒有跟著動:P50 平、P95 高就是長尾,去 Tempo 找慢的 trace。"
            runbook_url: "https://github.com/WIse4466/k8s-observability-demo/blob/main/runbooks/checkout-latency.md"
labels 裡那個 release: kps 跟 Day 8 的 ServiceMonitor 是同一個坑:Operator 靠它決定要不要撿這份設定,漏了就不載入,而且不會有任何錯誤訊息。
這條 expr 是直接照 Day 2 定的 SLO 翻出來的——「300 毫秒內完成的請求數 ÷ 總請求數 ≥ 95%」。分子用 le="0.3" 那個桶的計數,分母用 _count,正好就是那句話。SLO 訂在兩週前,今天才第一次拿它來擋事。
這兩個一開始很容易混:
| 給誰看 | 影響什麼 | |
|---|---|---|
labels |
機器 | 路由和分組——labels 一樣的告警會被當成同一類 |
annotations |
人 | 只是通知的內容,不影響行為 |
所以 severity 這種要拿來做決策的放 labels,summary 這種給人讀的放 annotations。昨天講的三個條件在這裡全部落地:severity 是可行動性的分級、team 是主人、annotations 裡那幾個連結是上下文。
runbook 我真的寫了兩份放在 repo 的 runbooks/。寫的過程確實驗證了昨天那句話——寫 CheckoutLatencySLOBreach 的時候很順,因為前面十幾天查過同樣的問題;寫故障一那則的時候卡住了,因為「補上缺的折扣規則」不是我能做的事,那要看資料的人去補。卡住本身就是資訊:這則告警的主人不是我。
告警送進 Alertmanager 之後,它做四件事。
一、路由。 一棵樹,由上往下比對 labels,決定送去哪裡:
route:
  receiver: default          # 沒有命中任何子路由時的預設
  routes:
    - matchers: ['alertname = "Watchdog"']
      receiver: heartbeat
      repeat_interval: 1h
    - matchers: ['severity = "page"']
      receiver: urgent
    - matchers: ['severity = "ticket"']
      receiver: tickets
      group_wait: 5m
      repeat_interval: 24h
子路由沒寫的欄位會繼承父層,所以 urgent 那條用的是最上面的 group_wait: 30s,而 tickets 自己蓋掉成 5 分鐘——工單不急,多等一下可以多合併幾則。
二、分組。 這是最實用的一個。假設 pricing 掛了,它同時觸發「可用性低」「延遲高」「錯誤率高」三則,每個 Pod 各一份,沒有分組你會收到九則通知。分組把同一組 label 的告警合併成一則:
group_by: [alertname, team]
group_wait: 30s          # 第一則來了先等 30 秒,看有沒有同伴
group_interval: 5m       # 同一組有新成員時,最快 5 分鐘再通知一次
repeat_interval: 4h      # 問題還沒解決的話,每 4 小時提醒一次
group_wait 這個設計很聰明——先等一下,因為出事的時候通常不會只出一件事。chart 的預設 group_by 是 [namespace],我改成 [alertname, team],因為我想要的合併方式是「同一件事、同一個負責人」。
三、抑制。 當 A 發生時,不要再通知 B。節點掛了的話上面所有服務都會告警,但你只需要知道節點掛了:
inhibit_rules:
  - source_matchers: ['severity = "critical"']
    target_matchers: ['severity =~ "warning|info"']
    equal: [namespace, alertname]
equal 那行是重點:它限定「只抑制 namespace 和 alertname 都一樣的」。少了它,某一則 critical 會把整個叢集所有 warning 全部壓掉。抑制是四個裡面最容易設錯的,因為設錯的後果是「該叫的沒叫」,而那個錯誤幾乎不可能被發現——你不會收到一則通知說「有一則通知被抑制了」。
四、靜音。 暫時關掉某些告警,通常用在計畫性維護。跟前三個不同,靜音是在網頁上手動操作的:
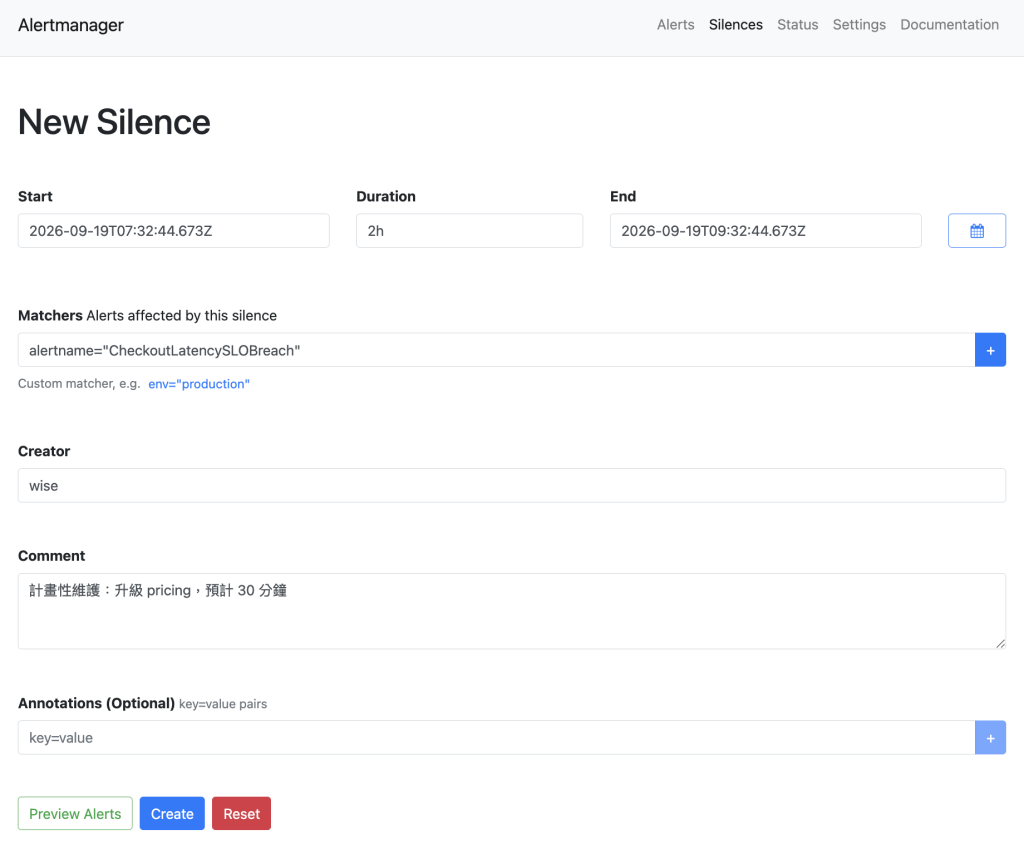
Duration 預設就填了 2h,End 跟著算出來——這個表單不讓你設定一個不會到期的靜音。Creator 和 Comment 可以留空,但我建議每次都填:三個月後回來看這條靜音,那兩欄是唯一能判斷它還該不該留著的依據。上面那條寫的是「計畫性維護:升級 pricing,預計 30 分鐘」,到期時間卻設了兩小時——這種落差就是靜音變成技術債的起點,寫下來至少下次有人看得出來。
永久靜音是一種技術債。 「先靜音一下之後再處理」的告警,通常再也不會被處理。如果一則告警需要被靜音超過一週,該做的是修掉它或刪掉它。
Alertmanager 支援信件、Slack、PagerDuty 等等。我寫了一個 webhook 接收器,叫 alert-sink,三十行 FastAPI:
@app.post("/alerts")
async def receive(request: Request):
    body = await request.json()
    for a in body.get("alerts", []):
        log.info("alert received", alertname=a["labels"].get("alertname"), ...)
        recent.append(entry)
    return {"received": len(body.get("alerts", []))}
它做兩件事:把每則告警寫成一行結構化 log(於是告警自己也進了 Loki,可以用 LogQL 查),以及存在記憶體裡供 /alerts 讀取——後面那隻讀告警的 agent 要用。
順帶說明一個決定:我不打算接 LINE 或 Slack 機器人。那是很常見的做法,但這個系列的重點是告警設計,不是告警的傳輸。把通知接到聊天工具是一個下午就做完的事,怎麼不製造告警疲勞要花三十天才想得清楚。
上面那些 yaml 片段分別屬於三個檔案,整理一下。
檔案一:helm/kube-prometheus-stack-values.yaml(Day 20 建的,這次往下加)。放兩件事:關掉誤報的那五行、還有 alertmanager.config 底下的路由、分組、抑制。這個檔案現在做七件事,開頭的註解有列。
檔案二:k8s/alerts.yaml(新的)。放 PrometheusRule,也就是上面那兩條告警規則。
檔案三:alert-sink/(新的)。三十行的 webhook 接收器,加上 k8s/alert-sink.yaml 部署它。它跟 pricing 那三個服務共用同一份 Dockerfile,所以 build 的方式一樣。
順序很重要——alert-sink 要先起來,不然 Alertmanager 套用新設定之後會找不到收件人,log 裡會一直噴連線失敗:
# 1. 先把 alert-sink 蓋起來
docker build --build-arg SERVICE=alert-sink -t alert-sink:0.1 .
kind load docker-image alert-sink:0.1 --name obs
kubectl apply -f k8s/            # alert-sink.yaml 和 alerts.yaml 都在這個目錄

# 2. 再套用 Prometheus / Alertmanager 的設定
helm upgrade kps prometheus-community/kube-prometheus-stack -n monitoring --version 90.0.0 \
  -f helm/kube-prometheus-stack-values.yaml
第二道指令會重啟 Prometheus 和 Alertmanager。Grafana 這次不會動,因為 Day 20 已經給它掛了 PVC——那天掉東西的教訓在這裡就回本了。
等 Pod 都起來(kubectl get pods -n monitoring),確認三件事:
# 規則被 Operator 撿走了嗎
kubectl get prometheusrule -n monitoring | grep checkout-slo

# 誤報清掉了嗎
kubectl port-forward -n monitoring svc/kps-kube-prometheus-stack-alertmanager 9093:9093

# 新規則載入了嗎(Prometheus 的 Alerts 分頁)
kubectl port-forward -n monitoring svc/kps-kube-prometheus-stack-prometheus 9090:9090
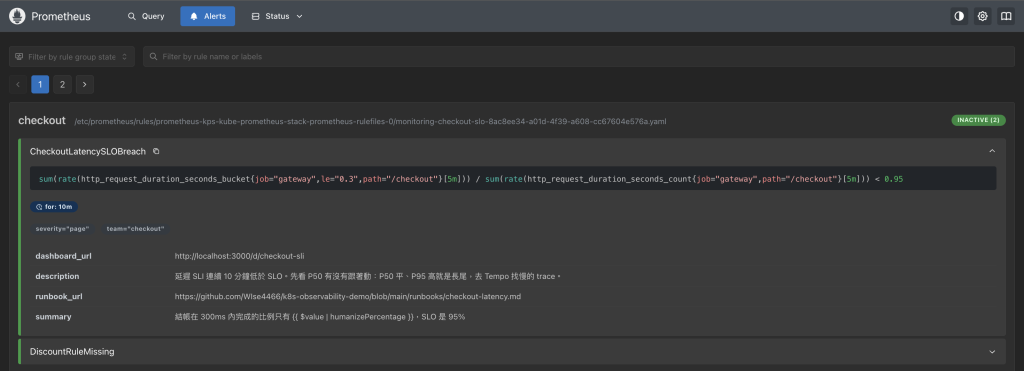
checkout 這一組右上角是 INACTIVE (2),兩條規則都載入了,條件都不成立——故障全關著,SLI 是健康的。展開之後 expr、for: 10m、兩個 labels、四個 annotations 全部照著 yaml 寫的顯示出來,這是確認「Operator 真的撿走了」最快的地方。
想看它變 Firing,把故障二打開等十分鐘,或者直接把 pricing 縮到零讓結帳整個壞掉。
再看 Alertmanager,這裡有個會讓人困惑的時間差。 我關掉規則之後馬上去看,那 14 則還在,只是 receiver 從 null 變成了 default——設定明明生效了,告警卻沒消失。
原因是 Prometheus 和 Alertmanager 對「告警結束」的認知不同步。Prometheus 那邊規則被刪掉就不再送了,但 Alertmanager 不知道「不再送」和「還沒送到」的差別,它會等 resolve_timeout(預設 5 分鐘)沒有續約才把告警清掉。等五分鐘再看就對了:
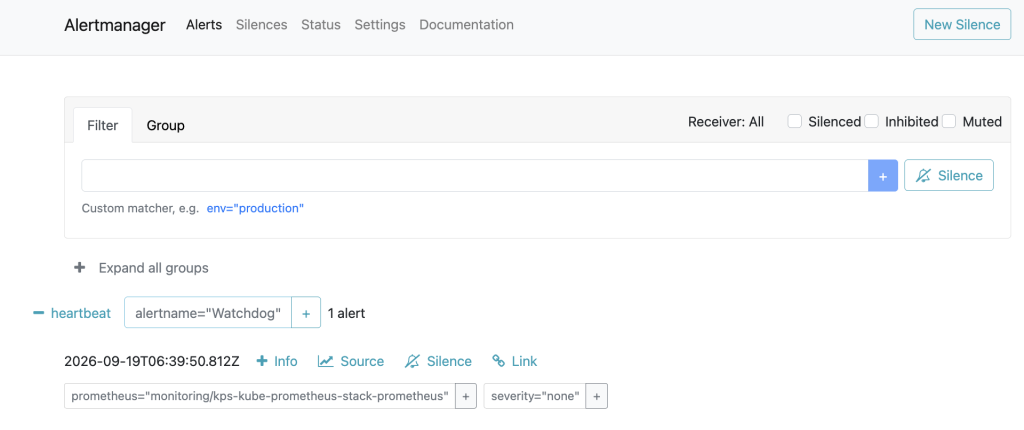
只剩 Watchdog,而且左邊的 receiver 從 null 變成了 heartbeat。這是十三天以來 Alertmanager 第一次只顯示一則我看得懂的東西。
路由樹一複雜就很難用肉眼推,而設錯的症狀是「送到錯的地方」或「根本沒送」——又是靜默失敗。Alertmanager 附一個 CLI 叫 amtool,Pod 裡就有:
kubectl exec -n monitoring alertmanager-kps-kube-prometheus-stack-alertmanager-0 -c alertmanager -- \
  amtool config routes --alertmanager.url=http://localhost:9093
這個指令要 kubectl exec 進 Alertmanager 的容器裡跑,amtool 不在你的電腦上。套用之前跑一次,長這樣:
Routing tree:
.
└── default-route  receiver: null
    └── {alertname="Watchdog"}  receiver: null
兩條路由、兩個 null——前面講的「預設把所有告警丟掉」在這裡是畫出來的。套用之後:
Routing tree:
.
└── default-route  receiver: default
    ├── {alertname="Watchdog"}  receiver: heartbeat
    ├── {severity="page"}  receiver: urgent
    └── {severity="ticket"}  receiver: tickets
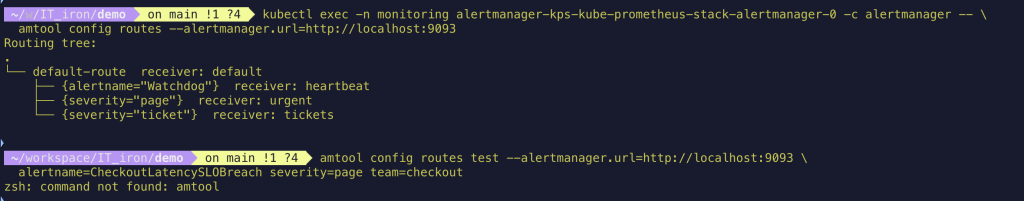
還可以直接問「這組標籤會送去哪」,一樣要包在 kubectl exec 裡:
kubectl exec -n monitoring $AM -c alertmanager -- \
  amtool config routes test --alertmanager.url=http://localhost:9093 \
  alertname=CheckoutLatencySLOBreach severity=page team=checkout
# → urgent

kubectl exec -n monitoring $AM -c alertmanager -- \
  amtool config routes test --alertmanager.url=http://localhost:9093 \
  alertname=DiscountRuleMissing severity=ticket team=pricing
# → tickets
我第一次跑的時候四組標籤全部回 default,以為路由沒生效。後來發現是我把多組標籤寫在同一個引號裡,amtool 當成一個標籤名在比對。測試工具本身也會騙你,看到不合理的結果先懷疑指令打錯了。
null,告警全部丟掉,而且不會有人告訴你明天回答一個更根本的問題:門檻到底該設多少?答案不是拍腦袋,是從 Day 2 訂的 SLO 反推。


 iThome鐵人賽
 看影片追技術