
最後一個區塊。先問一個我一直不太敢問的問題:
如果我的筆電現在壞掉,我重建得出前面二十六天的環境嗎?
我原本準備好的答案是「不行」,然後從這句話開始寫今天這篇。但寫之前我去查了一遍,結果跟我以為的不一樣。
叢集裡有五個用 Helm 裝的東西。我把每一個的「叢集裡實際的設定」抓出來,跟 repo 裡的檔案比對:
| 裝的東西 | 檔案在 repo 裡嗎 | 差異 |
|---|---|---|
| kube-prometheus-stack | ✓ helm/kube-prometheus-stack-values.yaml |
零 |
| Alloy | ✓ helm/alloy-values.yaml |
零 |
| OpenTelemetry Collector | ✓ helm/otel-collector-values.yaml |
零 |
| Loki | ✗ | — |
| Tempo | ✗ | — |
前三個逐層比對下來,叢集有而檔案沒有的設定:0 個。檔案有而叢集沒有的:0 個。兩邊值不一樣的:0 個。
這比我以為的好太多。原因不是我有紀律,是痛過——Grafana 那次 helm upgrade 把十天的儀表板和資料源全部洗掉,從那之後我就把設定往檔案裡搬。
有一個詞叫設定漂移(configuration drift):實際狀態慢慢偏離你以為的狀態。剛才那三個零,就是「目前沒有漂移」的意思。
但盤點也照出三個洞,而且它們剛好都會讓重建停在很前面的地方。
一、Loki 的設定只存在叢集裡。 裝它的時候我用的是 --set 打在指令列上,沒寫成檔案。那串設定包含單機模式、關掉三個快取、複本數設成 0——這些是我為了塞進 kind 一個個試出來的。現在它們只活在我的指令歷史和叢集裡,repo 裡一個字都沒有。
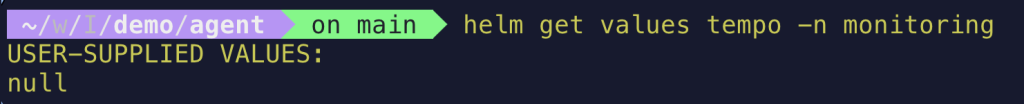
二、Tempo 完全沒有設定。 這聽起來不是問題,全預設嘛。但「預設」不是固定值,它是那個版本的 chart 的預設。下個版本作者改了預設,我重建出來的東西就跟現在不一樣,而且不會有任何地方提醒我。
三、版本沒有鎖。 五個 chart 裡只有一個在註解裡留了 --version 90.0.0,其他四個完全沒記。我現在跑的是哪幾版?要下 helm list -A 才知道:
NAME             CHART                             APP VERSION   UPDATED
alloy            alloy-1.12.1                      v1.19.2       2026-09-12
loki             loki-7.3.0                        3.6.12        2026-09-12
tempo            tempo-1.24.4                      2.9.0         2026-09-14
kps              kube-prometheus-stack-90.0.0      v0.93.1       2026-09-19
otel-collector   opentelemetry-collector-0.173.1   0.160.0       2026-09-24
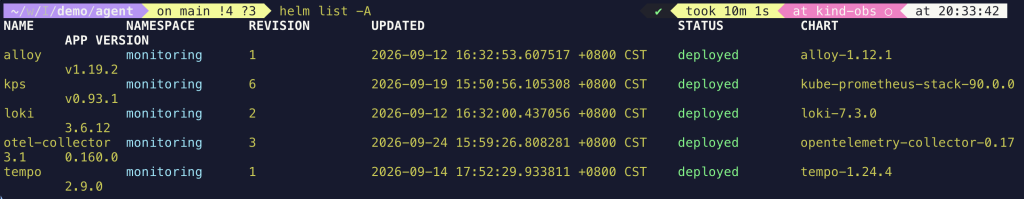
這串數字目前只存在於叢集裡。 叢集沒了,它們就沒了,我只能裝到最新版,然後祈禱設定還相容。而這個洞會無聲地失效:重建的指令會跑完、Pod 會 Running、你以為成功了,實際上裝的是另一版的東西。
這張表還有兩件事值得看。
每個 release 有兩個版本號。 alloy-1.12.1 是 chart 的版本,v1.19.2 是 Alloy 這個程式本身的版本。要鎖的是前者——chart 裡面寫死了它要用哪個映像檔標籤,所以鎖住 chart 就等於鎖住程式。但看懂這兩欄的差別很重要,不然去查文件的時候會查錯版本。
最右邊那欄是安裝日期。 9/12 裝了兩個、9/14 一個、9/19 一個、9/24 一個——這套環境是分五次、跨十二天長出來的,中間還有 kps 改了六版、Collector 改了三版。沒有人會記得這個順序,而順序是有影響的:Collector 要有 Tempo 才送得出 trace,ServiceMonitor 要有 Operator 的 CRD 才 apply 得上去。
這種靠一連串手動操作養出來、沒有人做得出第二個的機器,有一個名字叫雪花伺服器(snowflake server)——每一片雪花都獨一無二。
我的狀況是半片雪花:主體可以重建,但有幾個零件只存在我的記憶和這台機器裡。而半片雪花跟整片雪花一樣重建不出來,因為缺的那幾塊會讓你卡在第一步。
IaC(Infrastructure as Code,基礎設施即程式碼)的意思是:把「環境長什麼樣」寫成檔案,而不是靠人手動操作。
| 手動 | IaC | |
|---|---|---|
| 怎麼建立 | 打指令、點網頁 | 寫檔案,執行工具 |
| 現在的設定是什麼 | 得連上去查 | 讀檔案就知道 |
| 誰改的、為什麼 | 不知道 | git 紀錄 |
| 重建 | 憑記憶重來一次 | 執行同一份檔案 |
| 出事回滾 | 靠記憶還原 | git revert |
還有一個關鍵性質:宣告式(declarative)。你寫的不是「先做這個、再做那個」的步驟,而是「我要的結果長這樣」,工具自己算出該做什麼。
這個概念前面其實一直在用,只是沒點名。kubectl apply -f k8s/ 就是宣告式的——我沒告訴 Kubernetes「建立 Pod、再建立 Service」,我給它一份「我要有這些東西」的清單,它自己比對現況然後補差額。所以同一個指令跑第二次不會出錯,也不會建出第二份。
這就是為什麼重建可以是安全的。 一個宣告式的檔案跑十次跟跑一次結果一樣。
IaC 對什麼系統都有用,但監控有三個額外的理由。
一、監控是災難復原的前提。 叢集掛了要重建,那你怎麼知道重建成功了?看監控。但監控也在同一個叢集裡,它也掛了。所以順序是先重建監控,再用監控確認其他東西有沒有好。如果監控本身要花三天手動重建,那三天你是瞎的。
二、告警規則是會寫錯的程式碼。 burn rate 那條規則的門檻是 14.4,公式有兩個時間窗,還有一個 for。這種東西寫錯不會報錯,只會在該叫的時候不叫。放進 git 之後它至少能被看、被討論、被追溯——我自己就在寫的時候把 predict_linear 兩邊的向量比對寫錯過,規則一邊 firing 一邊 health=err,畫面上看不出來。
三、儀表板最容易漂移。 Grafana 的圖是存在它自己資料庫裡的,大家在網頁上隨手拖一下、加個面板,半年後沒人知道原本長什麼樣,也沒人敢動。我已經把兩張儀表板寫成 ConfigMap 了,那是被洗掉一次之後學到的。
還有一個很小但很具體的理由:那個漏掉就靜默失敗的 release 標籤。ServiceMonitor 少了它,Prometheus 不會抓、也不會抱怨。寫成檔案之後我至少可以 grep 一遍確認每個都有。手動設定沒辦法被 grep。
寫到這裡要先講清楚一件事,不然最後一天的驗收會期待錯:IaC 重建的是設定,不是資料。
叢集裡現在有三個 PVC:
| 大小 | 建立至今 | 裡面是什麼 | |
|---|---|---|---|
| Prometheus | 5Gi | 9 天 | 9.2 天的指標 |
| Loki | 10Gi | 12 天 | 這段時間的所有 log |
| Grafana | 2Gi | 9 天 | 儀表板、資料源、使用者 |
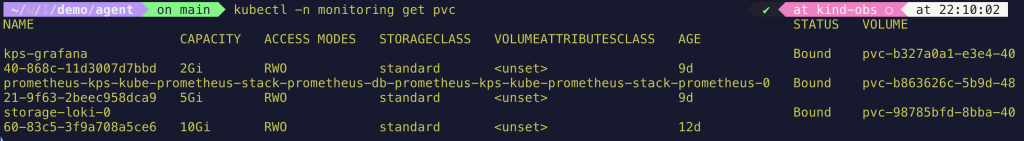
Loki 的比另外兩個老三天,這件事本身就是那次意外的痕跡:Loki 從一開始就有持久化,Prometheus 和 Grafana 是被洗掉之後我才補上的。
砍掉叢集重建之後,Grafana 那 2Gi 會被檔案還原回來(儀表板是 ConfigMap、資料源在 values 裡),但前兩個不會。九天的指標歷史就是沒了,Loki 裡的 log 也是。
這不是 IaC 的缺陷,是它本來就不管這件事。設定和資料是兩個問題,資料要靠備份或遠端儲存,那是另一個題目。
還有兩樣東西也不在檔案裡:
Grafana 的管理員密碼。 values 檔沒有指定,所以 chart 每次安裝都隨機產生一組放進 Secret。重建之後密碼會變,得重新去撈一次。這其實是好事——密碼不該寫進 git。但它意味著「重建完就能照舊登入」這個期待是錯的。
三個故障的當下狀態。 開關本身寫在 k8s/*.yaml 裡,預設全部是關的;我平常是用 kubectl set env 臨時打開來示範。那個臨時值不在任何檔案裡——這件事我在埋 trace 那天就記過一筆:kubectl apply -f k8s/ 會把 set env 改的東西蓋回預設。所以重建之後三個故障都是關的,要重新開。
這個其實是對的設計:檔案記錄的是「正常狀態」,不是「我現在正在示範什麼」。
所以驗收的標準要講清楚:重建出來的是一套空的、乾淨的、設定完全一樣的環境,不是現在這套的複製品。
我不打算用一個工具管全部,因為它們解決的問題不一樣:
| 工具 | 管什麼 |
|---|---|
| kind 設定檔 | 叢集本身。這個從第五天就已經是檔案了 |
| Helm / Helmfile | 叢集裡面裝了哪些東西、版本是多少 |
| Terraform | 叢集外面的東西,以及 Grafana 裡面的設定 |
第三列最容易搞混。為什麼 Grafana 的儀表板要用 Terraform 管,不是 Helm?
因為儀表板不是 Kubernetes 資源。Helm 裝的是 Grafana 這個程式,管得到它的 Pod、Service、設定檔,但管不到它資料庫裡存的圖。Terraform 有 Grafana 的 provider,直接打它的 API。
一句話:Helm 管「裝什麼」,Terraform 管「裝完之後裡面設定成什麼樣」。
我一開始完全搞不懂為什麼需要兩個工具,覺得是生態系太亂。實際卡過一次才明白——它們的操作對象根本是不同層的東西。
(我現在的儀表板是用 ConfigMap 加一個 sidecar 載進去的,那是 Helm 這一側的做法。明天會拿 Terraform 的做法跟它對照,兩種都可行,差別在誰是那份設定的權威來源。)
這兩個詞常被混在一起,但它們是不同層次的事。
IaC 是「把設定寫成檔案」。GitOps 是再往前一步:叢集裡跑一個程式(例如 ArgoCD),持續盯著 git repo,發現不一致就自動把叢集改回檔案上的樣子。
GitOps 很好,但我不做,兩個理由:它是多一個要學的元件,也是多一個會壞、需要被觀測的東西;而我的主軸是可觀測性,不是部署流程。
可以只做 IaC 不做 GitOps。 差別是「改了檔案之後要自己去執行」而不是「它自己會同步」。對一個一台筆電上的 kind 叢集,手動執行完全夠用。
剩下的三天是這樣分的:
先把 Grafana 裡面的設定交給 Terraform 管,那是唯一一個「裝完之後還要再設定一次」的元件。接著用 Helmfile 把五個 helm install 收成一個檔案,順便把剛才那三個洞補起來——Loki 的設定、Tempo 的顯式設定、還有五個版本號。
最後一天是砍掉整個叢集,用這些檔案從零重建一次。
那天是這三十天唯一一個成功或失敗很明確的檢查點。我沒有考證照,所以沒有外部的人來驗收我這一個月到底學到什麼,那就自己造一個:指令跑完之後,Grafana 上那幾張圖如果長回原來的樣子,就算數。
明天開始動手,第一個對象是 Grafana。


 iThome鐵人賽
 看影片追技術