
最後一天。今天只做兩件事:砍掉重建,然後回答第一天答不出來的那個問題。
先把標準訂死,免得事後幫自己找藉口:
helm uninstall 沒刪掉 PVC 已經說明了移除 release 有多不乾淨動手前我先確認一次「要用到的東西都在 repo 裡嗎」,結果第一項就掛了:
kind-config.yaml ✗ 沒進版控
它一直放在 repo 外面的上層目錄。我自己跑沒問題,但 clone 這個 repo 的人拿不到它,第一步就做不了。
前天盤點的時候我把它列成「叢集本身 ✓ 已經是檔案」。那句話只對了一半——是檔案,不代表在別人拿得到的地方。
這件事有點諷刺:整個 IaC 區塊在講「把東西寫成檔案」,而最底層那個檔案從頭到尾不在 repo 裡。我把它搬進去才開始。
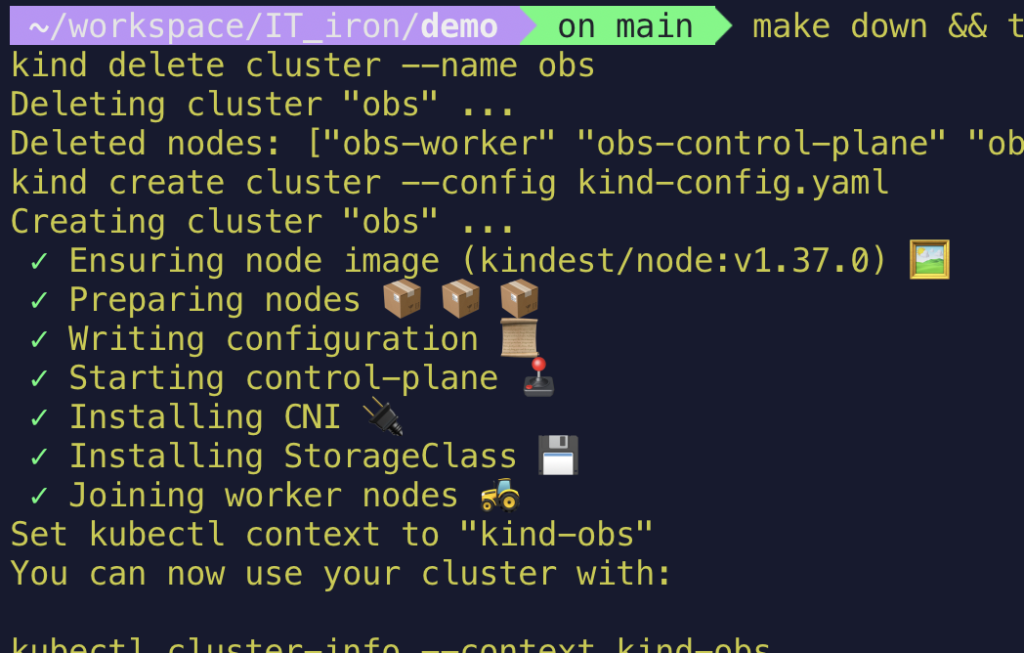
kind delete cluster --name obs
Deleting cluster "obs" ...
Deleted nodes: ["obs-worker" "obs-control-plane" "obs-worker2"]
九秒。 二十九天的東西,三行輸出。
打這行的時候比我想像中緊張——不是怕重建不出來,是因為那裡面有九點八天的指標、十二天的 log,而那些東西確實不會回來。
回來的部分靠一個 Makefile,六個步驟串起來:
up: cluster images load charts services grafana

cluster:
	kind create cluster --config kind-config.yaml

images:
	docker build --build-arg SERVICE=pricing -t pricing:$(TAG) .
	# catalog / gateway / alert-sink / loadgen 同樣四行

load:
	kind load docker-image pricing:$(TAG) catalog:$(TAG) ... --name $(CLUSTER)

charts:
	helmfile apply --skip-diff-on-install

services:
	kubectl apply -f k8s/
	kubectl apply -f grafana/
順序有兩個地方不能換:
load 一定要在 images 之後。 kind 的節點是獨立的容器,看不到你本機的 Docker 映像檔。少這步就是 ErrImagePull。
services 一定要在 charts 之後。 k8s/servicemonitors.yaml 裡的 ServiceMonitor 是 Prometheus Operator 帶進來的 CRD,Operator 還沒裝就 apply,會噴 no matches for kind。
make down && time make up
第一次跑,helmfile 那步直接掛掉:
no matches for kind "Alertmanager" in version "monitoring.coreos.com/v1"
ensure CRDs are installed first
Error: plugin "diff" exited with error
helmfile apply 的預設流程是先 diff 再 apply。而 diff 要把 chart 渲染成 YAML、再拿去跟叢集的 API 對照有沒有這些型別——但 Alertmanager、ServiceMonitor 正是這個 chart 要裝的 CRD,全新叢集上還不存在。
要裝 CRD 才能 diff,要 diff 完才會裝 CRD。
解法是 --skip-diff-on-install:第一次安裝的 release 跳過 diff 直接裝,已經存在的照樣 diff。
這個坑昨天完全遇不到,因為那時叢集已經在,五個 release 都是「已存在」。它只在從零開始時出現——這就是為什麼「應該可以重建」跟「真的重建過一次」是兩件事。
修好之後再跑,這次走到最後一步才掛:
kubectl wait --for=condition=ready pod -l app.kubernetes.io/name=grafana --timeout=600s
error: timed out waiting for the condition
make: *** [grafana] Error 1
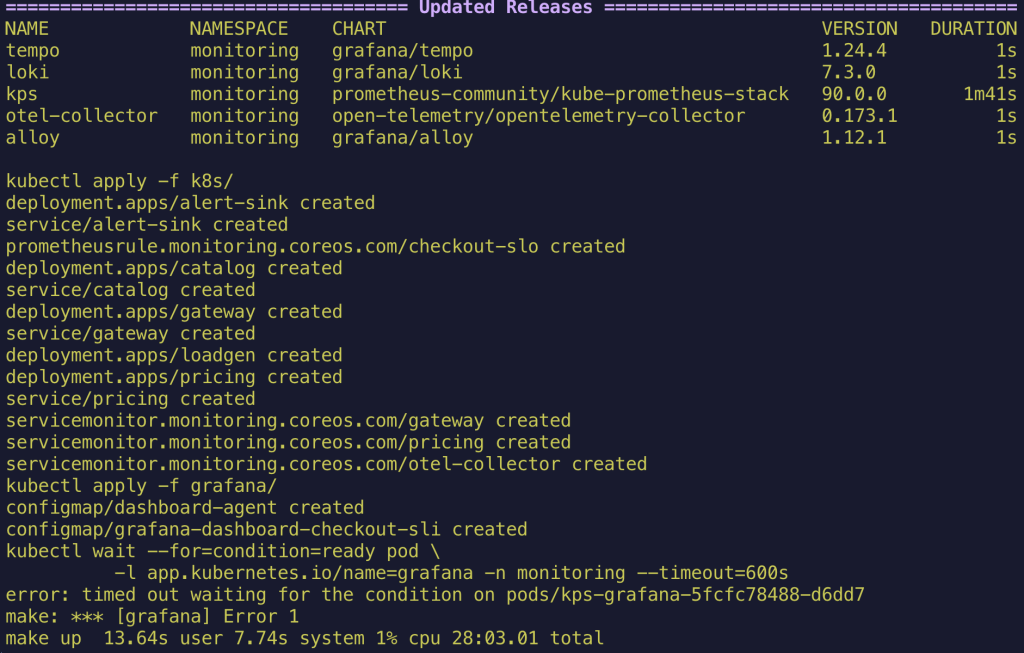
我在 Makefile 裡寫 600 秒,自認很寬鬆了。實際上不夠——Grafana 有三個容器、Prometheus 和 Alertmanager 各有 init 容器,全部要從公開 registry 拉映像檔。
這不是設定寫錯,是我對環境做了一個錯的假設。 腳本裡每一個逾時值都是一個假設,而它只在你自己的網路上被驗證過。
另一個坑在後面等著。那天的網路很差,四個映像檔一直 ImagePullBackOff。換到另一個地方(實測 12.5 Mbps)之後,我以為等一下就好,結果二十五分鐘沒有任何進展。
兩個原因:
主機端那個 docker pull 還抓著換網路前的 TCP 連線,它不會知道底下的網路已經換了,只會一直等一個永遠不會回來的回應。
Kubernetes 的退避機制在拖時間。 ImagePullBackOff 每失敗一次就把下次重試的間隔拉長,最長到五分鐘。所以網路好了之後,它可能還要等好幾分鐘才會再試一次。
解法很粗暴但有效:
kubectl delete pod <那幾個> --force --grace-period=0
新的 Pod 沒有退避歷史,立刻重拉。 兩分鐘之內全部起來。
make up 13.64s user 7.74s system 1% cpu 28:03.01 total
這個數字裡最值得看的是 1% cpu。
二十八分鐘裡,我的電腦幾乎沒在工作。五個自己的映像檔全部 CACHED、五個 chart 裝起來最久的 kube-prometheus-stack 也只要 1 分 41 秒。剩下的全部是等——等從公開 registry 把別人的映像檔拉下來。
所以「一鍵重建要多久」這個問題,答案跟你的 IaC 寫得好不好幾乎無關,取決於你跟 registry 之間那條線。正式環境會用內部 registry 鏡像解決,那是我這個系列沒做、但真的要重建時第一個會遇到的問題。
make verify
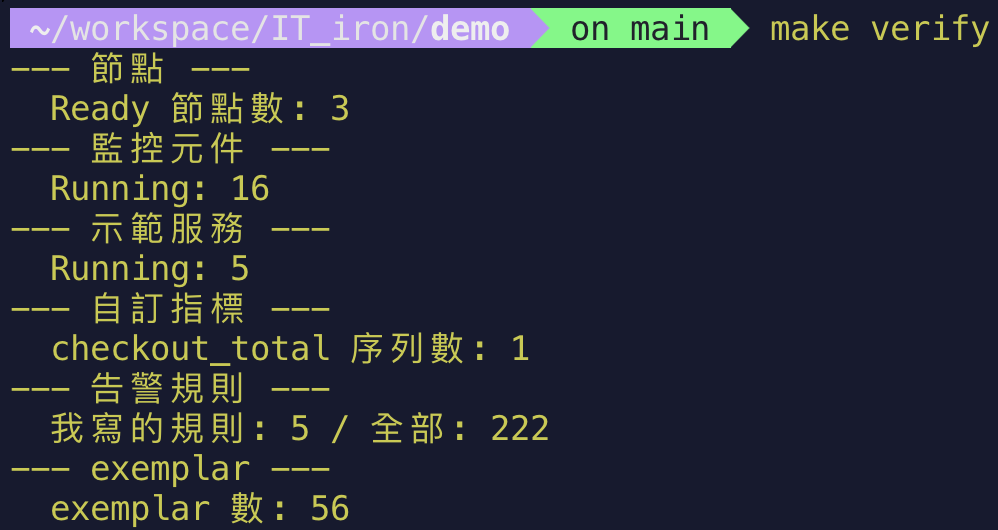
| 檢查 | 結果 |
|---|---|
| 三節點 Ready | 3 |
| 監控元件 Running | 16 |
| 示範服務 Running | 5 |
| 自訂指標 | checkout_total 有資料 |
| 我寫的告警規則 | 5 條 |
| exemplar | 56 個 |
最後兩項是我在驗收過程中改出來的。
告警規則那項原本只印「規則數:222」,看起來像我寫了 222 條。其實 217 條是 kube-prometheus-stack 自己帶的,我的只有 5 條。一個寫來確認系統沒問題的腳本,自己在誤導——跟昨天那個「diff 說沒差異但東西不在」是同一種毛病。
exemplar 那項本來不在清單裡,是看到儀表板上有綠色的點才想到要加。它其實是最該檢查的一項:exemplar 沒接起來的時候不會報錯,圖照樣畫得出來,只是少了那些點。 Day 20 就是在這裡卡了很久。
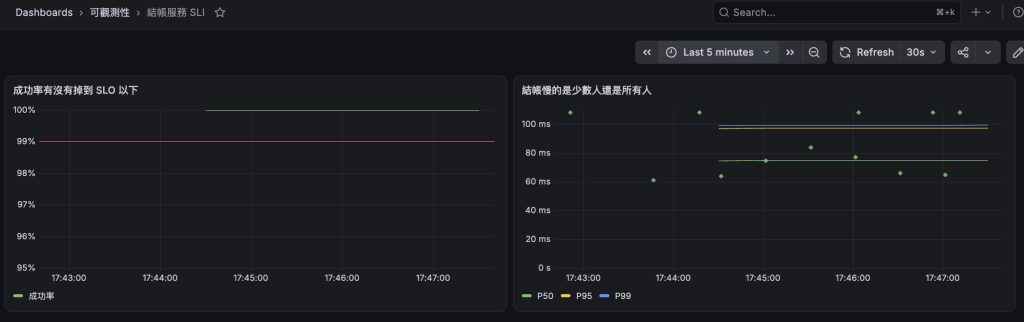
儀表板回來了,在「可觀測性」資料夾裡——那個資料夾是 OpenTofu 建的,圖是 ConfigMap 送的,兩邊靠一個名字接上。
但重點不是它出現了,是它上面的線在動。成功率 100%、P50 / P95 / P99 三條線分開、右邊那些綠色菱形是 exemplar。從指標點進 trace 那條路,重建之後也是通的。
Pod 是綠的只代表東西起來了。線在動才代表資料真的在流。
最後一項:把故障一打開,看系統抓不抓得到。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=true
等了二十五分鐘,Alertmanager 還是只有 Watchdog。去查規則狀態,它是 pending,但 activeAt 是 18:09:44——比我開故障的 17:46 晚了二十三分鐘。
原因在資料裡:
18:09:31 0.078 ← 資料中斷
22 個取樣點沒有任何一點是 0,pricing 也沒重啟。是 Prometheus 有一段沒抓到,時間點剛好是我換網路那段。
for: 15m 的意思不是「故障開始後 15 分鐘」,是「條件連續成立 15 分鐘」。 中間只要斷一次,計時就歸零重來。
我是去查了 activeAt 才知道它重新算過。只盯著 Alertmanager 等的話,會以為告警壞了。
18:25:18,它燒起來了:
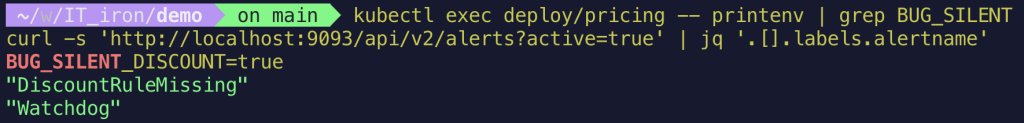
上面那行證明故障真的開著,下面那行證明系統真的抓到了。從零重建的環境、埋回同一個故障、同一條規則同樣攔下來。
驗收通過不代表一切如初。誠實列出來:
| 回來了嗎 | |
|---|---|
| 所有設定、儀表板、告警規則 | ✅ |
| 九點八天的指標歷史 | ❌ |
| 十二天的 log | ❌ |
| Grafana 管理員密碼 | ❌ 換了一組新的 |
| 三個故障的開關狀態 | ❌ 回到全部關閉 |
IaC 重建的是設定,不是資料。 這不是它的缺陷,是它本來就不管這件事。
密碼換掉其實是好事——它代表密碼沒有寫進 git。但它也意味著「重建完就能照舊登入」這個期待是錯的。
Day 7 我只用 kubectl 查那三個故障,每次都收在一句「查不到」:
| 天花板 | 被誰解決 | 重建後還在嗎 |
|---|---|---|
| 只有現在,沒有歷史 | Prometheus | ✅ |
| 只有文字,不能聚合 | Loki + LogQL | ✅ |
| 只有單點,無法跨服務關聯 | OpenTelemetry + exemplar | ✅ |
| 只能被動查,不會主動通知 | Alertmanager + burn rate | ✅ |
四句話對應四個工具,重建之後四個都還在。
這張表是這個系列真正的骨架。不是「我裝了幾個工具」,是「我原本答不出什麼,現在答得出來」。
第四天我列了五件刻意不做的事。回頭看,其中兩件真的有後果:
不做 ingress、一律用 port-forward。 這個決定後來咬了我兩次:Collector 的接收埠預設綁在 Pod IP 上,port-forward 打不進去,第一次遇到我繞過去了,等到 agent 要從叢集外送資料才不得不改成 0.0.0.0。
不上雲。 這個影響更深——它讓「用 Terraform 管叢集外資源」那天幾乎沒有對象可管。我沒有雲,所謂的「叢集外」只剩 Grafana 裡面的東西。那天的產出因此變成一個判斷(誰該管什麼),而不是一套設定。
另外三件(不做 service mesh、不做 profiling、示範服務不寫漂亮)到最後都沒有讓我後悔。
第一天的開頭是這樣寫的:
前陣子在求職的時候常常被問到 k8s 相關的問題,觀測的指標有哪些,但我總是一問三不知,只能說出查看 log 有沒有 error。
現在的答案:
先看 SLI。 成功率和延遲有沒有違反承諾。這一步告訴我有沒有事、多嚴重、從什麼時候開始。
如果是慢,看 P50、P95、P99 的形狀。 三條一起漲是全面性問題;只有 P99 漲是長尾,代表只有少數請求受影響——而那個形狀本身就是線索。
從圖上的異常點直接跳進 trace,看那棵 span 樹哪一段最耗時,再從那個 span 跳到對應的 log。三次點擊。
如果指標全部正常但使用者說有問題,那是最難的一種:系統在成功地做錯事。這時候只能翻 log,用 count_over_time 算出它多常發生、影響多少比例。
而當初那句「只能說出查看 log 有沒有 error」,現在我知道它其實不算全錯——錯的是把 log 當成唯一的工具。log 回答「發生了什麼」,指標回答「多嚴重」,trace 回答「在哪一段」。三個問題本來就需要三種東西。
第一天我還寫下一句沒把握的話,說要搞清楚監控和可觀測性的差別。三十天後我的答案是:監控是你事先決定要看什麼,可觀測性是你事後還能問出沒想過的問題。 而這兩者之間有一條路——用 log 發現未知、確認它重要、埋成指標、設成告警,它就從此變成已知。這條路不會走完,因為系統一直在變。
這些不是謙虛,是這個系列的邊界。哪些部分我真的驗證過、哪些只是照著文件做,讀者應該分得出來。
謝謝看到這裡的人。如果你要自己跑一遍,最有價值的部分不是那些成功的指令,是我卡住的那幾段。


 iThome鐵人賽
 看影片追技術