
我把工具內建的自動記憶整個關掉了,然後在同一套系統裡養了一個累積到 14612 筆(2026-09-20 測)的自製記憶系統。這兩件事聽起來互相矛盾,但它們是同一個判斷的兩面:我不要「自動出現」的記憶,我要「查得到」的記憶。
Day 10 結尾留下的缺口是「結束等於失憶」——中層經理跑完一輪就結束,它知道的事跟著沒了。今天要講的是,解掉這個缺口的東西根本不叫記憶,叫持久狀態;而把兩者混為一談,正是我付過學費的地方。
工具本身有一套自動記憶:它會把它覺得重要的事寫成檔案,下次啟動時自動讀進來。聽起來完全是我要的。
實際發生的是檔案越積越多。主控規則檔裡明文記著拔除的理由(這是文件自述、不是我這次重跑的實測):實際曾累積到 39 個檔案,而且每個 session 都要重付一份約 2.6KB 的舊索引。2.6KB 單看很小,問題在「每個」和「每次」——那不是一次性成本,是每開一個 session 就先繳一次的入場費,而且照這個機制推測,會隨著檔案變多而越來越大。更難受的是它的內容不受我控制:寫進去的是模型當下覺得重要的東西,不是我認定該留的結論。
於是 2026-09-12 我把它整個拔掉,而且做成雙保險:設定層有一個關掉自動記憶的開關,啟動腳本每個 session 都會強制還原成關閉;環境變數層再關一次。啟動腳本另外會在每次入口啟動前,把自動記憶的資料夾清空。
這次盤點我實測驗證了「拔除後不再累積」:掃過抽樣的 11 個專案目錄,每一個都回傳 0 個檔案。要誠實說清楚的是,我沒辦法重建拔除前那 39 個檔案的歷史狀態,我只驗證了「現在是空的」。
拔掉自動記憶不等於接受失憶。真正留下東西的是另外兩層,而它們記的東西性質完全不同。
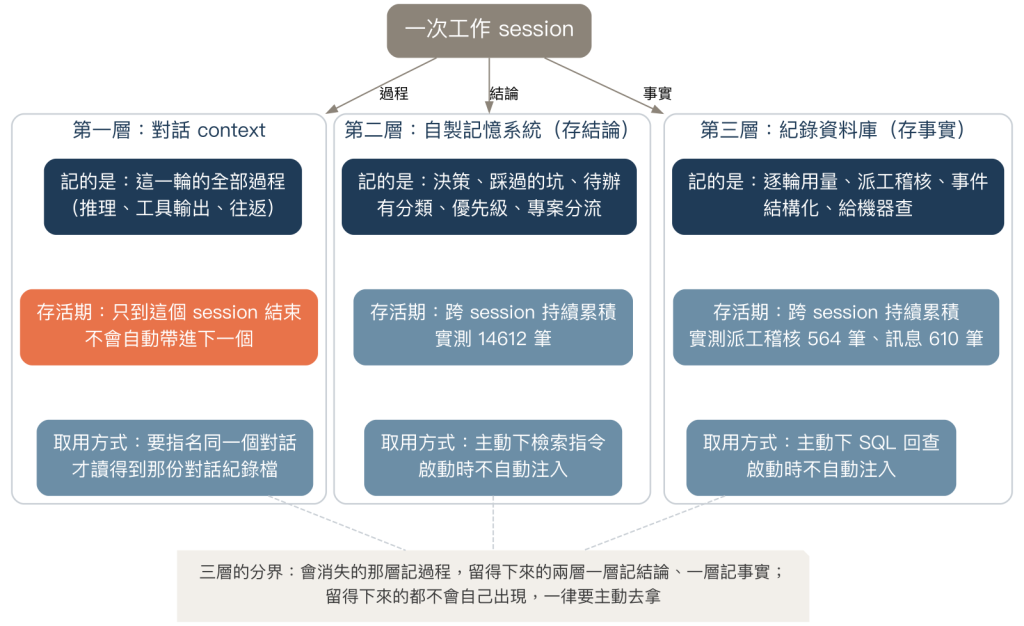
三層的分界很乾脆:會消失的那層記過程,留得下來的兩層一層記結論、一層記事實。每一層最後一格的「取用方式」才是今天真正的重點。
自製記憶系統記的是結論。 每筆記憶有分類、優先級、專案分流——同一套系統要同時服務好幾條工作線,沒有分流就會互相污染。目前實測的分類分布是:進度(progress)6594 筆、筆記(note)4786 筆、決策(decision)1745 筆、待辦(task)653 筆、錯誤(error)465 筆、警告(warning)369 筆,合計 14612 筆。值得注意的是決策和錯誤合計 2210 筆,約佔全表 15%——在我自己的用法裡,這兩類最常被回頭查,一筆決策或一個踩過的坑,比一筆進度紀錄更常派上用場。
它的呈現格式也是為人設計的。設計註解寫得很直白:標題只放圖示和分流標記、內文只放內容,因為分類名稱和索引鍵在手機上就是雜訊。
紀錄資料庫記的是事實。 逐輪用量、派工稽核、訊息往返,全都是結構化欄位,給機器查的。這次盤點實測到派工稽核 564 筆、訊息紀錄 610 筆,都可以用 SQL 回查。兩者的差別不只是格式:記憶系統存的是「我後來決定怎麼做」,紀錄資料庫存的是「當時實際發生了什麼」。前者會被後來的判斷推翻,後者不會。
這兩層都沒公開,讀者無法調閱,我引用的數字只能當作單一環境的觀察。
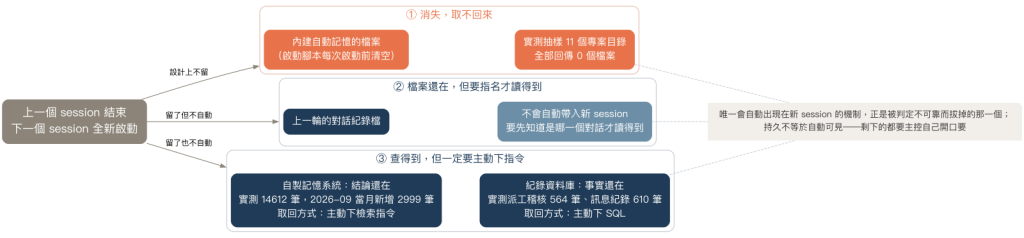
重啟之後的三種下場。注意第二類和第三類的共通處:東西都還在,但沒有一樣會自己走到新 session 面前。
把重啟當成切點重新盤一次,會看到一個很整齊的模式。
內建自動記憶:消失,而且是設計上就不留。對話 context 本身:不會自動帶進下一個 session,除非明確指名同一個對話,那份對話紀錄檔才讀得回來。自製記憶系統:存活,2026-09 當月就新增了 2999 筆,但要主動下檢索指令才拿得到,啟動時不會自動注入。紀錄資料庫:存活,但同樣要主動下 SQL。
排在一起,矛盾就浮出來了:凡是設計上持久的東西,都不會自動出現在下一個 session 的 context 裡;而唯一「會自動出現」的那個機制,恰好是被判定不可靠、已經拔掉的那一個。
我的判讀是,這不是巧合,是同一個取捨的兩端。至少在我用的這套工具上,自動注入要便宜,就只能塞少量、由機器決定內容的東西進去;要塞得準,就得有人知道自己在找什麼。所以我選的是後者:持久狀態負責「東西還在」,主控負責「開口要」。代價很清楚——失憶不會自己好,是我每次重新開工時主動查回來的。這也是為什麼收尾摘要那道程序不能省:session 結束前不寫結論,就沒有東西可以在下次被查到。
講了半天「查得到」,還得承認一件事:能查到,不代表查到的每個欄位都能用。
這套記憶系統的時間欄位就壞過。兩次批次遷移把更新時間整個壓平了——這次重新實測:建立時間早於 2026-04-01 的記憶共 1456 筆,其中 1437 筆的更新時間落在兩個遷移批次日期上,比例約 98.7%。放到全表 14612 筆來看,更新時間完全沒被動過的有 12921 筆,佔 88.4%(測量時間 2026-09-20)。
意思是:以這次的樣本看,偽影集中在遷移前的舊資料;這不代表 2026-04 之後的更新時間就一定可信。但只要我不記得這件事,隨手拿更新時間排序去找「最近改過什麼」,就會被那 1437 筆舊資料整個蓋掉。一個持久層自己的元資料壞了,它存的結論再正確也會被查不出來。
順帶一提,主控規則檔裡對這件事記的比例跟我這次重算的對不上,兩邊的分母定義可能不同——這種「文件跟實測有落差」的情況,本身就是持久狀態需要被稽核的理由。
而且到這裡,我解掉的只有結論那一半。結論是壓縮過的東西,過程細節全都在執行者手上——被派出去做事的那些 subagent,做完就散了。它們手上的東西怎麼交回來,是下一個真正的難題:交太少,我沒辦法驗收;交太多,就是 Day 10 說的那件事——原始資料進了主控的 context 就一路陪跑,我剛省下來的又吐回去。
明天處理的就是這條交接線:執行者該交什麼,主控該收什麼。
明日預告:Day 12|正規化回報:執行者交什麼、主控收什麼


 iThome鐵人賽
 看影片追技術