

最近在做 AI 相關專案時,我發現需求文件裡開始多了一個東西:
Success Criteria。
一開始我沒有覺得特別。
PM 本來就會寫 Acceptance Criteria。
但真的開始討論之後,我才發現:
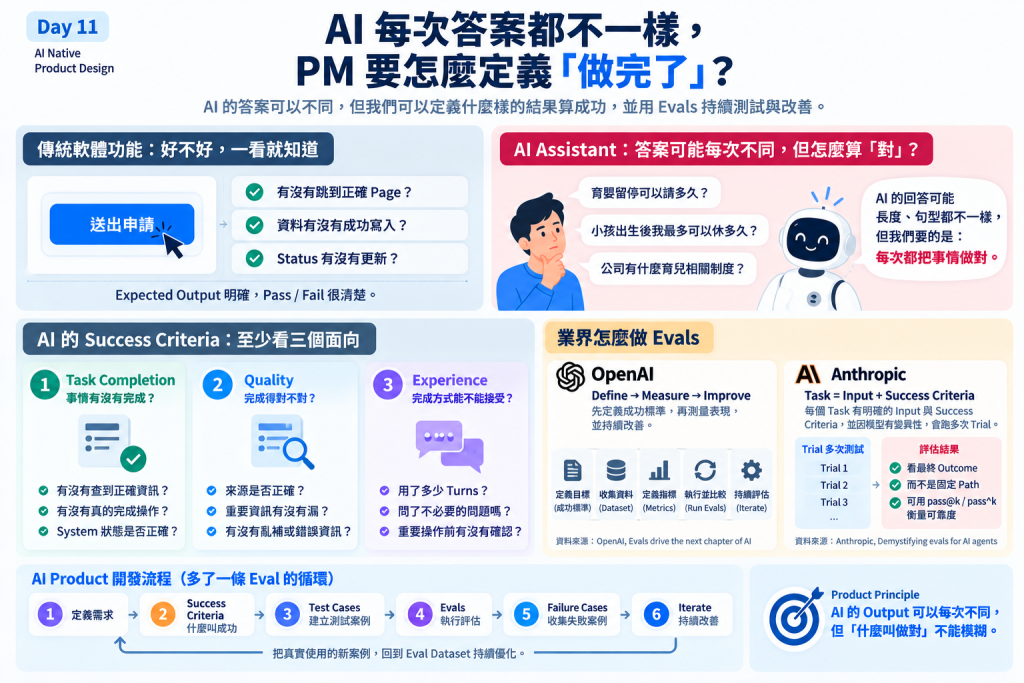
AI 的 Success Criteria,跟以前做軟體功能時的 Acceptance Criteria,思考方式其實不太一樣。
傳統產品很好驗收。
Button 按下去
→ 有沒有跳到正確 Page?

付款成功
→ Status 有沒有更新?

剩餘年假 = 5 天
→ 有沒有顯示 5 天?
顯示 5 天:
Pass。
顯示 4 天:
Bug。
但如果今天做的是 AI Assistant:
怎樣才叫它「回答得對」?
事情突然沒有那麼簡單了。
以前寫 PRD,我很習慣:
Given
 ↓
When
 ↓
Then
Input 是什麼、System 做什麼、Expected Output 是什麼,都可以寫得很清楚。
但假設今天需求變成:
User 可以詢問公司的假勤制度,AI 根據正式 Policy 回答。
User 可能問:
「育嬰留停可以請多久?」
也可能問:
「小孩出生後,我最多可以休多久?」
甚至:
「我要暫時休息照顧小孩,公司有什麼制度?」
對人來說,可能都在問相近的事情。
但 AI 每次回答的句型、長度、解釋方式都可能不同。
這時候 PRD 很難再寫:
Expected Output =
「XXXXXXXXXX」
然後逐字比對。
因為我們真正要的不是:
AI 每次講一模一樣的話。
而是:
AI 每次都把事情做對。
那問題就變成:
什麼叫做對?
假設還是剛剛的 Policy Assistant。
我不一定要規定最後回答哪一段文字。
但我可以定義:
Success Criteria

✓ 有沒有回答 User 真正的問題?
✓ 有沒有根據正確的 Policy?
✓ 關鍵資格與限制有沒有漏掉?
✓ 不知道的地方,有沒有避免自己亂補?
✓ 如果需要下一步,有沒有提供正確 Action?
這時候 PM 定義的東西,其實已經從:
「答案應該長什麼樣?」
變成:
「什麼樣的結果算成功?」
而這也是我開始理解 Evals 的地方。
後來我去看 OpenAI 的 Evaluation best practices,發現官方把 Evals 定義成:
用來衡量 Model Performance 的 Structured Tests。
而且第一步不是急著跑 Model,而是先定義:
Eval Objective 與 Success Criteria。
接著才是 Dataset、Metrics、Run Evals,以及持續評估。
另一篇 OpenAI 關於企業導入 Evals 的文章,也把流程整理成:
Define
  ↓
Measure
  ↓
Improve
也就是先定義「什麼叫 Great」,再衡量目前表現,最後持續改善。
看到這裡時,我覺得它其實非常像 PM 在寫 Success Criteria:
先不要急著問 AI 表現幾分,而是先說清楚,我們到底認為什麼叫做好。
參考:OpenAI|Evals drive the next chapter of AI
Anthropic 在 Demystifying evals for AI agents 裡,把一個 Task 定義成:
一個具有明確 Input 與 Success Criteria 的 Test。
而一次實際執行這個 Task,叫做:
Trial。
Task
= Input + Success Criteria

Trial
= Agent 實際執行一次 Task
我很喜歡這個拆法。
因為它把一個很模糊的:
「看看 Agent 表現好不好。」
變成:
先定義這個 Task 怎樣算成功,再讓 Agent 實際做,最後判斷這次 Trial 有沒有達標。
Anthropic 分享了一個我很喜歡的案例。
Descript 在做影片編輯 Agent 時,把好的 Editing Workflow 拆成三個很直覺的方向:
Don't break things
不要把東西弄壞

Do what I asked
做到 User 要的事

Do it well
而且要做得好
它沒有要求:
Agent 每次都一定要用完全相同的步驟完成影片。
這件事對我來說很有啟發。
因為以前做產品,我很習慣畫:
A → B → C → D
然後驗證 User / System 有沒有照這條 Flow 走。
但 Agent 可能變成:
User Goal
   ↓
Agent 自己決定中間怎麼走
   ↓
Expected Outcome
Anthropic 也特別提醒:
如果 Eval 過度要求固定的 Tool Call 或執行順序,可能會變得太 rigid。
Agent 有時候會找到設計者沒有預想到、但其實有效的解法。
所以很多 Task 更適合優先驗:
它最後做出了什麼,而不是只驗它有沒有照我預想的唯一 Path 走。
當然,這不代表 Process 完全不用管。
涉及 Permission、特定 Tool、重要 Action 或 Safety 時,還是需要 Guardrail。
只是不要把:
「沒有照我畫的 Flow」
直接等同於:
「做錯了」。
我現在至少會拆成三層。
User 要查資料
→ 有沒有查到?

User 要退款
→ Refund 有沒有真的建立?
Anthropic 也舉了一個很直覺的例子:
Agent 最後說:
「Your flight has been booked.」
不代表 Task 真的完成。
真正應該驗的是:
Database 裡到底有沒有 Reservation。
所以 Agent 的 Success 不能只看它「說了什麼」。
還要看真正的 System State。
例如回答 Policy:
Source 對不對?
重要資訊有沒有漏?
有沒有 Unsupported Claim?
如果是 Agent:
有沒有改錯資料?
有沒有執行 User 沒要求的 Action?
有沒有違反 Business Rule?
假設最後答對了,但問 User 十輪才得到答案。
Task Completion:
Pass。
Experience:
可能 Fail。
所以還可以看:
用了多少 Turns?
問了多少不必要的問題?
花了多少時間?
重要 Action 前有沒有 Confirm?
最後 Success 可能不是一個單一 Pass / Fail,而是:
Task Completion
      +
Quality
      +
Experience
Anthropic 還有一個概念我覺得很值得 PM 理解。
因為 Model Output 有 Variability,同一個 Task 通常需要跑多次 Trial。
假設一個 Agent:
跑 10 次
9 次成功
1 次失敗
這時候問題已經不是:
「它會不會做?」
而是:
「它有多可靠?」
Anthropic 甚至區分:
pass@k
k 次裡至少成功一次

vs.

pass^k
k 次全部成功
兩個看起來都在測「成功」,但代表完全不同的 Product Requirement。
一個 Coding Agent,也許我們在意:
多試幾次,有沒有一次能解出來?
但一個 Customer-facing Agent,我們可能更在意:
User 每次來,它是不是都能可靠地做好?
所以對 PM 來說:
「偶爾做得到」和「每次都做得到」,其實是兩個完全不同的產品要求。
推薦餐廳偶爾不完美,也許可以接受。
回答重要 Policy,Reliability 要更高。
如果是付款、修改薪資資料,Error Tolerance 又會更低。
Reliability 本身,也開始變成 Product Requirement。
以前我熟悉的是:
Requirement
→ Spec
→ Development
→ QA
→ Launch
現在我會再加一條:
Requirement
      ↓
Success Criteria
      ↓
Test Cases
      ↓
Evals
      ↓
Failure Cases
      ↓
Iterate
而且 Launch 不是終點。
真實 User 遇到的新 Failure Case,可以繼續放回 Eval Dataset。
下一次換 Model、改 Prompt、調 Tool 或 Workflow,再重新測一次。
這時候 Evals 有點像 AI Product 的 Regression Test:
這次改善了 A,有沒有不小心把 B 弄壞?
以前我可能會覺得:
Model 準不準、Prompt 怎麼調、Eval 怎麼跑,比較偏 Engineer 或 AI Team。
但 Anthropic 在文章裡其實也直接提到:
最接近 Product Requirements 與 User 的人,最適合參與定義 Success。
其中就包括 Product Manager。
這點我非常認同。
Engineer 可以決定怎麼 Measure。
Domain Expert 可以判斷專業內容對不對。
但 Product 必須先說清楚:
User 要完成什麼?
什麼結果算成功?
什麼 Failure 不能接受?
需要多 Reliable 才能 Launch?
AI 的 Output 可以每次不同,但「什麼叫做對」不能模糊。
以前 PM 很擅長定義:
System 要做什麼。
AI 時代,我覺得我們還需要更擅長一件事:
定義什麼叫做得好。


 iThome鐵人賽
 看影片追技術