
我盯著終端上同一輪的幾行字,每一行都帶著金額,而它們講的是同一筆錢。把它們加起來,我會得到一個比實際多出一截的數字——可是每一行單獨看都沒有錯。
Day 12 把回報收斂成一張正規化表格,主控終於可以只讀表格、不重讀原始資料。但表格回答的是「這個單元做完了沒」,它不回答「這一輪花了多少、誰在燒」。那是前一篇結尾留下的缺口:我手上有一整套可核對的結論,卻沒有任何一個地方告訴我代價。
缺口的第一版解法很直白:在每一輪收尾時,把這一輪的用量寫成一行紀錄——我叫它逐輪用量紀錄,一輪一行,落成檔案。這一行實際長這樣(節錄自本次盤點當下的紀錄尾行,session 代號以 S 表示):
S t01 fable-5-1 calls 16+ 7sub out 36,999(th 12,368) | 本輪 $ 8.5539 | 累計 $ 8.5539 (sub $1.1867) | 5h +0%(3%) wk +0%(79%) fable +0%(61%) acct=…
一行裡有這一輪的工具呼叫數、派出去幾個 subagent、輸出多少 token(含思考部分)、本輪與累計的等價成本,以及三個訂閱額度窗。這裡的金額是按官方 API 定價換算的「等價成本」,訂閱制實際不按這個計費,它只能當相對比較的尺標——這句話就寫在工具自己的檔頭上,不是我寫這篇時才補的免責聲明。
麻煩出在這一行下面。主控派出去的每一個執行者(泛稱 worker:被派出去做事的 subagent),在終端上會另外留下兩種即時行:「派出」一行,「完成」一行。它們的用處是讓我在事情還在跑的時候就知道發生了什麼,不必等收尾。
問題是,同一筆花費稍後還會以縮排子項的形式,記進它所屬的那個輪次。所以我看到的不是三筆錢,是同一筆錢的三次曝光。規則因此被寫死成一句話:這兩種行是觀測不是會計,任何彙總都不得與輪次行相加。
這是我在可觀測性上學到的第一件事,而且它反直覺:資訊變多的同時,錯誤的加總方式也變多了。一個欄位只要沒標清楚「這是拿來看的,還是拿來算的」,總有一天會有人——通常是幾週後的我——把它丟進 SUM 裡。
同一行的右半邊有第二個陷阱。訂閱額度那三個窗,伺服器只給整數百分比,所以週窗在多數輪次都顯示 +0%,這是正常的,不是壞掉。更要命的是:那個幅度包含同時段其他 session、其他裝置的消耗,不是本輪獨佔量。如果我看到額度掉了 3% 就回頭去找「這一輪做了什麼這麼貴」,我可能整段都在追一個根本不在這台機器上發生的事。
逐輪用量紀錄解決的是時間軸上的「現在多少」。它答不出另一個問題:錢是花在哪一類人、哪一類事上。這題要靠派工稽核紀錄入庫之後的彙總。
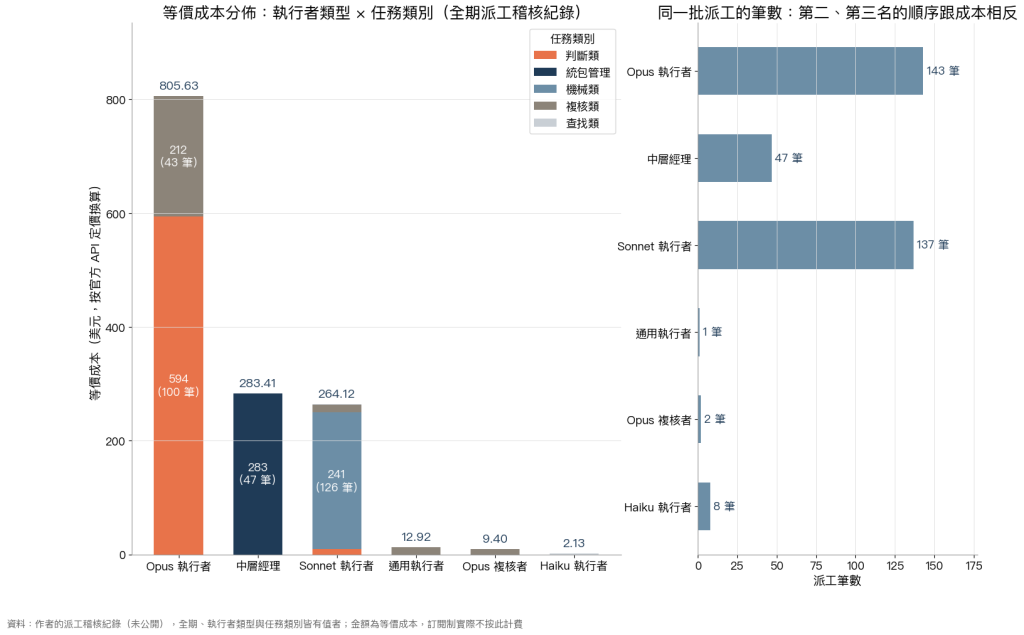
全期派工稽核紀錄中,執行者類型與任務類別皆有值的派工。左圖是花掉的錢,右圖是同一批派工的筆數——兩邊的排序並不一致。
這張圖裡最值得看的是筆數與金額的脫鉤。Sonnet 執行者做機械類任務共 126 筆,是全表筆數最多的一格,等價成本 240.66 美元;Opus 執行者做判斷類任務只有 100 筆,等價成本 593.99 美元。中層經理的統包管理 47 筆、283.41 美元。Haiku 執行者做查找類 8 筆,2.13 美元——在這張圖上幾乎看不見。
儀表板另外有一條長期在看的比例:Sonnet 與 Haiku 這兩類模型佔篩選窗內總成本的百分比。近 7 天重跑(測量時間 2026-09-20,n=563 筆派工)是 16.9%。這是一個隨時窗滑動而持續變動的移動指標,不是固定基準值。
它跟上面那張全期的圖不能直接對照:一個限定近 7 天、一個是全期,分母根本不同。這種「兩個都對、但不能相減」的欄位,在這套紀錄裡不只一處。
這些資料都在我自己的紀錄資料庫裡,沒有公開,讀者無法直接調閱;我能做的是把數字的口徑與測量時間一起寫出來。
看得見不等於看得住。紀錄躺在那裡而我沒去看,跟沒有紀錄的差別很小。所以真正的設計不在「記什麼」,在「什麼情況下它會主動來找我」。
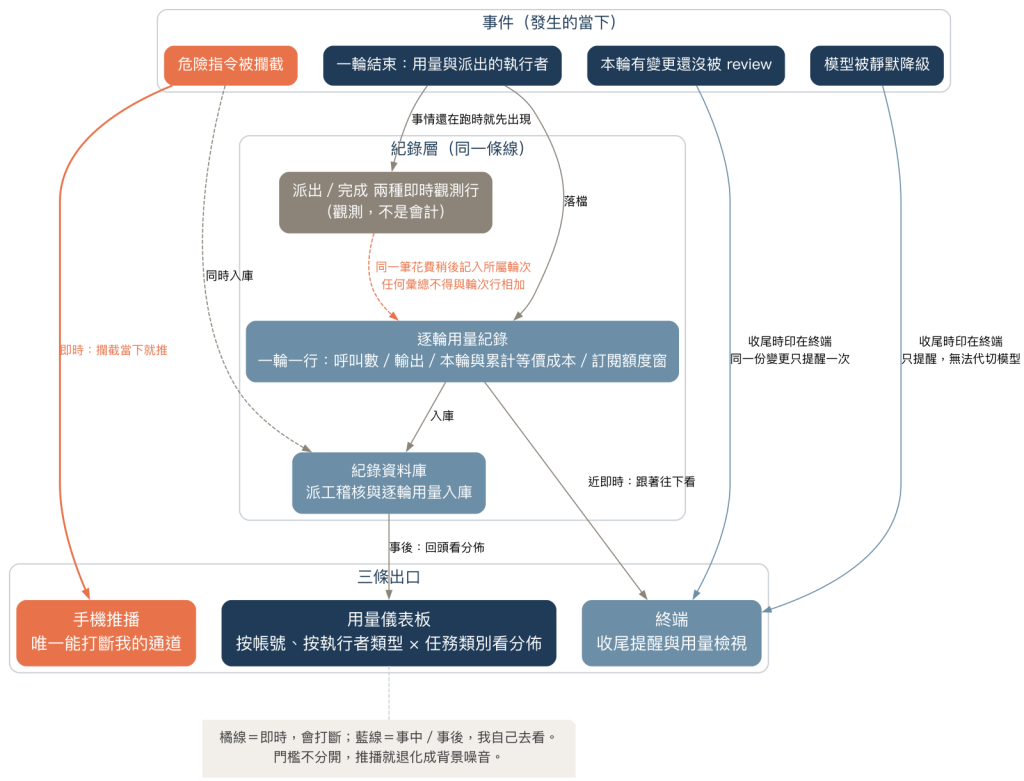
事件分三條出口:危險指令攔截直接推到手機;收尾提醒與逐輪用量印在終端,我自己想看時才看;儀表板從紀錄資料庫取數,事後回顧。只有推播那條有資格打斷。
即時那條是手機推播。 目前確定走這條的是危險指令攔截:攔截發生的當下就推到手機上。這條路的門檻要訂得很高,因為它是唯一能打斷我的通道;推播一多,它就退化成另一種我學會忽略的背景噪音。
事中那條落在終端。 每一輪結束時,會有機制把「還有多少變更沒被 review」印出來,而且同一份 diff 只提醒一次。它的設計原則寫得很清楚:只攤數據、不判斷完工、不自動 review——這跟 Day 6 的結論是同一條線。
另一支提醒管的是模型被靜默降級:當安全護欄誤判而模型被換成較舊版本時它會出聲,但它無法代替我切回去,只能提醒我自己動手。用量檢視指令也走這條:我想看的時候才看。
事後那條是儀表板。 它做分佈:按帳號拆、按執行者類型與任務類別交叉拆,也就是上面那張圖的來源。
三條出口的分工可以用一句話講完:即時的只負責讓我知道「現在發生了一件我必須看的事」,事後的負責回答「上週的錢花去哪了」。混在一起就會兩邊都失效——重要的事被淹沒,該慢慢看的東西逼你當下就下判斷。
這一篇從頭到尾都在用數字說話,而我刻意跳過了一件事:這些數字是怎麼被量出來的。
派出去的執行者,它的用量並不在主對話紀錄裡。它跑完的時間點也不一定落在派它的那一輪之內——一個中層經理可能在下一輪才結束。那麼它花的錢,該算在哪一輪頭上?如果用時間戳來歸屬,會出現一段「前一輪已經收尾、後一輪還沒開始」的空窗,落在裡面的花費兩頭都不認領。
還有更細的:快取寫入分成兩種存留時間,定價差 1.6 倍,帳要分開算。而這兩種在紀錄裡是不是真的都有數字,我還沒查。
看得到了,但量錯的地方比我想像的多。明天把這層拆開。
明日預告:Day 14|遙測:數字從哪來、為什麼會錯


 iThome鐵人賽
 看影片追技術