
昨天討論了 KV Cache 的目的以及怎麼優化,盡可能壓縮想保存下來的資訊,讓 KV Cache 需要的 GPU 顯存空間可以越少越好。所以我們昨天總歸一句是在討論 「要存什麼?」,探討的主要都是模型架構層面,資料結構與演算法可以怎麼優化。接著我們今天要探討的是,那我們在硬體的 GPU 顯存裡,具體 「要怎麼存?」
簡單來說,「模型」只是一份訓練好的靜態神經網路權重;而「推論引擎」則是負責驅動模型運算、管理硬體資源的執行系統(Runtime)(例如:vLLM,或是在本地跑 Ollama 時底層運作的 llama.cpp)。它負責接收並發請求、調度 GPU 計算核心,以及管理 GPU 顯存。
在 vLLM 出現之前,早期許多推論框架在管理 KV Cache 時,做法非常直覺:為每一個進來的請求,在 GPU 顯存裡劃出一整塊連續的記憶體空間。
但大語言模型在生成文字時,很難預測使用者這次請求會聊多長,模型會吐多少字。 使用者可能只是打個招呼,模型回了 10 個字就結束了;也可能丟了一篇論文,要求模型輸出 2000 字的深度摘要。
為了解決這種長度未知、隨時間動態增加的問題,傳統系統為了防止生成到一半顯存不夠導致 OOM,通常會採用保守的策略:直接按照模型支援的最大長度,預先替每個請求分配一整塊連續空間。
這就引發了幾個顯存空間的浪費問題,主要來自兩種碎片(Fragmentation,我沒想到會在這裡看到這幾個詞):
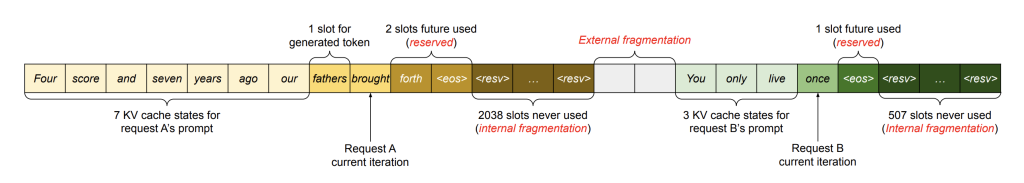
根據加州大學柏克萊分校團隊在 vLLM 論文 中的實測統計,在傳統的連續預分配機制下,推論系統中實際真正拿來存有效 Token 的顯存,往往只有 20% ~ 40%,其餘高達 60% ~ 80% 的顯存全部浪費在預留與碎片上。
為了解決顯存的碎片問題,柏克萊團隊提出了解法:PagedAttention。到這裡大概也有點感覺,這跟作業系統 RAM 的碎片問題很像,因此這個方法就是參考了 Virtual Memory 與 Paging 的機制。
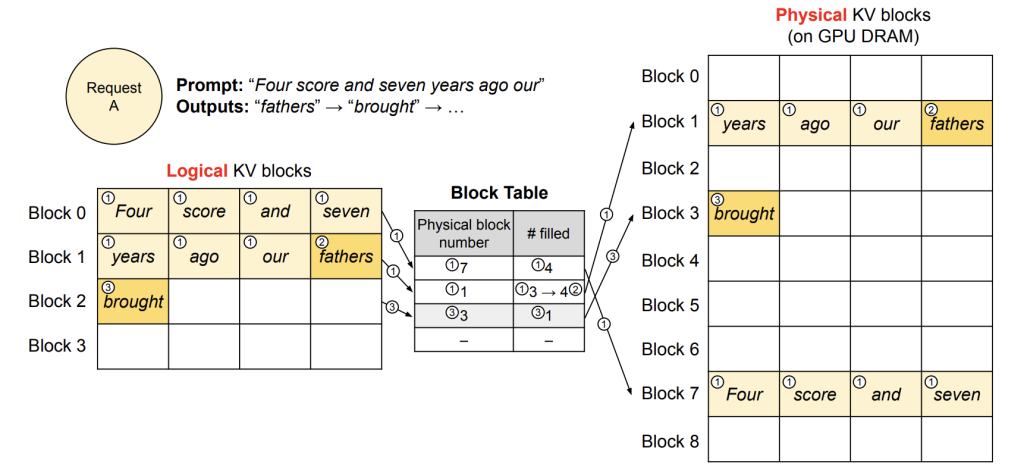
在作業系統中,程式的角度會以為自己拿到的是一段連續的虛擬記憶體,但實際上底層硬體會把空間切成一塊塊固定大小的 Page(例如 4 KB),散落在實體 RAM 的各處,中間靠一張 Page Table 進行映射。因此程式不需依賴「連續實體記憶體的分配」,而記憶體也只需要以 Page 為單位配置空間就好。
PagedAttention 就是把這個概念直接搬到 GPU 顯存裡:
在很多應用場景裡,我們會想要模型對同一個輸入給出多種結果,例如 Antigravity 的 /fork 這個 Slash Command;或者是很多對話共同使用同一份 System Prompt。PagedAttention 可以容易做到這種跨請求的顯存共享(Memory Sharing)。
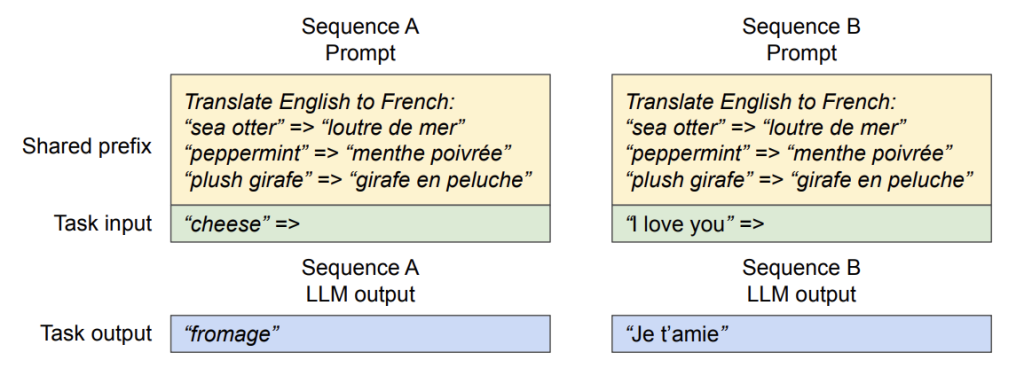
在傳統的連續記憶體做法下,因為每個請求都有自己專屬的一整條連續顯存,哪怕前面這 N 個分支的輸入 Prompt 完全長得一模一樣,也會硬生生把這份 Prompt 的 KV Cache 在顯存裡複製 N 份。但在 PagedAttention 裡,因為有了 Block Table 這一層間接引用,這件事變得格外漂亮:
當使用者要求對同一個 Prompt 生成多個分支(例如下圖中的 Sample A1 與 Sample A2)時,系統在初始階段只需要存一份物理 Block。兩個分支的邏輯 Block Table,通通指向相同的實體 Block,並在系統內部把這些 Block 的 Reference Count 標記為 2。
在 Decode 階段,對於前面那些已經裝滿 Prompt 的歷史 Block(如圖中的 Block 7),因為大家都在讀取它,所以這些已滿的 Block 會繼續保持共享,引用計數也完全不會變。
但在 Prompt 最後那個 還沒裝滿的 Block 要寫入新字時,就會觸發 Copy-on-Write 的機制。就像下圖中的 Block 1 原本裝了 years ago our,還剩最後一格:
mothers(綠色);fathers(黃色);fathers。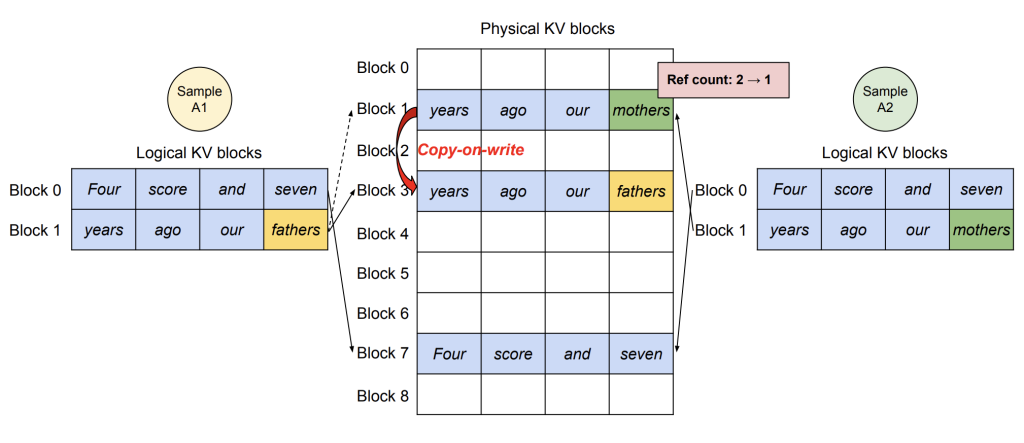
到這裡可以感覺到,前人們針對 KV Cache 做了非常多努力,雖然可以想像 KV Cache 還是會佔用不少 GPU 顯存空間,但這幾套組合拳搭在一起後,現實我們所使用的 AI 服務的 KV Cache 機制已經優化非常多了,所需空間也已經小非常多了。這就是為什麼現在的 AI 服務商有能力處理這麼大量的需求,不會 GPU 顯存撐不住的原因(當然也是因為鈔能力 XDD)。明天繼續來聊聊在實際應用中,KV Cache 對我們帶來的影響吧。


 iThome鐵人賽
 看影片追技術