
這篇其實就是在看完 大金老師的 KV Cache 課程 後,整理的筆記與心得。
昨天我們提到,LLM 在推論時總共會分成兩個階段:Prefill 以及 Decode 階段。值得注意的是,模型在訓練時在 Multi-Head Attention 中真正學習到的參數,其實只有 轉換矩陣(W_q, W_k, W_v ... 等等),並不是計算過後的 Q、K、V。也就是說,不論是在 Prefill 還是 Decode 階段,所有的 Q、K、V 向量通通都是透過轉換矩陣運算出來的中間產物,而模型的本質只是把一段 Input 算好後變成 Output。
那問題就來了:
這兩個問題帶來的計算開銷非常龐大。為了解決這個問題,最直覺的解法就是:把之前算過的中間結果存下來,給未來 Decode 時重複利用,這套機制就是「KV Cache」!
那看名字也知道,KV 就是 Key 跟 Value 這兩個向量,接下來的問題就是 「為什麼只有 KV 被 Cache?」 回到 Day09 跟 Day10 的架構圖來看的話其實不難發現,每次我們在「預測下一個字」的時候,我們都只透過當下 最後一個 Token 的 Q 以及 前面所有 Tokens 的 KV 來進行運算。這就是為什麼我們只存 KV,而 Q 可以用完即丟(因為後面就真的不需要哈哈~)
在 Hugging Face 上,我們可以直接打開 Google 開源的 Gemma-4-31B-it 的 config.json 設定檔,裡面就會記錄這個模型訓練時帶入的一些參數。我們先假設以標準的 Multi-Head Attention 來計算,也就是假設每個 Q Head 都有專屬的 K 和 V,而我們需要的參數就會是這些:
{
  "num_hidden_layers": 60,            // Transformer 層數
  "num_attention_heads": 32,          // Q 的 Head 數
  "num_key_value_heads": 32,          // KV 的 Head 數,原本是 16,但由於我們假設 MHA,所以我們讓每個 Q 都有專屬的 K 和 V,所以 Head 數是跟 Q 一樣
  "head_dim": 256,                    // 每個 Head 的維度
  "dtype": "bfloat16",                // 浮點數精度(每個浮點數佔 2 Bytes)
  "max_position_embeddings": 262144   // 官方支援上下文上限(約 256k Tokens)
}
(是不是看到一堆熟悉的名稱!)
因此,在標準 Multi-Head Attention 情況下,1 個 Token 在 Gemma-4-31B 裡要佔多少顯存的容量會是:
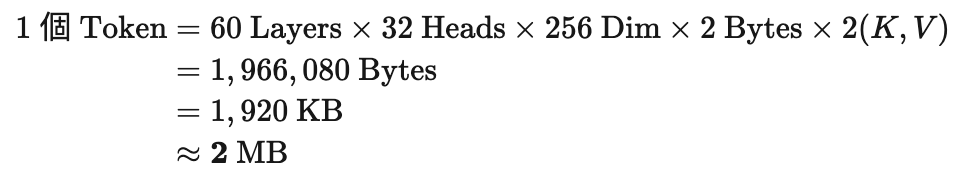
在採取 MHA 策略的情況下,單單 1 個 Token,在 GPU 顯存裡就要佔用接近 2 MB!
套回真實對話的情境,一個 Agent 一輪對話的 Context,在顯存所佔用的空間大小就會如下:
| 對話上下文長度 (Tokens) | 情境描述 (Gemini 說的) | 累積的 KV Cache 顯存大小 | 相當於多少顯卡?(Gemini 說的) |
|---|---|---|---|
| 1,000 (1k) | 一般問答或聊天 | ~= 2 GB | 一張家用顯卡可能撐得住 |
| 8,000 (8k) | 閱讀一篇中長篇的文章 | ~= 16 GB | 一張 16GB 的顯卡直接被灌滿! |
| 32,000 (32k) | 一整份專案規格書或程式碼 | ~= 64 GB | 光是快取就快超過 Gemma-4-31B 模型權重本體! |
| 128,000 (128k) | 現代大模型標配的超長對話 | ~= 256 GB | 塞爆 3 張 80GB 的 A100/H100 都還不夠放! |
| 256,000 (256k) | Gemma-4-31B 官方上限 | ~= 512 GB | 單一使用者的 Agent 就足以讓伺服器 OOM(下班~ |
在傳統的 Multi-Head Attention 架構下,當你丟給模型非常多的上下文(256k)時,「單一個使用者」的對話快取,就足以吃掉超過 500 GB 顯存!所以實務上絕對不是這樣做,模型開發商肯定不會坐視不管,接下來的幾種策略可以有效降低 KV Cache 所需佔用的空間。
首先第一個想法會是「真的需要這麼多 KV 嗎?」、「能不能單一 Token 每一個 Head 都共用同一組 KV?」,既然每個 Q 都配一組專屬的 K 和 V 覺得太吃顯存,那不如讓所有 Q Head 共用同一組 K 和 V
為什麼不是所有 KV 共用同組 Q?
因為要被存下來的是 KV,如果是所有 KV 共用同一組 Q 沒有意義,不會節省任何空間。
num_key_value_heads: 1)。既然 MHA(32:32)顯存太肥,MQA(32:1)又太激進,那折衷方案就是「分組共用」,也就是目前最常用的 Grouped-Query Attention (GQA)。
"num_attention_heads": 32,
"num_key_value_heads": 16,
既然直接砍 Head 數會讓表達語意的能力打折,那有沒有一種可能:我不砍 Head 數量,但我把 KV 壓縮之後再存? DeepSeek 團隊去年提出了另一種做法 Multi-Head Latent Attention (MLA)。
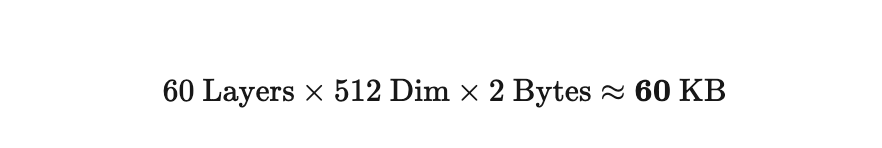
直接從原本 MHA 的 2 MB 暴砍到現在只剩下 60 KB(256k 只要約 15 GB),節省顯存的效果跟 MQA 一樣顯著,卻幾乎不犧牲 Multi-Head 的優勢。
剛才我們在算時,都是假設「整整 60 層 Layer,每一層都要把過去 256k 的所有字清楚記下來」。但仔細想想,真的每一層都需要看那麼遠嗎?
事實上,可以只關注較近的 Tokens,因為較近的 Token 也會去參考更前面較遠的 Token,所以在模型後面的 Layer 時,就會把更前面 Tokens 的資訊帶過來。
因此有些模型會採用 Sliding Window Attention 的機制。
gemma-4-31B-it 的 config.json,裡面也有相關設定:
{
  ...
  "sliding_window": 1024,
  "layer_types": [
  	...
  	"sliding_attention",
  	"sliding_attention",
  	"sliding_attention",
  	"sliding_attention",
  	"sliding_attention",
  	"full_attention",
  	...
  ],
  ...
}
sliding attention 或都是 full_attention,而是絕大部分 Layer 是 sliding_attention,每隔幾層穿插一層全域的 full_attention。60 * 16 KB ~= 1 MB / Token,而現在我們可以概算 10 層全局快取,每個 Token 的長期顯存只要:10 Layers * 16 KB ~= 160 KB,直接從原本 1 MB 降到約 160 KB,縮小將近 6 倍。其實還有很多招,把 FP16 換成 FP8 也是一招。這裡的內容比我想的還要多,感覺今天只能先這樣了,明天再看看怎麼接下去。祝各位中秋節快樂~


 iThome鐵人賽
 看影片追技術