
(看到最後就會知道為什麼是這張圖了 XDD)
過去十五天,我們把 LLM 底層的運作機制大概講了一遍。我相信底層還有很多細節,技術也會持續進步,很快我們現有的認知又會翻新,但這沒什麼關係,至少這段過程我們一直都在。
理解了這些原理後,我們會知道原本看似黑盒的 LLM,本質上就是一套嚴謹的數學計算,也是在與 AI 互動時的「大腦」。這時很自然會引出另一個問題:「那『AI Agent』又是什麼?」
題外話:我也是剛好現在的公司產品名稱也有啥啥 Agent 的,才大概理解 Agent 表達的意思,反正就是「代理人」、「幫你做事的角色」嘛哈哈。跟這裡的 AI Agent 應該也是異曲同工之妙。
先釐清我所理解的名詞定義:LLM 本身並不是 AI Agent,它是 AI Agent 中負責「大腦」的那一部分,它靜靜地被部署在伺服器的 GPU 顯存中。只要 Client 沒有發 Request,它連一個字都不會產生;Client 發了 Request,它做完運算後把結果吐回來,就立刻結束。如果 Client 與模型的互動只是「我發一句、他回一句」,那在處理真實世界的應用時,就會遇到一些問題:
git status 或 go test 這種指令。報錯了可能就會需要由人類複製貼上,解決了又得由人類複製貼回專案,很像早期 AI 剛推出時所使用的操作。這三個問題點出了從「純粹的大腦」到「自主的 Agent」之間的鴻溝。要讓 LLM 走出聊天框,真正走進專案協助開發的話,我們不能只給它一個被動的問答介面,而是必須在大腦的外層實作一套控制與管理程式,它就是 Agent Harness。這套程式負責幫大腦裝上記憶、接上手腳,並用狀態機迴圈推動它自主完成任務。從很早期的 AutoGPT 到現在主流的 Claude Code、Antigravity CLI 都是 Agent Harness。(是不是覺得「對耶!AutoGPT!還有過這個東西耶」,它都還有在繼續更新,超猛的~)
而前陣子討論很熱烈的 Harness Engineering,指的就是在這套外層控制程式上賦予更多工程能力,讓 AI Agent 能處理的事情越來越多。
時任 OpenAI 安全研究負責人 Lilian Weng 在 2023 年發表的技術文獻《LLM Powered Autonomous Agents》中,形式化定義了現代自主 Agent 的系統架構。她將一個能自主運作的 AI Agent 系統拆解為:

這四個部分各自有明確的分工,彼此透過迴圈串聯:
run_command(cmd string)(底層呼叫 exec.Command),或是 view_file(path string, startLine, endLine int)(底層呼叫檔案讀取 API)。這些函式的名稱、用途與參數型別會以 JSON Schema 格式定義在 Prompt 中,提供給模型選擇使用。目前最經典的狀態機模式,是普林斯頓大學與 Google 研究團隊在 ICLR 2023 提出的 ReAct 架構(Reasoning + Acting)。
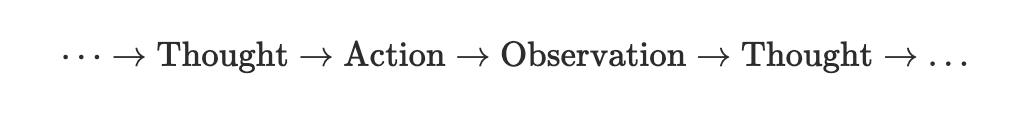
在實際系統中,它是模型推理與動作交織而成、循序推進的事件迴圈。舉個例子:
假設工程師在終端機輸入一項任務:
Daniel: 「請檢查
cmd/main.go編譯失敗的原因,並將其修復。」
在 Agent 控制迴圈內部,處理過程通常按以下次序推進:
run_command, view_file, replace_file)包裝為 Prompt 送出。run_command(CommandLine: "go build ./cmd/main.go")。./cmd/main.go:24:12: undefined: SessionStore。SessionStore,需檢視 cmd/main.go 第 20 至 30 行以確認引用與宣告。」view_file(AbsolutePath: ".../cmd/main.go", StartLine: 20, EndLine: 30)。NewSessionStore(),但缺少套件引用。需在 import 區塊補上套件路徑。」replace_file_content(...) 寫入修正。run_command(CommandLine: "go build ./cmd/main.go")。cmd/main.go 補上缺少的套件引用,並驗證 go build 編譯通過。」很不負責任地說上面這個例子是請 Gemini 想的 XDD。但簡單來說,透過這樣 Thought(推論下一步) -> Action(發出工具請求) -> Observation(接收回饋) 的循序推進,Agent 就能達成自動化解決問題的目標。
這裡突然讓我想到《PSYCHO-PASS 心靈判官》裡面一個很經典的畫面:故事裡負責審判好人壞人的西比拉系統,底層其實是由數百顆大腦聯網運作。
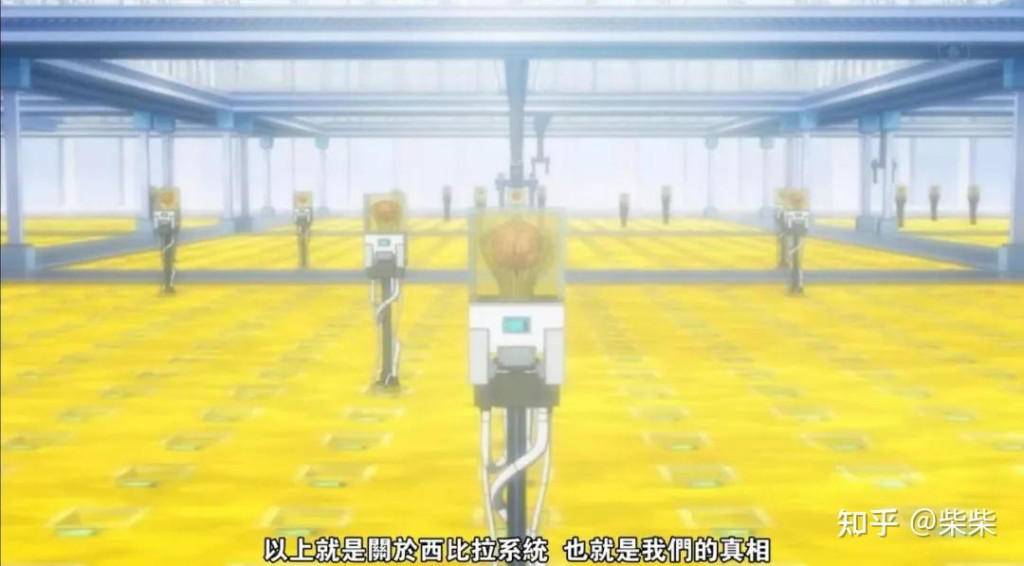
沒說準到最後發現數學還是戰勝不了生物學,就採取了這樣的策略 QQ。那手持 Agent Harness 的我們,都是西比拉的一份子哈哈 XDD
但是不是蠻像的,我們所有人電腦裡跑的 Agent,即便外層的 Harness 各有不同,但最終所有 Request 其實都是打向雲端同一顆共用的大腦來幫我們思考。我承認剛開始意識到是這種架構時,真的有種頭皮發麻的震撼感,但我也說不清楚為什麼。可能就像我在 Day 11 裡提到的,我以前真的以為每開一個 session,背後就有一顆專門為我服務的大腦。這種架構如果換作是我大概率設計不出來吧哈哈 XDD。
理解了 Agent 的基本結構與運作方式後,下一篇我們會介紹一下 Google 的 Antigravity CLI 這個東西。(終於要開始沾上一點邊了嗎!?)


 iThome鐵人賽
 看影片追技術