
前幾天我們探討了 KV Cache 的機制,但或許我們更在乎的是,這東西對於我們有影響嗎?他帶來的影響是什麼?
如果打開各家 AI 模型供應商的定價頁面(例如 Google Cloud 官方定價表 或是 Anthropic Claude 官方定價表),會發現計費標準通常不會只有標示 Input Token 或 Output Token 多少錢,還會明確列出如果 「Hit 快取(Cache Token)時」 Token 的計費方式。像 Gemini 甚至還會依照 Prompt Cache 的長度不同有不一樣的計價;Anthropic 也會明確標示新的 Token 在 Cache Write 多少錢,要保留在 Cache 多久也會有不同的價格。而這裡說的 Cache 就是指我們之前提到存在 GPU 顯存裡的 KV Cache。
因此,KV Cache 帶來的影響比想像的更深,尤其是在看 Token 使用量或是收到帳單的時候!往往 Cache Hit 時的收費會是一般 Input Token 的費用再打幾折(例如:1 折),所以運用得當的話,或許可以讓 AI 能再使用更久,或是帳單費用降得更低。而這整套機制在許多 AI 模型開發商的文件中,通常被叫做 Prompt Caching 或是 Context Caching。
在 Day 12 的時候,我們知道同一段對話內部的 KV 可以在 Decode 時重複利用;在 Day 13 的時候,我們知道透過 PagedAttention 的機制,相異的 Request 可以共享同一份 KV Cache;而在 Day 11 中,我們也知道跟 AI 的每一輪對話,底層其實就是發送多次的 Request。透過上述分析我們得知,我們的 System Prompt 以及每一輪對話的歷史紀錄,是很容易可以命中 Cache 的。
這就是 Prompt Caching 的基本概念,只要前面送出的內容有命中 Cache,就不用重新對這些 Token 做 Prefill 計算,首字生成時間(TTFT)與輸入費用都會大幅降低。但在實際使用時,可能會遇到一種狀況,假設一份長達一萬個 Token 的 Prompt,如果我們在第 500 個 Token 處修改了一個動態變數(例如加上當前時間戳記),後續 9,500 個 Token 的快取也會跟著全部失效,整段請求幾乎等於重新計算。
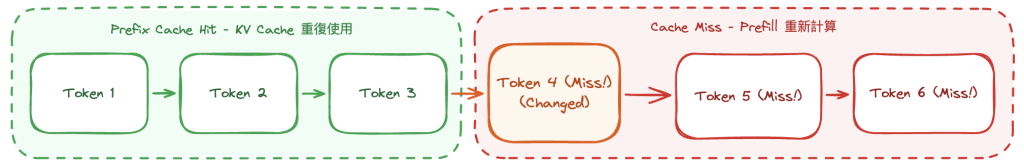
曾經聽過其他人針對這一點,覺得模型商刻意這樣設計很賤 XDD。但經過前幾天對於 Self-Attention 以及 KV Cache 更深入了解後,我們其實可以諒解,因為這就是 LLM 運作本身的機制(又或者說是條件):必須從第 1 個 Token 開始,100% 完全前綴連續匹配。 只要中間 1 個 Token 有改動,即使後面完全相同也無法重用舊快取。主要來自底層的兩個原因:
在各大廠商的定價文件中,通常有兩個關鍵設定:
我們在這篇文章將前面的內容全部串起來了,真開心。明天繼續加油唄~


 iThome鐵人賽
 看影片追技術