iT邦幫忙

2026 iThome 鐵人賽

DAY 12
0
自我挑戰組

從 Google AI Studio 玩轉提示工程的 30 天實戰修煉系列 第 12 篇

Day 12 文章結構調整建議:從「翻車對照」升級為「揭密現代 AI 的內建防禦機制」

  • 分享至 

  • xImage
  •  
  1. 大家都說 AI 容易腦補,是真的嗎?
    在 Prompt 工程領域,「防止幻覺」一直是熱門話題,過去往往需要繁瑣的防禦咒語。 
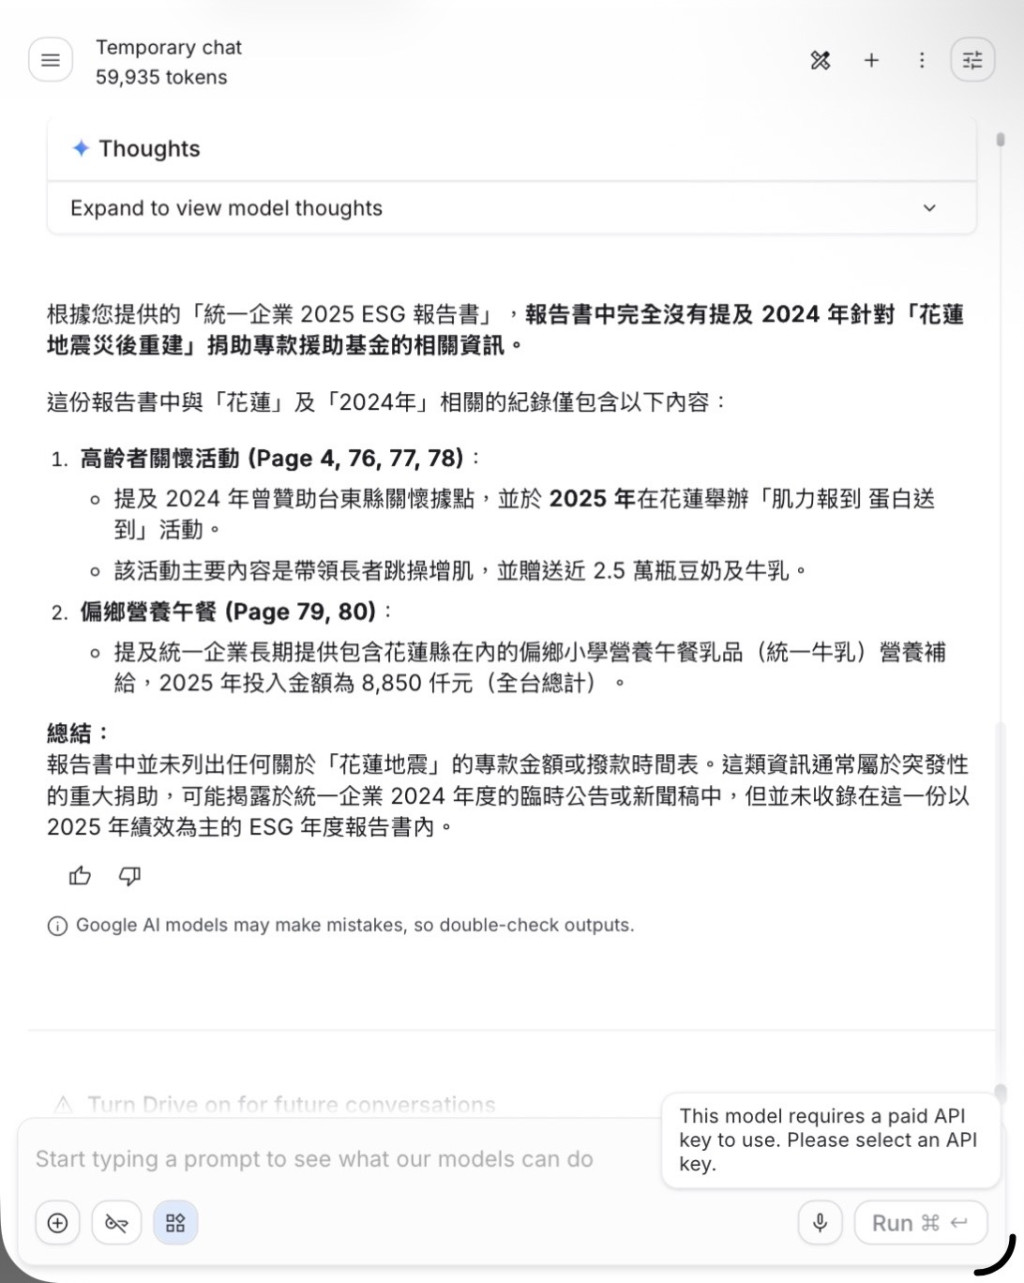
    今天我們在 Google AI Studio 進行壓力測試:針對一份近 6 萬 Token 的 ESG 報告,提出一個看似極度合理、卻完全不存在的陷阱問題(花蓮地震賑災專款)。 
  2. 實測結果:未加防禦咒語,Gemini 表現如何?
    https://ithelp.ithome.com.tw/upload/images/20260926/20178834cTejoCGM4u.jpg
    沒有捏造數字,直接辨識出未提及。 
    主動交叉比對報告中所有與「花蓮」相關的真實頁碼與專案(Page 4, 76-80)。 
    甚至能區分「ESG 年度報告」與「臨時重訊新聞稿」的邊界差異。 
  3. 深度解析:為什麼現代模型能自己防禦幻覺?
    原因一:Thinking 思考鏈(Thoughts 展開區塊)的預先校驗: 
    模型在輸出前,內部經過了思考推理步驟,在腦海中先比對了檢索結果與問題的真實性。 
    原因二:全域長上下文(Attention Mechanism)覆蓋: 
    模型真正看完了全部文本,因此敢於確定「這裡面真的沒有」,而不是因為沒檢索到而靠常識瞎猜。 
  4. 工程化防護 SOP:即便模型變聰明了,為什麼我們仍要規範 Prompt?
    雖然頂尖模型在常規提問下表現優異,但在正式的 API 串接與企業級工作流中,我們不能將系統的準確度賭在模型的自覺上。 
    提供讀者一套「閉卷防禦與逃生條款」的標準 Prompt 模板(閉卷原則、禁止推論、強制頁碼佐證、無資料時統一回傳特定格式或代碼),作為工程化落地時的雙重保險。

今日結語
從今天的實測中可以看到,Gemini 不僅沒有被以假亂真的商業問題所誘騙,更主動梳理出整份長文件中相關的真實線索,清楚劃分資訊邊界。理解模型的思考邊界,並在架構上給予明確的規範,這就是提示工程在對抗幻覺上的最高境界。


上一篇
Day 11:長文本檢索實戰:大海撈針(Needle In A Haystack)資訊提取測試
下一篇
Day 13:動態對話設計:在 Chat 模式中建立多輪對話記憶與上下文維護
系列文
從 Google AI Studio 玩轉提示工程的 30 天實戰修煉 共 19 篇
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言