
很多人以為 AI「有記憶力」,但從底層技術來看,大型語言模型本質上是無狀態(Stateless)的。今天我們要在 Google AI Studio 的 Chat 介面中,拆解模型是如何維護對話歷史,並實測如何透過提示工程技巧,在多輪問答中引導上下文演進,避免對話跑偏或遺忘核心任務。
底層技術揭密:AI 的「記憶」從何而來?
多輪對話的真相(Chat History Accumulation):
當我們進行第 3 輪對話時,AI 不是「記住」了前兩輪,而是系統把前兩輪的 User 輸入、Model 回覆,全部打包並接上第 3 次的提問,重新整包傳給模型推算。
代價:每增加一輪對話,整包上下文的 Token 數量就會像滾雪球一樣持續疊加。
多輪對話常見痛點(Context Drift 上下文漂移):
聊到第 5、6 輪後,模型可能逐漸忘記第 1 輪開立的格式限制或專案背景。
上下文過長導致冗餘雜訊增加,稀釋了核心指令的權重。
Google AI Studio 實測任務:漸進式軟體需求規格(SRS)共創
設計一個「需要經過 3~4 輪層層遞進、逐步收斂」的真實工程情境:打造一個會議錄音摘要小工具的需求規格書。
實測操作步驟與多輪對話設計
打開 AI Studio(確保在 Chat 模式),依序進行以下 3 輪對話:
第一輪:定義核心目標與角色分工(發散階段)
輸入:我們現在要啟動一個敏捷專案:打造一個專為遠端團隊設計的「AI 會議記錄自動化工具」。
這輪請先幫我條列出這個工具必備的「前三大核心功能 MVP」,先不要寫任何架構或程式碼。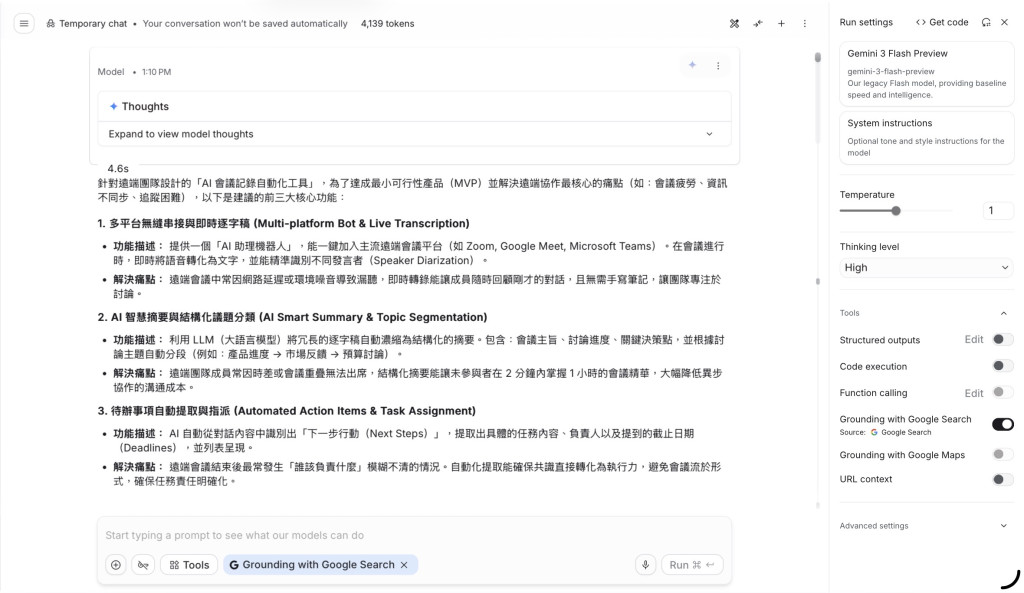
第二輪:鎖定細節與功能深入(收斂階段)
輸入(利用上下文代名詞,不重複前文):針對你剛剛提到的第三項「待辦事項自動提取」,請深入規劃它的使用者流程(User Flow),並定義這個功能在處理「沒有明確指派負責人」時的容錯邏輯。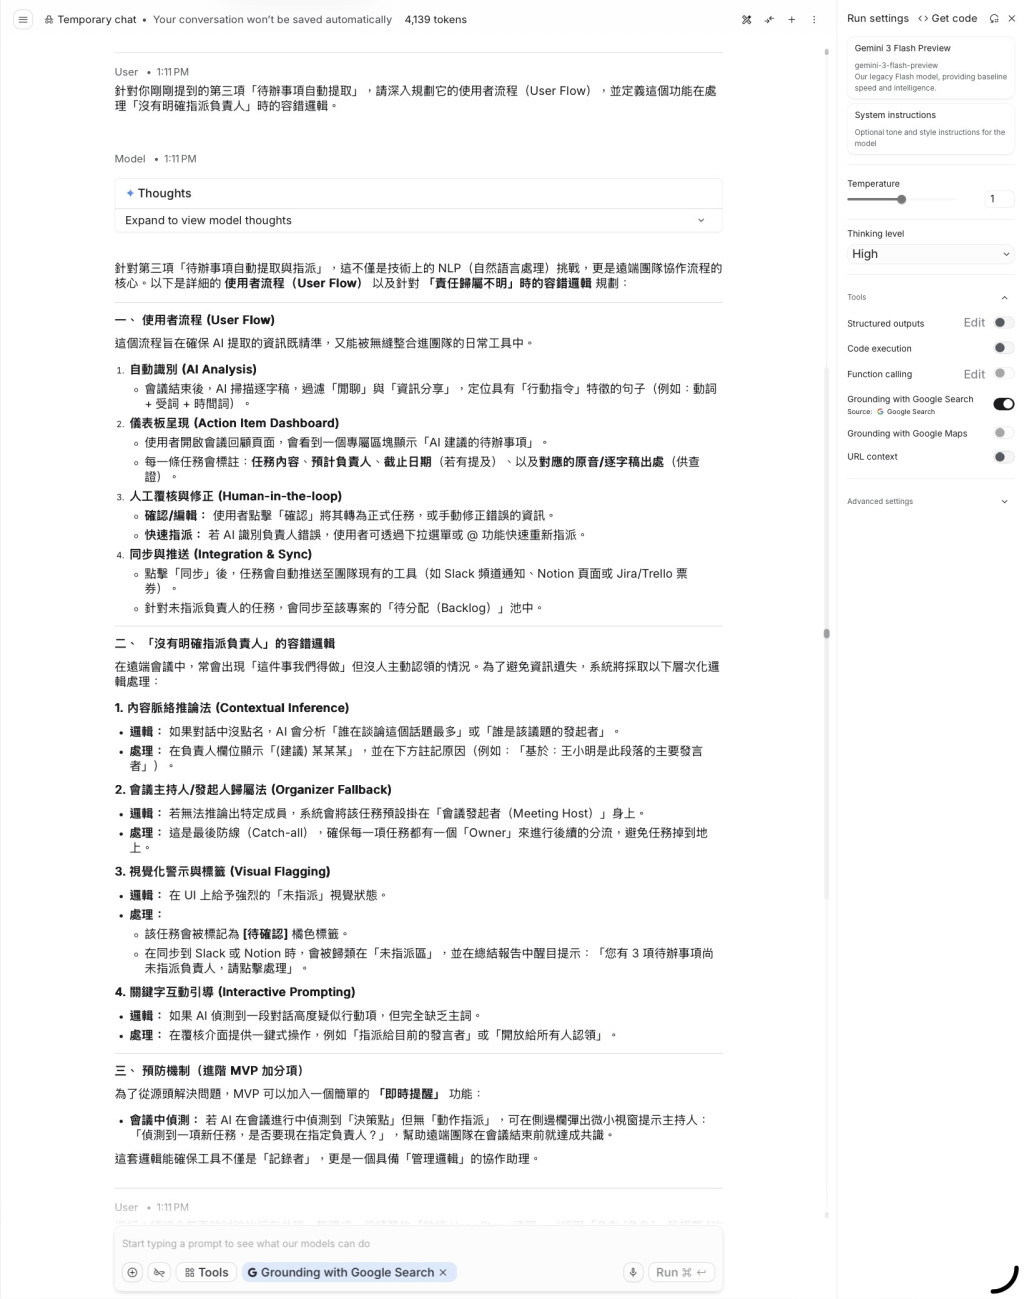
第三輪:強制上下文總結與格式轉換(交付階段)
輸入:很好!請綜合前兩輪討論的所有共識,整理成一份精簡的「敏捷 User Story 清單」(採用「身為 [角色],我想要 [功能],以便於 [價值]」的標準格式),並用 Markdown 表格呈現。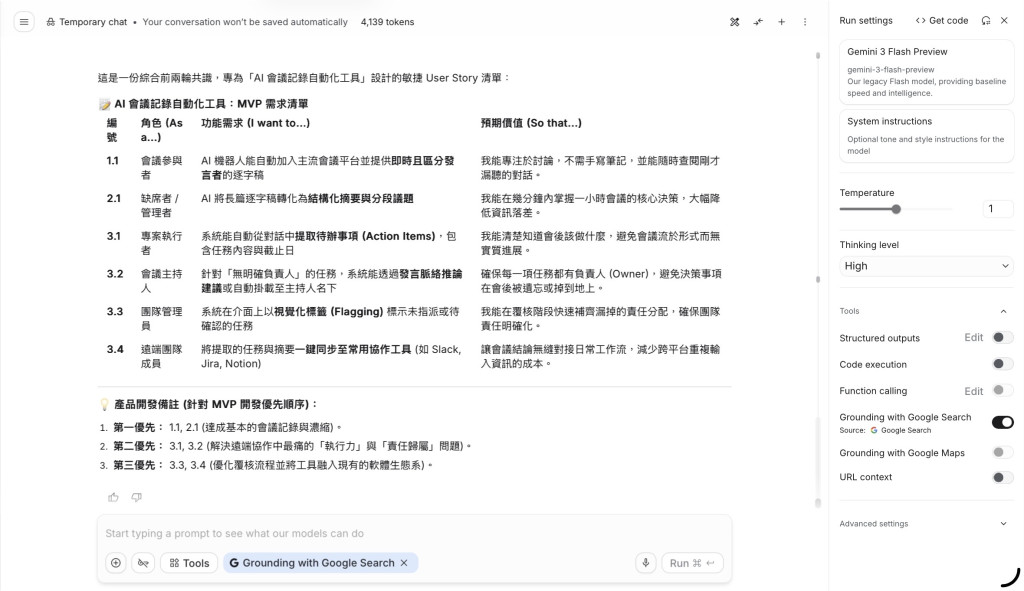
今日結語
多輪對話(Chat)並不僅僅是「聊天」,在現代 AI 協作中,它是一種「漸進式釐清問題(Progressive Refinement)」的高級工作流。
理解模型底層「每次將對話歷史全量打包傳輸」的運作機制,我們就能在實務上掌握兩個關鍵平衡:既善用上下文代名詞進行敏捷迭代,又適時透過「階段性總結」清理思維冗餘,讓對話始終沿著專案目標高效收斂。


 iThome鐵人賽
 看影片追技術