
要算出得來速 (drive-thru) 上每台車排隊、點餐、等餐、取餐各花了多久時間,就必須知道每台車從進入到離開的完整旅程。但沒有任何一支相機看得到整條車道:車道繞著建築物一圈,沿路五到十支固定相機各覆蓋一段,旅程必然橫跨多支相機。所以工程上要做的是多相機多物件追蹤 (Multi-Camera Multi-Object Tracking,後面簡稱 MCMOT):同一台車不論被幾支相機看到,都只能有一個 ID。
這件事在美國又比台灣難:台灣的得來速多為封閉單一車道,美國則常是開放空間,多車道並行排隊再匯流取餐,車道與停車場、商場動線交錯,停車、倒車、橫越車道的車都會入鏡。
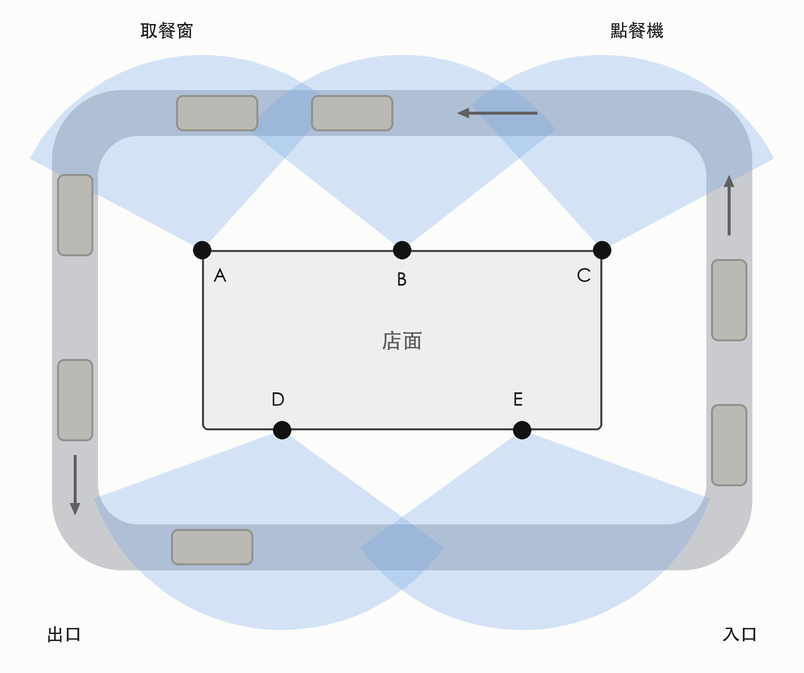
圖 1:淺藍是各相機的視野 (field of view),每支相機只覆蓋車道的一段;相鄰視野的重疊處顏色較深,跨相機配對就發生在這些區域。並非每一段車道都有重疊,甚至有相機完全看不到的區段。
Day 12 的 detection service 以 3 fps 輸出各相機的 bounding box。令 𝒞 為所有相機的集合,𝒟ₜᶜ 為相機 c 在時間 t 的 detection 集合;不同時刻 (t−1 與 t)、不同相機 (cᵢ 與 cⱼ) 的 detection 集合之間都沒有任何關聯。 MCMOT 要沿時間軸 t 與相機軸 c 建立關聯,得到一個把每個 detection 映射到正整數集合 ℕ 中某個 ID 的指派,同一台車映射到同一個值:
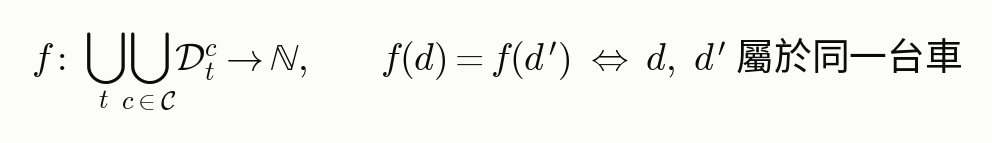
f(d) 就是 global ID。
時間軸上的關聯,我們在每支相機內以 tracking by detection 類型的 SORT (Simple Online and Realtime Tracking) 演算法完成;這篇的重點放在跨相機的部分。
Day 09 講內部參數 (intrinsics) 時提過,相機相對於店內世界座標系的外部參數 (extrinsics),要等相機鎖上店面的牆、固定不動之後才解得出來,這一節就是那件事。不同相機的架設位置、角度、焦段都不同,影像座標無法直接比較,必須先把所有相機看到的框投影到同一個座標系上,這就是 Day 09 預告過的多相機校準 (multi-camera calibration)。
從針孔相機模型出發,世界座標點經外部參數 [R | t] 轉到相機座標系,再經內部參數 K 投影到影像平面:
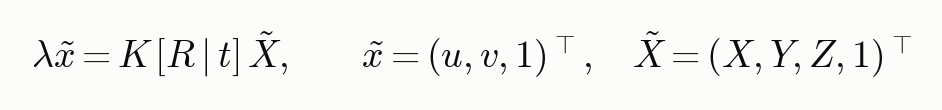
我們要反過來由像素座標求世界位置。一般情況少了深度做不到,但車都在地面上,令 Z = 0 (Day 09 推內部參數時用的也是這個約束),R 的第三個 column 就消失了:
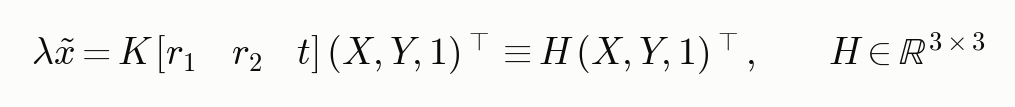
平面到平面的透視投影就是一個可逆的 3×3 homography H,我們不分別解 K、R、t,直接 fit H。投影的目標座標系是店家的衛星圖,其像素座標系就是跨相機共用的「世界座標系」。
H 在齊次座標下是線性映射,只能描述投影變換。真實鏡頭有徑向畸變 (Radial Distortion),影像邊緣的直線會彎成弧,這是非線性的,H 無法表達。成像模型因此在平面投影 P 之後多一段由內部參數 K 與畸變係數 (Distortion Coefficients) d 決定的畸變 D,必須先以去畸變 U 消除,再 fit H:
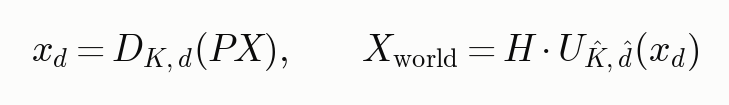
教科書做法是每支相機拿棋盤格解出真實的 K、d,但相機數量多、機種批次各異、還要人到現場拍攝,成本太高。我們換一個角度:去畸變只需以低成本消除非線性成分,剩下的投影關係都可以交給 H 吸收,因此 (K̂, d̂) 不必是真值。投影變換保直線,所以請標註人員沿影像中現實的直線描出 polyline,令 xᵢⱼ 為第 i 條的第 j 個點、ℓᵢ 為去畸變後這些點的擬合直線,解非線性最小平方:
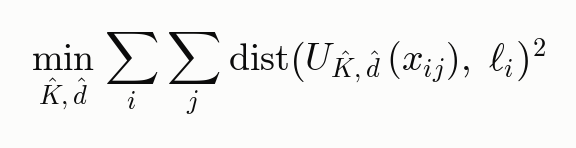
解出的 (K̂, d̂) 只能與同組參數 fit 出的 H 搭配使用,但不需要棋盤格,新相機描幾條線就能上線。
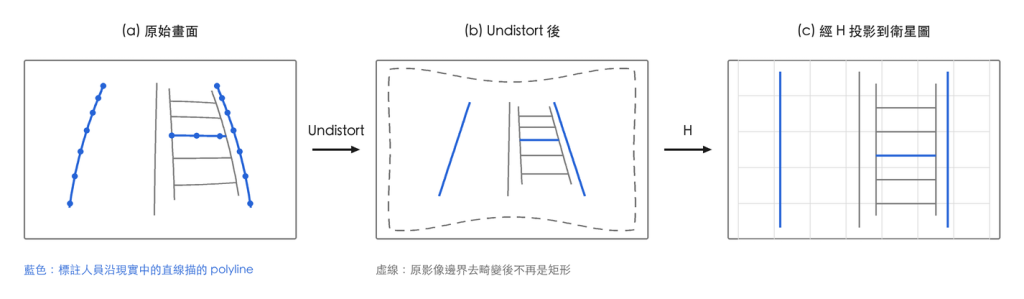
圖 2:(a) 現實中的直線在原始影像裡彎成弧;(b) 去畸變後恢復共線,只剩下一個投影變換;(c) 由 H 吸收,與衛星圖的地面幾何對齊。
去畸變後,影像與衛星圖之間是純粹的透視投影。fit H 的標準做法是給四組以上對應點,但得來速場域裡相機看得清楚的幾乎只有車道與地面標線,路面紋理單調、缺乏角點,可靠的參考基準點極少;反倒是車道邊線、停車格白線這類「同一條線」兩邊都清楚,所以我們改為標註對應線。
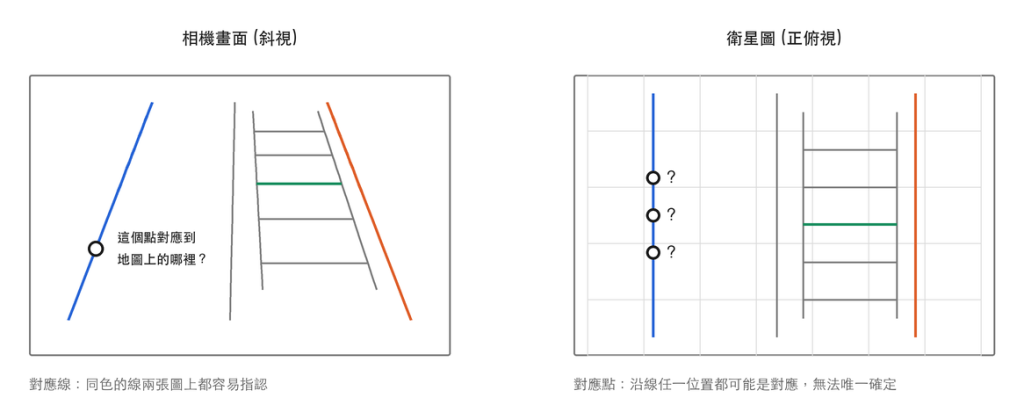
圖 3:同色的線兩邊都容易指認;單一點沿線任一位置都可能是對應,無法唯一確定。
點與線有對偶性:「點在線上」在兩個座標系裡是同一條線性方程,相機端 xᵀℓ = 0,衛星圖端 XᵀL = 0。點的變換已知是 X = Hx;假設線也有自己的 homography,記作 L = H′ℓ,代入衛星圖端的方程:
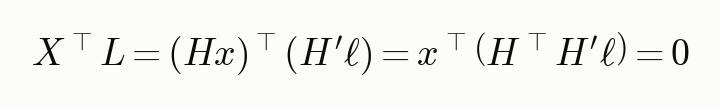
這條式子對 ℓ 上的每一個點 x 都成立,而通過這些點的直線只有一條,所以括號裡就是 ℓ 自己 (齊次座標下差一個倍數視為同一條線):HᵀH′ℓ = ℓ。每一條線都如此,於是
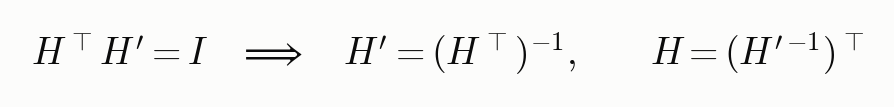
實作上把線係數 normalize 成 (a/c, b/c, 1)ᵀ,形式與點的齊次座標相同,可以直接餵給求點 homography 的函式,得到 H′ 後再 inverse 加 transpose:
def line_coeff(p1, p2):
    (x1, y1), (x2, y2) = p1, p2
    a, b, c = y2 - y1, x1 - x2, x2 * y1 - x1 * y2   # ax + by + c = 0
    return a / c, b / c, 1.0

src = [line_coeff(*l) for l in camera_lines]   # undistort 後相機影像上的線
dst = [line_coeff(*l) for l in map_lines]      # 衛星圖上的線

H_line, _ = cv2.findHomography(np.array(src), np.array(dst))
H = np.linalg.inv(H_line).T                    # H = (H'⁻¹)ᵀ
每支相機各自以 (K̂, d̂) 與 H 把 detection 投影到同一張衛星圖上,「是否同一台車」就化為「兩個世界座標點的距離是否小於門檻」。
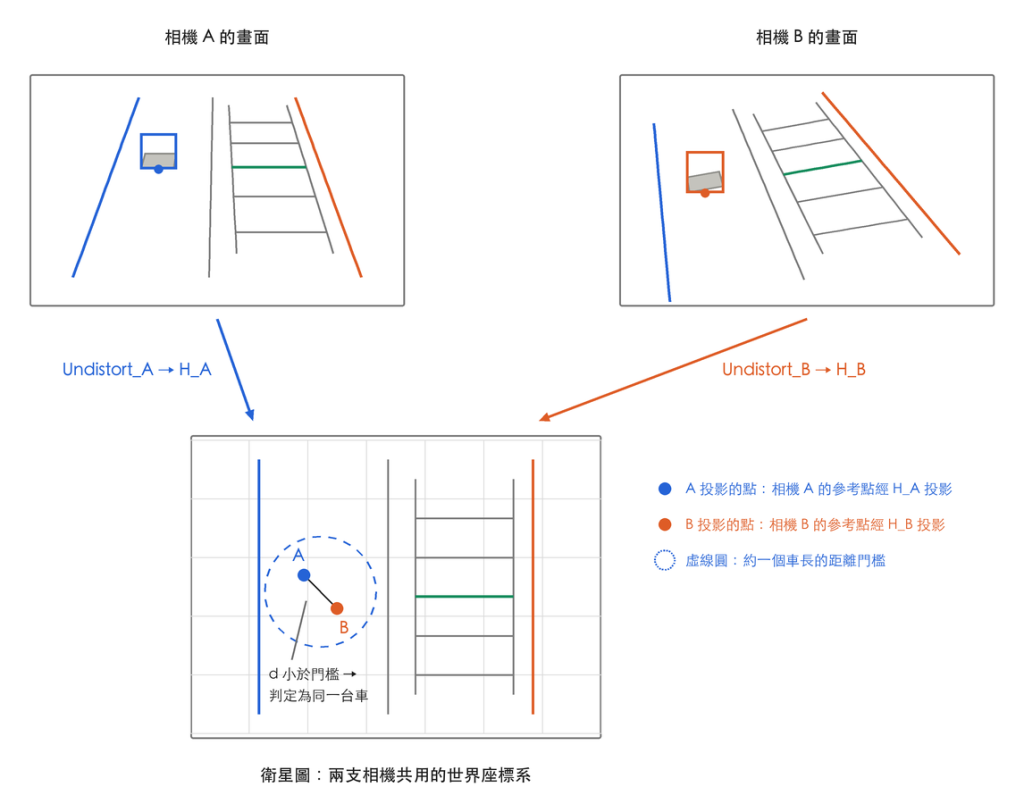
圖 4:相機 A、B 各自投影後,同一台車的參考點距離 d 小於門檻 (約一個車長) 即判定為同一台車。
在每個時間 t,把所有候選 (單相機配對成功的 track、各相機未配對的 detection) 以各自的 H 投影到衛星圖上。兩兩距離小於門檻就連一條邊,權重為 (1 − d/門檻)²;同一支相機內的兩個框不連邊。再加上一致性約束:
for v, neighbors in graph.items():
    for u, w in combinations(neighbors, 2):
        e1 = x[(v, u)]          # v 與 u 是同一台車?
        e2 = x[(v, w)]          # v 與 w 是同一台車?
        e3 = x.get((u, w))
        if e3 is not None:
            solver.Add(e1 + e2 - e3 <= 1)   # v=u 且 v=w ⇒ u=w
        else:
            solver.Add(e1 + e2 <= 1)        # u, w 不可能相等 ⇒ 不能同時成立
solver.Maximize(sum(weight * x for each edge))
每條邊是 0/1 變數,MIP (Mixed Integer Programming) solver 在約束下最大化總權重,確保「同一台車」的關係具遞移性;求解後以 union-find 合併成群,每群保留一個既有 ID。
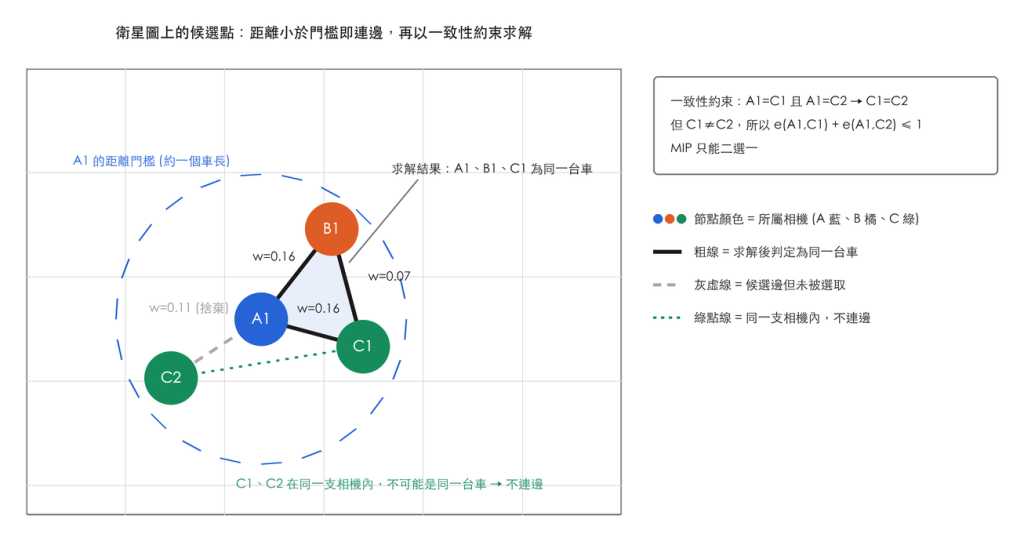
圖 5:A1 與 C1、C2 都很近,但 C1、C2 在同一支相機內不可能是同一台車,約束使 A1 只能與其一配對。
Global ID 到這裡就產生了:同一台車在不同相機的投影落在同一位置,就會被合併為同一個 track。
回頭看:detection 是沒有身分的框;單相機追蹤在時間上把它們連成 track;calibration 把各相機的 track 投影到同一個世界座標系;跨相機配對在衛星圖上合併為同一台車,global ID 就是這樣來的。實務上還要處理遮擋與相鄰相機視野沒有 overlap 的區段,我們以先進先出、必要時輔以 ReID (Re-Identification) 的規則補足,這裡就不展開了。軌跡到這裡是連續的,但還不知道每一段代表什麼:Day 14 會用狀態機把一條軌跡切成排隊、點餐、等餐、取餐四個階段。
本系列由 Berry AI 工程團隊出品。更多工程實戰紀錄都在 Berry AI 技術部落格。


 iThome鐵人賽
 看影片追技術