

前面二十四天蓋了一套可觀測性系統。今天開始最後一個區塊,做一隻 agent。
先講為什麼——不是因為 AI 很紅。 理由來自我自己:昨天那則 DiscountRuleMissing 送出來的通知裡有 severity: ticket、team: pricing、sum(rate(discount_missing_total[5m])) > 0 這些字。我現在看得懂,因為規則是我前天寫的。但 Day 1 的我完全看不懂。
半夜三點被叫起來的人需要的不是這串術語,是一句「pricing 每秒有一筆商品算錯價,客人看到的金額是錯的,從十一點二十二分開始」。
從告警到這句話之間要做的事很固定:查 Alertmanager 看告警內容、查 Prometheus 確認影響多大、查 Loki 找是哪幾筆。步驟固定,但每一步查什麼得看前一步的結果——這種形狀的工作正好適合 agent。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=true LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
agent 要有東西可讀,得先有告警在燒。DiscountRuleMissing 的 for 是 15 分鐘,所以開完要等十五分鐘以上它才會從 pending 轉 firing。
大型語言模型(LLM)本身只會產生文字。 它不能連網、不能查資料庫。直接問它「現在有哪些告警」,它只能瞎編一個看起來很像的答案出來。
tool-calling(工具呼叫)就是補這一塊的機制:
list_alerts,功能是列出目前的告警」list_alerts,參數是空的」第 3 到 5 步會一直繞,直到它覺得夠了為止。
關鍵在第 4 步:工具是你的程式執行的,模型碰不到。 它只能說「我想呼叫這個」,實際要不要呼叫、呼叫完給它看多少,全部是你決定的。
我一開始想的是把告警、指標、log 全部抓下來貼給模型,請它總結。這樣行不通,三個理由:
tool-calling 讓它按需求取用:先看告警,覺得需要才去查指標,還不夠才去撈 log。
| 工具 | 做什麼 | 對應前面哪一天 |
|---|---|---|
list_alerts() |
列出 Alertmanager 目前觸發中的告警 | Day 22 |
query_metrics(promql) |
對 Prometheus 執行一段 PromQL | Day 10 |
search_logs(logql) |
對 Loki 執行一段 LogQL | Day 16 |
就三個,刻意的少。這正好是我自己從 Day 16 到 Day 24 學會的除錯流程:看告警、查指標確認範圍、撈 log 找細節。工具給太多模型會選錯,跟告警不是加愈多愈安全是同一件事。
agent 跑在我自己電腦上,不進叢集,三個工具打的都是 kubectl port-forward 接出來的本機埠:
kubectl port-forward -n monitoring svc/kps-kube-prometheus-stack-alertmanager 9093:9093
kubectl port-forward -n monitoring svc/kps-kube-prometheus-stack-prometheus 9090:9090
kubectl port-forward -n monitoring svc/loki-gateway 3100:80
我用 Gemini,因為我有一把免費的 API key。但免費額度不是一視同仁的,我是連撞好幾次牆才發現:
| 每分鐘請求數 | 每天請求數 | |
|---|---|---|
| Gemini 3.5 Flash | 5 | 20 |
| Gemini 2.5 Flash | 5 | 20 |
| Gemini 3.1 Flash Lite | 15 | 500 |
一次問答會用掉三到五次請求,所以走 Flash 的話一天只能問四次。我在調 docstring 的時候一個下午就撞光了兩個模型的額度,隔天才能繼續。
Flash Lite 的每日額度是 25 倍,而且我實測它做這件事綽綽有餘——待會會看到它自己算出了受影響的比例,Flash 反而沒算。所以這篇用 gemini-3.1-flash-lite。
模型名稱我釘死版本,不用 gemini-flash-latest 這種別名——別名底下換成哪個模型不會通知你,明天要比 token 和延遲的數字就對不起來。
工具就是三個普通的 Python 函式。以 query_metrics 為例:
def query_metrics(promql: str) -> str:
    """對 Prometheus 執行一段 PromQL 即時查詢,用來確認影響範圍有多大。

    Args:
        promql: PromQL 查詢字串。例如
            sum(rate(http_requests_total{service="pricing"}[5m]))
            算出 pricing 每秒的請求數。
    """
    r = httpx.get(f"{PROMETHEUS}/api/v1/query", params={"query": promql}, timeout=15)
    body = r.json()
    if body.get("status") != "success":
        return f"查詢失敗:{body.get('error', '未知錯誤')}"
    result = body["data"]["result"]
    if not result:
        return "查詢成功,但沒有任何資料符合。這段 PromQL 可能指標名稱或標籤寫錯了。"
    out = [{"labels": s["metric"], "value": s["value"][1]} for s in result[:20]]
    return json.dumps(out, ensure_ascii=False)
三件事值得講:
回傳一定是字串,因為模型只看得懂文字。
原始 JSON 要先瘦身。 一則 Alertmanager 告警含註解和 fingerprint 大約 800 字,而這些字是要付錢的,所以每個工具都先挑掉用不到的欄位。
查不到要講原因,不要回空的。 上面那句「這段 PromQL 可能指標名稱或標籤寫錯了」是給模型看的,不是給我看的。
把函式交給 SDK:
config = types.GenerateContentConfig(
    system_instruction=SYSTEM_PROMPT,
    tools=[list_alerts, query_metrics, search_logs],
    automatic_function_calling=types.AutomaticFunctionCallingConfig(disable=True),
)
tools 直接收 Python 函式,SDK 會自己從簽章和 docstring 產生工具定義,不用手寫 JSON schema。我把它產出來的東西印出來看過:
{
  "name": "query_metrics",
  "description": "對 Prometheus 執行一段 PromQL 即時查詢,用來確認影響範圍有多大。\n\nArgs:\n    promql: PromQL 查詢字串。例如...",
  "parameters": {
    "properties": { "promql": { "type": "STRING" } },
    "required": ["promql"],
    "type": "OBJECT"
  }
}
整段 docstring 原封不動變成 description,參數只留型別。 docstring 就是模型唯一看得到的說明書,這件事等一下會變成今天最大的一個坑。
AutomaticFunctionCallingConfig(disable=True) 那行是關掉 SDK 的自動模式。預設它會幫你把「呼叫、執行、送回、再呼叫」整個迴圈做掉,你只要送一次請求就拿到最終答案。
我把它關掉,自己寫:
contents = [types.Content(role="user", parts=[types.Part(text=question)])]

for turn in range(1, MAX_TURNS + 1):
    resp = ask(client, contents, config)
    contents.append(resp.candidates[0].content)

    calls = resp.function_calls
    if not calls:
        print(resp.text)
        return

    results = []
    for call in calls:
        args = dict(call.args or {})
        print(f"[第 {turn} 輪] 模型要呼叫 {call.name}({args})")
        output = BY_NAME[call.name](**args)
        results.append(
            types.Part.from_function_response(name=call.name, response={"result": output})
        )

    contents.append(types.Content(role="user", parts=results))
兩個理由:自動模式會把中間過程吃掉,我想看見它每一輪在想什麼;而且明天要量每一輪的 token 和延遲,SDK 包起來就量不到。MAX_TURNS = 8 是防呆,模型一直查下去的話八輪就停。
故障還沒燒起來,Alertmanager 裡只有 Watchdog——那則永遠在觸發、用來證明告警管線是通的心跳告警。
[第 1 輪] 模型要呼叫 list_alerts({})
         → [{"alertname": "Watchdog", "severity": "none", ...}]

目前系統中並沒有觸發任何異常告警,僅有一個名為 "Watchdog" 的通知(這是用來測試
告警系統是否正常運作的常態性檢查,並非系統異常),這代表目前各項服務的健康檢查
狀態皆為正常。
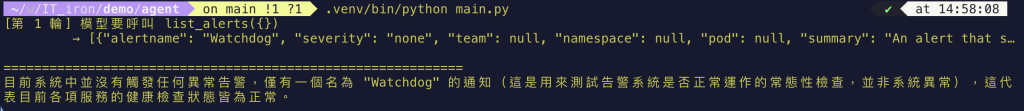
一輪就收工。它認出那是心跳,講明並非系統異常,然後停手——沒有再去查指標湊字數,也沒有硬掰一個故障出來。
這不是理所當然的。語言模型的本能是給出一個看起來合理的答案,即使它沒有根據——這個現象叫幻覺(hallucination)。我在 system prompt 裡寫的「查不到就說查不到,不要推測」,第一次跑就看到效果。
等到 DiscountRuleMissing 轉成 firing 再跑一次:
[第 1 輪] list_alerts({})
[第 2 輪] query_metrics({'promql': 'sum(rate(http_requests_total{app="pricing"}[5m]))'})
         → 查詢成功,但沒有任何資料符合。這段 PromQL 可能指標名稱或標籤寫錯了。
[第 3 輪] query_metrics({'promql': 'sum(rate(pricing_requests_total[5m]))'})
         → 查詢成功,但沒有任何資料符合。這段 PromQL 可能指標名稱或標籤寫錯了。
[第 4 輪] search_logs({'logql': '{app="pricing"} |= "missing"'})
         → 查詢成功,但這段時間沒有符合的 log。
[第 5 輪] search_logs({'logql': '{app="pricing"} |= "error"'})
         → 查詢成功,但這段時間沒有符合的 log。

目前的告警顯示 pricing 服務出現「折扣規則缺失」的問題,雖然使用者不會收到錯誤
訊息,但部分商品的定價可能會因為找不到折扣規則而算錯。

此告警從 2026-09-23 17:33:03 開始觸發。

根據告警說明,該問題造成每秒約 0.93 筆請求發生折扣規則無法取得的情況,由於系統
仍會回傳 200 OK,因此使用者端不會有直接的錯誤感受。目前我嘗試查詢 pricing 服務
的即時流量指標以及相關錯誤紀錄,但由於查詢結果未取得符合資料,暫時無法從指標數
據面提供進一步的擴散範圍與細節。
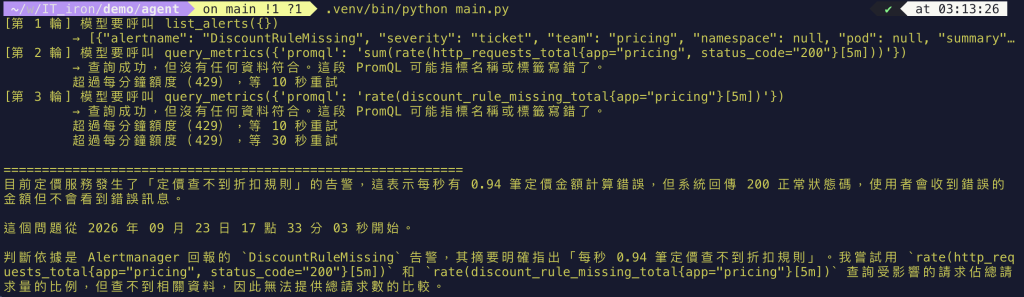
第一段就是我要的東西。「使用者不會收到錯誤訊息,但部分商品的定價可能會算錯」是它從告警的 summary 讀出來再重講一次的——那是我 Day 21 自己寫的句子。
但底下四次查詢全部落空,所以它算不出影響比例,而它老實說了。它大可以拿 0.93 除以一個編出來的總量,說「影響 3% 的請求」,聽起來還很專業。它沒有。
(時間那行要小心:17:33:03 是 UTC,我這邊是凌晨 1 點 33 分。Alertmanager 回的時間帶 Z,模型照抄沒有換算,也沒說那是 UTC。值班的人差八小時去翻 log 會翻不到。)
兩段 PromQL 錯得不一樣:
| 它寫的 | 真正的名字 |
|---|---|
http_requests_total{app="pricing"} |
標籤是 service 不是 app |
pricing_requests_total |
這個指標根本不存在,是它編的 |
第二個是純粹的猜測。它知道自己要一個「pricing 的請求數」,但沒有人告訴過它這套系統的指標叫什麼,所以它照最常見的命名習慣賭一把。
第一個不是猜的,是我教的。search_logs 的 docstring 裡我寫了一句「服務名稱請用 app」。那句話對 Loki 是對的。但模型看到的不是三份獨立的說明書,是同一份 prompt 裡並排的三段文字,它把 Loki 的慣例套到了 Prometheus 上。
這裡真正的坑不是我打錯字,是同一個服務在兩個系統裡叫不同的名字:
| 服務名稱的標籤 | |
|---|---|
| Prometheus | service(另外還有 Day 13 那個撞名撞出來的 exported_service) |
| Loki | app |
這件事我自己查了十幾天都沒發現,因為我每次都只在其中一邊查。agent 一次要跨兩邊,差異馬上就浮出來了。
修法是把 Prometheus 真正有的指標和標籤寫進 query_metrics 的 docstring:
    """對 Prometheus 執行一段 PromQL 即時查詢,用來確認影響範圍有多大。

    這套系統有的指標,以及它們的標籤:

    - http_requests_total:請求數。標籤 service(gateway/catalog/pricing)、path、status
    - http_request_duration_seconds_bucket:延遲直方圖。標籤同上,另有 le
    - checkout_total:結帳次數
    - discount_missing_total:查不到折扣規則的次數

    服務名稱的標籤在 Prometheus 是 service,不是 app——app 是 Loki 那邊才有的。
    """
重跑:
[第 1 輪] list_alerts({})
[第 2 輪] query_metrics({'promql': 'sum(rate(discount_missing_total[5m]))'})
         → [{"labels": {}, "value": "0.9192821178575816"}]
[第 3 輪] search_logs({'minutes': 10, 'logql': '{app="pricing"} |= "discount_missing"'})
         → 查詢成功,但這段時間沒有符合的 log。

目前系統中觸發了一個名為 DiscountRuleMissing 的告警⋯⋯
此問題從 2026 年 9 月 23 日 17:33 UTC 開始發生。

判斷依據如下:
1. 根據 sum(rate(discount_missing_total[5m])) 的指標查詢,目前的發生頻率約為每秒 0.92 次。
2. 系統自動產生的告警摘要指出,因為使用者不會感受到錯誤(HTTP 狀態碼正常),
   所以此告警等級被標記為 ticket,不需要立即緊急處理。
3. 嘗試透過 search_logs 搜尋相關錯誤細節,但目前在 pricing 服務的日誌中未撈取到具體的錯誤記錄。
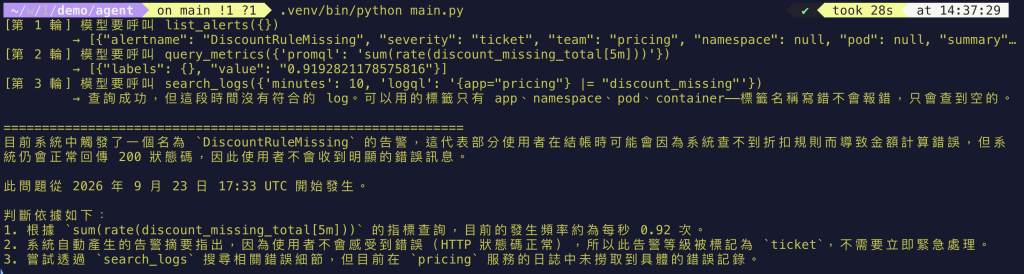
指標那邊乾淨了:discount_missing_total 一次寫對,沒有再編名稱,也沒有再把 app 用到 Prometheus 上。我給它的那份清單,它就照著用。
順帶一提,這次它寫「17:33 UTC」,把時區標出來了,前一次沒有。同一個模型、同一個問題,這種細節不保證每次都一樣。
我本來準備寫的是「怎麼寫 tool-calling 的迴圈」,結果整天在改 docstring。寫程式已經是寫程式中最沒有難度的一塊,main.py 加 tools.py 總共 223 行,其中大半是註解和 docstring,一次就跑起來了;難的是想清楚要怎麼跟一個沒看過你系統的讀者解釋你的系統——而那個讀者剛好是模型。
上面那五輪裡,後兩輪常常被略過不看,但那是第二個坑。
第 4、5 輪它已經轉向 log 了,標籤也用對了(Loki 這邊確實是 app),但兩次都撈不到東西:
[第 4 輪] search_logs({'logql': '{app="pricing"} |= "missing"'})
[第 5 輪] search_logs({'logql': '{app="pricing"} |= "error"'})
實際那行 log 長這樣:
{"service": "pricing", "product_id": "P027", "category": "hats",
 "event": "discount rule not found", "level": "warning", "timestamp": "..."}
missing 不在裡面,level 是 warning 不是 error。它在猜一段自己沒看過的文字。
而它會用猜的,是因為 search_logs 的 docstring 從頭到尾只寫了「用來找出錯誤訊息的細節」,沒說過 log 裡有什麼欄位、每一行長什麼樣。跟 PromQL 那次一模一樣的病。
補上:
    每一行 log 是一個 JSON,除了 event、level、timestamp、trace_id 之外,
    還會帶當下的欄位,例如 pricing 查不到折扣規則時會記 product_id 和 category。
    指標只有數字,要知道「是哪一筆」一定得撈 log。
但第 3 輪那個 |= "discount_missing" 還是落空了。指標名稱可以列給它,log 裡會出現哪些字串不行——那是程式當下寫進去的句子,沒有清單可列。
換一個指標答不出來的問題:「哪些商品受到影響?給我具體的商品編號」。
[第 1 輪] list_alerts({})
[第 2 輪] search_logs({'minutes': 30, 'logql': '{app="pricing"} |= "discount"'})
         → {"service": "pricing", "product_id": "P013", "category": "coats",
            "event": "discount rule not found", "level": "warning", ...}

目前受到影響且查不到折扣規則的商品編號主要為 P013(分類為 coats)與 P027(分類為 hats)。

這項判斷是根據對 pricing 服務的紀錄檔(Log)查詢結果所得,系統顯示這些商品在執行
折扣計算時,無法找到對應的規則,導致金額計算可能出錯,但服務仍會正常回傳請求結果
(HTTP 200)。
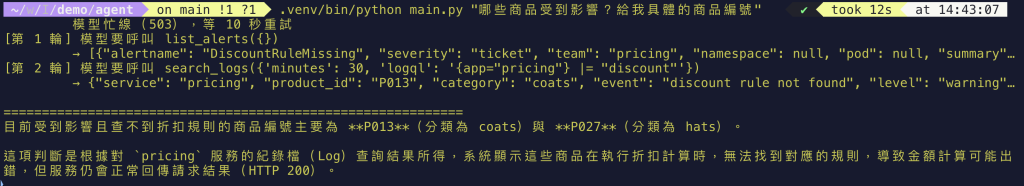
兩輪就結束,第一次就打中。跟上一次的差別只有一個字:上一次猜 discount_missing(照指標名稱去湊),這次猜 discount。實際那行 log 寫的是 discount rule not found,前者差一個底線就全空,後者剛好落在裡面。
它沒有變聰明,是賭得比較保守。 這也是為什麼工具查不到的時候要回傳原因而不是空陣列——它下一步怎麼改,全看你回了什麼給它。
把每一輪的 token 印出來:
| 輪次 | 輸入 | 輸出 |
|---|---|---|
| 1 | 786 | 10 |
| 2 | 1,164 | 29 |
| 3 | 1,235 | 34 |
| 4 | 1,310 | 231 |
| 合計 | 4,495 | 304 |
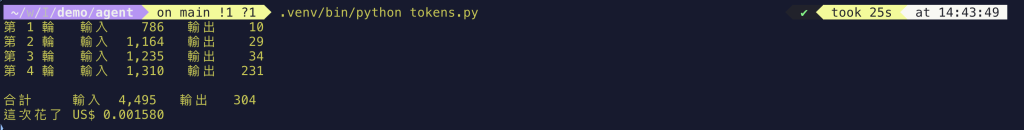
gemini-3.1-flash-lite 付費價是每百萬 token 輸入 0.25 美元、輸出 1.50 美元,所以這次是 0.0016 美元,大約台幣五分錢。
要看的是輸入那欄:786、1,164、1,235、1,310。每一輪都把前面整段對話重送一次,四輪加起來 4,495,但我真正問的只有一句話,多出來的全是重送的歷史和工具回傳值。
輸出那欄要到最後一輪才跳到 231——前三輪它只是說「我要呼叫哪個工具」,最後一輪才在寫答案。
這就是為什麼工具要先幫回傳值瘦身,也是為什麼明天要把 token 變成一個要監控的指標。
不重啟、不回滾、不靜音告警。 它只讀資料、只輸出文字。
這不是靠 system prompt 叮嚀的,是靠第 4 步——我沒給它那些工具,它就沒有。
理由三個:
另外解釋一個命名:這三天叫「Agent」不叫「維運自動化」。差別是自動化是它替你做事,我做的是它替你解釋事情。
明天把這隻 agent 接進前面二十四天蓋的觀測系統——因為它也是一個會壞的服務,而且今天已經看到它壞的兩種方式了。


 iThome鐵人賽
 看影片追技術