

今天實作DPO~
DPO 透過巧妙的數學推導,證明了不需要 Reward Model,有興趣可以參考Day9。
DPO直接拿偏好資料(Preference Data)來微調模型。也就是說,語言模型本身就兼任了獎勵評估的角色。
這邊展示一組,包含prompt、chosen、rejected
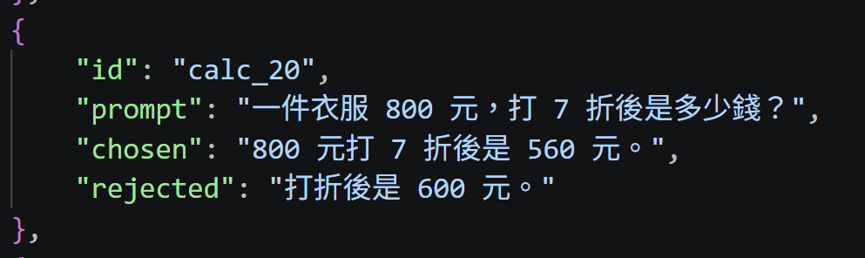
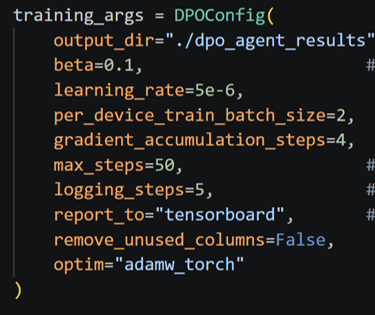
在做 DPO 時,我們的目標是讓模型學會分辨好壞。但如果我們只給模型這個目標,它非常容易發生Reward Hacking、Policy collapse。
我們需要 beta 這個超參數,讓模型不要走火入魔,此參數用來控制Agent 模型在學習新偏好時,能跑離原本的Reference Model多遠。
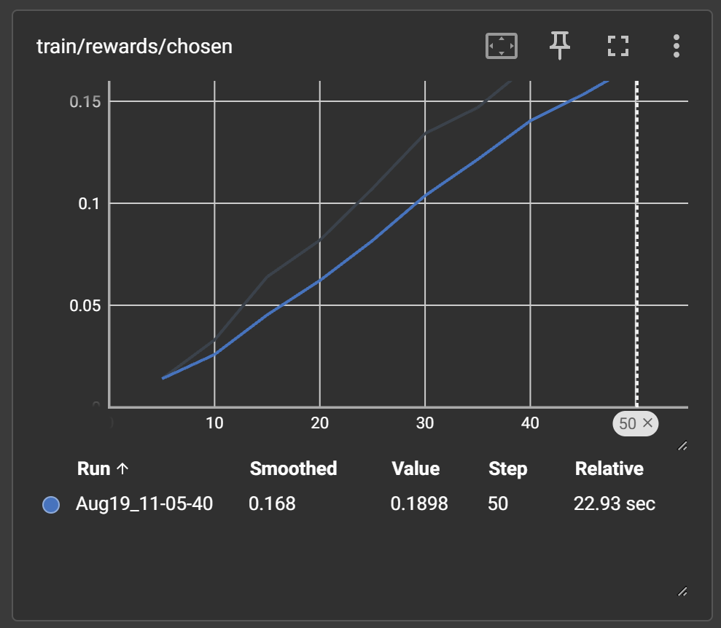
看到這條線隨著訓練步數穩步上升。代表模型越來越傾向產生正確呼叫工具的文本。
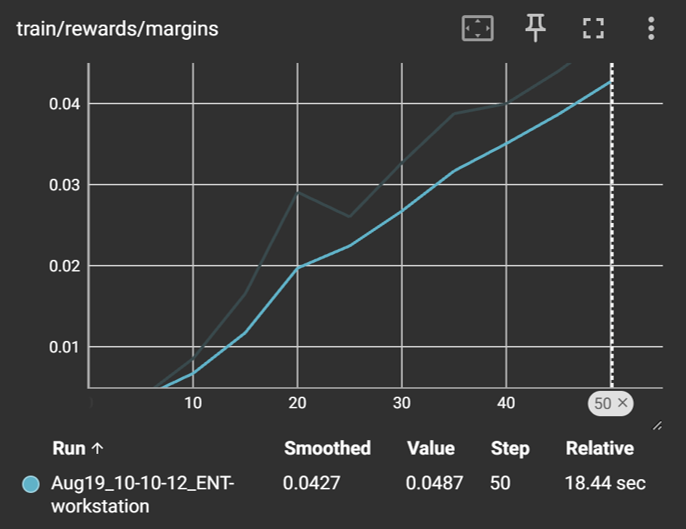
這是 Chosen 和 Rejected 兩者的差值。我們可以看到這條線呈現非常漂亮的上升趨勢。Margin 穩定變大,就代表模型成功學會了分辨對錯!
硬體資源用量: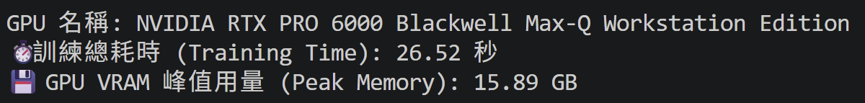
https://github.com/crazyainfuture/AI-Agent-RL/tree/master/DPO
這份數據證明了:Agent 成功建立起了正確的偏好,它現在已經能清楚分辨出什麼是好的工具呼叫策略了!
明天會先整理這幾天訓練時踩過的坑!
🧪 Experiment Summary
| 項目 | 內容 |
|---|---|
| Model | Llama-3.1-8B-Instruct |
| Method | DPO |
| Evaluation | Success Rate:73.33% Tool Accuracy:73.33% Average Invalid Calls:0.23 Avg Steps:3.633 |
| Peak VRAM | 15.46 GB |
| Dataset | 30 Agent Tasks |


 iThome鐵人賽
 看影片追技術