
深拷貝不只是一層層往下複製。structuredClone() 先把資料序列化成一份記錄,再重建出全新的資料;它保留 Date、Map 等型別與資料內部的引用關係,但 function、class 方法這類不是資料的東西帶不過去。
前置知識:理解 object reference 與淺拷貝;讀過 Day 23 的 toReversed()/with() 更好;用過 JSON.stringify()/JSON.parse() 即可。
學習路線:Day 23–25 都在談 copy,一篇比一篇往下一層。Day 23 只換了外層 Array;今天把 copy 推進到整份資料,並看清哪些東西複製不過去。
標籤:structuredClone Deep Copy Serialization JSON DataCloneError
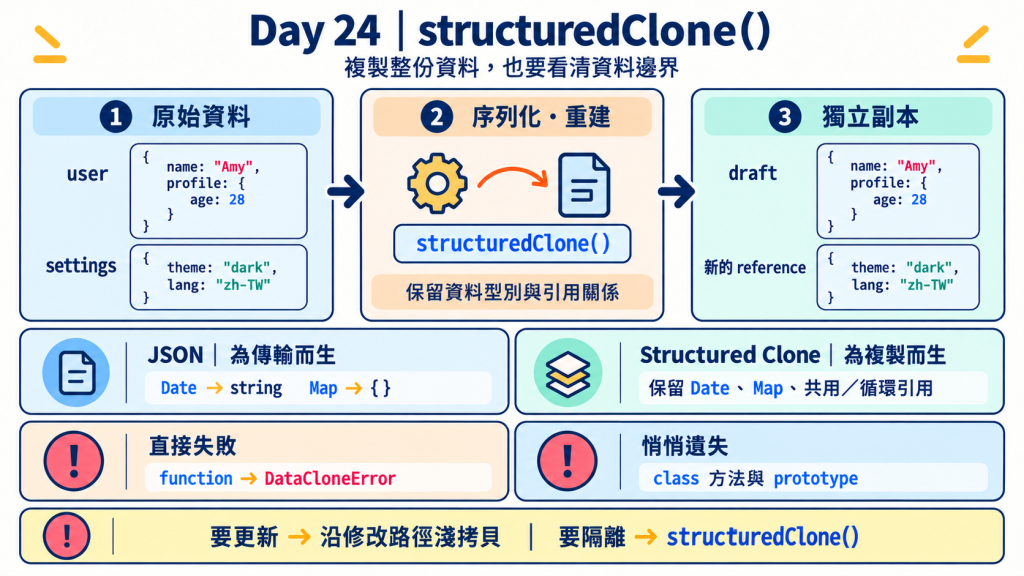
structuredClone() 建立一份可以放心修改的編輯草稿。structuredClone() 適合複製。structuredClone(),什麼時候該沿修改路徑做淺拷貝。延續 Day 23 的使用者列表。列表已經用 toSorted() 排好,現在使用者點進其中一位,開啟「編輯個人資料」表單。
使用者最後可能按下「取消」,所以編輯過程不能直接改到原始資料。我們需要先建立一份草稿,讓表單上的修改只發生在草稿裡。
但 Day 23 介紹的 copy methods 只會換掉最外層:
const copied = users.toReversed();

copied === users;       // false:外層 Array 是新的
copied[0] === users[1]; // true:裡面的 user 仍是同一個 object
copied 和 users 雖然是不同的 Array,裡面的 user object 卻仍然共用同一個 reference。假如表單修改的是 user object:
copied[0].name = 'May';

users[1].name; // 'May'
原始的 users 也會跟著改變。更深一層的 settings 當然也有同樣的問題。
編輯草稿需要的不是只換掉外層的副本,而是一份連內部資料都彼此獨立的副本,這種複製通常稱為「深拷貝」。
而 JavaScript 已經提供了一個直接完成這件事的工具:
structuredClone(value);
structuredClone() 建立編輯草稿把使用者點開的那一位複製成草稿:
const user = {
  name: 'Rafael',
  settings: {
    theme: 'dark',
    fontSize: 16,
  },
};

const draft = structuredClone(user);

draft === user;                   // false:外層是新的
draft.settings === user.settings; // false:裡面的 settings 也是新的
接著在草稿上任意修改:
draft.name = 'May';
draft.settings.theme = 'light';

user.name;           // 'Rafael'
user.settings.theme; // 'dark'
表單上的修改都只發生在 draft 裡。按下「取消」,直接丟掉 draft 就好,user 從頭到尾沒被動過;按下「儲存」,再用 Day 23 的 with() 把草稿放回列表,產生下一個版本:
const nextUsers = users.with(index, draft);
不過在 structuredClone() 出現之前,JavaScript 開發者常用這段程式做深拷貝:
const copy = JSON.parse(JSON.stringify(value));
既然兩種寫法看起來都能複製 object,為什麼還需要
structuredClone()?答案不只是哪一個支援的型別比較多,而是它們從一開始就在完成兩種不同的工作。
以前串 API 時,拿到的資料要先 parse 才能用;要把物件送上網路,又得先轉成字串。我一直把這兩步當成必經流程,知道要做,卻不太理解它們各自在做什麼、又差在哪裡。
其實這兩步就是反序列化與序列化。弄懂它們,也就能看懂 JSON 和 structuredClone() 的差別。
以第一節的 user 來說,外層 object 的 settings 存的是一個 reference,也就是一條指向另一個 object 的箭頭:
user
 └─► { name: 'Rafael', settings: ● }
                                 │
                                 ▼
                     { theme: 'dark', fontSize: 16 }
這條箭頭只在目前的執行環境裡有意義。要把資料送上網路、存進檔案或交給 Web Worker,就得先把它攤平成一串可以帶走的內容,這叫序列化(serialize)。箭頭的處理方式很直接:不寫箭頭,改寫箭頭指向的內容。
{"name":"Rafael","settings":{"theme":"dark","fontSize":16}}
拿到這串內容,照著重新建立 object,叫反序列化(deserialize)。每讀到一個 { 就建立一個新 object,再重新接上箭頭。舊的箭頭從來沒被帶過去,所以結果自然是深拷貝。
可以想成搬家:把家具拆開裝箱、附上說明書,到新家再照說明書組回去。組回來的是新家具,而說明書能寫什麼,決定了能組回什麼。
至於 toString() 這類方法,不必寫進說明書。它們放在所有 object 共用的原型 Object.prototype 上,反序列化只要把新 object 接上環境內建的原型,就能借用:
const parsed = JSON.parse('{"name":"Rafael"}');

Object.hasOwn(parsed, 'toString'); // false:不在自己身上
typeof parsed.toString;            // 'function':從原型借來的
規格裡,JSON.parse() 就是把文字當成 object literal 來執行,得到的 object 和直接寫 { name: 'Rafael' } 一樣。就像螺絲起子不必跟著家具寄,新家本來就有;但新家只有內建的工具,自訂 class 的方法就沒有了,第五節會再看到。
JSON.stringify() 是序列化,結果是一段字串;JSON.parse() 是反序列化。JSON 的寫法借自 JavaScript,但它是獨立的文字格式,Python、Go、Java 都能讀寫,所以 API 和設定檔大多用它。
為了讓每種語言都看得懂,JSON 能寫的東西刻意很少:
| JSON 能寫的 | 寫出來的樣子 |
|---|---|
| object | {"name":"Rafael"} |
| array | ["js","css"] |
| string | "Rafael" |
| number | 42 |
| boolean | true、false |
| null | null |
沒有 Date、Map、undefined,也寫不出「這裡和前面那個是同一個 object」。遇到這些值,JSON.stringify() 只能換掉、略過或丟出錯誤;JSON.parse() 讀回來時,已經不知道原本是什麼。
structuredClone() 同樣先序列化、再反序列化,但說明書是寫給另一個 JavaScript 環境看的,例如同一個頁面或 Web Worker:
原本的 JavaScript 資料圖
        │ StructuredSerialize     序列化成記錄
        ▼
與執行環境無關的序列化記錄
        │ StructuredDeserialize   從記錄反序列化
        ▼
新的 JavaScript 資料圖
中間這份說明書,規範裡稱為序列化記錄。它不是文字,也不會交到我們手上。既然讀的一方也懂 JavaScript,它能寫得更細:
Date、Map、Set、BigInt、undefined 等。JSON 保留的是能寫進 JSON 文字的內容;Structured Clone 重建的是資料內容,以及資料之間的連線關係。
structuredClone() 為複製而生兩者都會序列化、反序列化,但出發點不同:
JSON.stringify()/JSON.parse() |
structuredClone() |
|
|---|---|---|
| 設計來做什麼 | 把資料變成文字,送給伺服器、其他語言或寫進檔案 | 在 JavaScript 環境裡建立一份副本 |
| 說明書給誰看 | 任何語言 | 另一個 JavaScript 環境 |
所以
JSON.parse(JSON.stringify(value))其實是借用一個傳輸格式來做複製:資料先被翻譯成各種語言都懂的文字,再翻譯回來。翻譯時,JSON 寫不出來的東西就會被換掉、略過或直接報錯。
下面三個例子,都是這個「翻譯損失」。
Date 變成字串const source = {
createdAt: new Date('2026-09-01T08:00:00Z'),
};
const jsonCopy = JSON.parse(JSON.stringify(source));
const clone = structuredClone(source);
console.log(jsonCopy.createdAt instanceof Date);
// false
console.log(clone.createdAt instanceof Date);
// true
console.log(typeof(jsonCopy.createdAt)) // string
console.log(typeof(clone.createdAt)) // object
JSON 只留下日期的文字表示;structuredClone() 則保留 Date 這個值的型別與時間值。
Map 不是 JSON objectconst source = {
scores: new Map([
['Rafael', 90],
['Mina', 95],
]),
};
const jsonCopy = JSON.parse(JSON.stringify(source));
const clone = structuredClone(source);
console.log(jsonCopy.scores);
// {}
console.log(clone.scores instanceof Map);
// true
console.log(clone.scores.get('Mina'));
// 95
為什麼 JSON 會得到空的 {}?
JSON.stringify() 處理 object 時,只會把它自己身上的可列舉 property 寫成 "key": value。可是 Map 的 entries 不是 property,而是存在 Map 內部、只能透過 get()、set() 或迭代存取的資料:
const scores = new Map([['Rafael', 90]]);

Object.keys(scores);
// []:身上沒有任何 property

JSON.stringify(scores);
// '{}'
JSON 看不到 entries,自然寫不出來。Set 也一樣,會變成 {}。
{}、[]這種直接寫在程式碼裡的值叫字面量(literal),JSON 的格式就是從這種寫法來的。Map、Set沒有字面量,只能用new Map()、new Set()建立,因為它們本來就不是「另一種寫{}或[]的方式」,而是有自己的規則:Map的 key 可以是任何值,Set會自動排除重複。
JSON 沒有描述這些規則的寫法,所以真的要用 JSON 傳 Map,得自己先轉成 JSON 寫得出來的形式,例如 Object.fromEntries(scores) 或 [...scores],收到後再轉回來。
undefined 與 BigInt 也反映出格式邊界const source = {
note: undefined,
amount: 10n,
};
const clone = structuredClone(source);
console.log('note' in clone);
// true
console.log(clone.amount);
// 10n
structuredClone() 能保留這兩個 JavaScript 值,JSON 則各有各的問題。
undefined:JSON 能寫的值裡沒有 undefined,所以 object 裡值為 undefined 的 property 會直接被略過,JSON.stringify({ note: undefined }) 得到的是 '{}'。
BigInt:平常比較少碰到,先認識一下。
JavaScript 一般的數字是
Number,但它能精確表示的整數有上限,也就是Number.MAX_SAFE_INTEGER(9007199254740991)。超過之後,數字可能會悄悄變成相鄰的另一個:
9007199254740993;
// 9007199254740992
BigInt 就是用來表示任意大整數的型別,寫法是在數字後面加上 n:
9007199254740993n;
// 9007199254740993n:精確保留
實務上最常遇到的,是資料庫的 64 位元 ID,或以最小單位計算的金額這類超出安全範圍的大整數。
那 JSON 為什麼不乾脆把 10n 寫成 10?因為讀回來時,JSON.parse() 會把數字一律變成 Number:
JSON.parse('{"id":9007199254740993}').id;
// 9007199254740992
如果
JSON.stringify()默默把 BigInt 寫成數字,讀回來就變成Number:型別不對,大數字還會失去精確度,而且不會有任何錯誤提示。所以規格選擇直接丟出TypeError,寧可一開始就失敗,也不要悄悄把資料改錯:
JSON.stringify({ amount: 10n });
// TypeError: BigInt value can't be serialized in JSON
要用 JSON 傳大整數,常見做法是先轉成字串,收到後再轉回 BigInt:
const text = JSON.stringify({ id: 9007199254740993n.toString() });
// '{"id":"9007199254740993"}'

BigInt(JSON.parse(text).id);
// 9007199254740993n
這不代表 JSON 設計得不好。JSON 的優點正是格式簡單、跨語言而且適合變成文字;只是「JavaScript 能表示的所有值」本來就不是 JSON 的目標。
| 問題 | JSON.parse(JSON.stringify(value)) |
structuredClone(value) |
|---|---|---|
| 設計目的 | 傳輸:轉成 JSON 文字後再解析 | 複製:建立可序列化 JavaScript 資料的副本 |
| 產物是否有中間文字 | 有 | API 不回傳中間文字 |
Date |
變成字串 | 保留 Date |
Map、Set |
不保留 entries 的原型別 | 保留型別與內容 |
undefined |
object property 會消失 | 保留 |
BigInt |
丟出 TypeError |
保留 |
| 適合寫進檔案或送給只懂 JSON 的 API | 是 | 否,它不是文字格式 |
一句話記:要把資料送出去,用 JSON;要在程式裡複製一份,用 structuredClone()。
到這裡只比較了「資料內容」。下一個問題更深入:如果兩個 property 原本指向同一個 object,複製後還會是同一個嗎?
我原本以為,深拷貝 API 要做的事很單純:遇到 object 就剝開一層,把裡面的值一個個複製下去,直到最底層為止。
但實際想下去,要考慮的事情不少🤠:
這一節就照這個順序,一層一層看下去。
先看最常見的展開運算子:
const profile = {
  name: 'Rafael',
  settings: {
    theme: 'dark',
  },
};

const copiedProfile = { ...profile };

console.log(copiedProfile === profile);
// false

console.log(copiedProfile.settings === profile.settings);
// true
spread 建立了新的外層 object,但兩邊的 settings 仍指向同一個 object:
profile ────────┐
                 ├──► settings object
copiedProfile ──┘
所以修改 copiedProfile.settings.theme,原資料也會跟著變。這就是淺拷貝的邊界。
structuredClone(profile) 則會建立新的巢狀 settings:
const clone = structuredClone(profile);

console.log(clone.settings === profile.settings);
// false
但如果只把深拷貝理解成「遇到巢狀 object 就繼續往下複製」,下一個案例就會出問題。
const settings = { theme: 'dark' };

const source = {
  desktop: settings,
  mobile: settings,
};
在來源裡,desktop 與 mobile 指向同一個 object:
console.log(source.desktop === source.mobile);
// true
如果只是每遇到一個 property 就遞迴複製,settings 可能被複製兩次,原本我們習慣的物件「共用設定」的意思就消失了,兩次的物件變成獨立個體了,即便原本資料指向語意是同一份。
JSON 文字沒有 reference 可以表達這個關係:
const jsonCopy = JSON.parse(JSON.stringify(source));

console.log(jsonCopy.desktop === jsonCopy.mobile);
// false
Structured Clone 會保留原本的連線關係:
const clone = structuredClone(source);

console.log(clone.desktop === clone.mobile);
// true

console.log(clone.desktop === settings);
// false
它建立了一個新的 settings,但 clone 裡的兩條路仍共同指向那個新 object。要注意,它保留的是資料內部彼此的連線,不是和原資料的連線:
| 哪一種連線 | JSON | Structured Clone |
|---|---|---|
| 副本和原資料之間 | 切斷 | 切斷 |
| 資料內部「兩處指向同一個 object」 | 消失,變成兩份 | 保留,指向同一個新 object |
這份記錄只在 JavaScript 環境之間傳遞,例如同一個頁面、Web Worker 或 IndexedDB,不會變成 JSON 走網路。從 API 拿到的 JSON,這層關係早在對方序列化成 JSON 文字時就消失了,收到後也找不回來。
HTML Standard 在 StructuredSerializeInternal 開頭就寫明了目的:同一個 object 不要序列化兩次。這個規則一次帶來三個好處。
一、副本的行為和原本一致。 在 source 裡,desktop 和 mobile 共用同一份設定,改一邊,另一邊也會變。「是不是同一個」本身就是資料的意義。如果複製成兩份,副本看起來一樣,改起來的行為卻不同:
clone.desktop.theme = 'light';
clone.mobile.theme;    // 'light':和原資料一樣,仍是共用設定

jsonCopy.desktop.theme = 'light';
jsonCopy.mobile.theme; // 'dark':共用關係不見了
二、循環引用不會無限遞迴。 如果每遇到一個 object 就往下複製,碰到「走著走著又指回自己」的資料會永遠停不下來。記住看過哪些 object,才能正常結束。下一個進階補充會看到這個例子。
三、資料量不會爆炸。 共用的 object 每次都複製一份,大小可能呈指數成長:
let node = { value: 1 };

for (let i = 0; i < 20; i++) {
  node = { left: node, right: node };
}
每一層的
left、right都指向同一個下一層。structuredClone(node)只會建立 21 個 object;JSON.stringify(node)卻會把共用的部分展開 2²⁰ 次,產生約 3000 萬個字元的文字。
一般表單、API response 與前端 state,通常不需要刻意設計成循環引用。它不容易轉成 JSON,也會讓遞迴處理與除錯變複雜。
這裡介紹它,不是鼓勵日常資料這樣設計,而是用一個極端案例看出:JSON 處理的是可寫成文字的資料,Structured Clone 處理的是 object graph。
const node = { name: 'root' };
node.self = node;

const clone = structuredClone(node);

console.log(clone.self === clone);
// true
JSON 無法用一般文字表示「走著走著又指回自己」,所以:
JSON.stringify(node);
// TypeError: Converting circular structure to JSON
Structured Clone 則能重建這條回到自己的連線。知道這個結果即可;多數應用不需要主動建立循環資料。
memory 記錄HTML Standard 的 Structured Clone Algorithm 在序列化時會維護一份 memory:
已經看過的來源 object
        ↓ 對應
它的序列化記錄
第一次遇到某個 object 時,演算法把對應記錄放進 memory;再次遇到同一個 object,就重用那筆記錄,而不是複製第二次。以 source 為例,概念上像這樣:
#1 Object { desktop: → #2, mobile: → #2 }
#2 Object { theme: 'dark' }
這只是示意,實際記錄的格式由瀏覽器自己決定。
反序列化時也有另一份對應的 memory:
序列化記錄
        ↓ 對應
已經建立的新 object
因此重複引用會指向同一個新 object,循環引用也能接回正在建立的 object。這是規範要求的結果,但使用 API 時不需要自己管理這份 memory。
常見的入門說法會把變數與 object 畫成:
stack                         heap
┌────────────────┐           ┌─────────────────────┐
│ source         │──────────►│ 外層 object          │
└────────────────┘           │ desktop ─┐          │
                             │ mobile ──┴─► settings│
                             └─────────────────────┘
clone 之後,可以想成另一組新的 object:
stack                         heap
┌────────────────┐           ┌─────────────────────┐
│ clone          │──────────►│ 新的外層 object      │
└────────────────┘           │ desktop ─┐          │
                             │ mobile ──┴─► 新設定  │
                             └─────────────────────┘
這張圖想表達的是:clone 不再指向來源 object,但 clone 內部原有的共享關係仍然存在。
不過要加上一個重要但不難懂的註記:
「變數放 stack、object 放 heap」是協助理解 reference 的簡化心智模型,不是 ECMAScript 或 Structured Clone 規範要求的實際記憶體配置。
JavaScript engine 可以用不同方式最佳化記憶體。規範保證的是我們能觀察到的結果:哪些值相等、哪些 reference 相同,以及循環關係是否保留。
這裡可以把整段濃縮成一句話:
JSON 解析後得到的是符合文字內容的新資料 tree;Structured Clone 重建的是一份新的 object graph。
structuredClone() 會先把資料寫成一份序列化記錄,再照記錄重建。就像搬家的說明書,一個值能不能複製,取決於它能不能寫進這份記錄。
先用實務上的分法,而不是硬背長清單。
| 類型 | structuredClone() |
重點 |
|---|---|---|
primitive(含 undefined、BigInt) |
可以 | 不需要共享 reference |
| Array、plain object | 可以 | 遞迴重建內容 |
Date、RegExp |
可以 | 保留這類內建值的資料 |
Map、Set |
可以 | entries 也會遞迴處理 |
ArrayBuffer、TypedArray |
可以 | 預設是複製;可選擇 transfer |
function、Symbol |
不可以 | 會丟 DataCloneError |
| DOM node | 不可以 | 會丟 DataCloneError;DOM 不是一般資料快照 |
| 自訂 class instance | 不要假設可保留 class 行為 | 要特別檢查 prototype/方法需求 |
最常踩到的是 function:
const user = {
  name: 'Rafael',
  greet() {
    return `Hi, ${this.name}`;
  },
};

structuredClone(user);
// DOMException: DataCloneError
這很合理。function 不只是資料;它還帶有可執行程式碼、閉包與所在環境。Structured Clone 的目標是安全地搬運或快照資料,不是複製執行中的程式。
可以把這條界線記成:
能被拿去傳遞、儲存、重建的資料,通常適合 structured clone;程式行為、DOM 與執行環境,通常不適合。
假設我們有:
class Cart {
  constructor(items) {
    this.items = items;
  }

  total() {
    return this.items.reduce((sum, item) => sum + item.price, 0);
  }
}

const cart = new Cart([
  { name: 'Book', price: 300 },
]);

const clone = structuredClone(cart);

console.log(clone instanceof Cart);
// false
資料還在,方法卻不見了:
clone.items;
// [{ name: 'Book', price: 300 }]

clone.total;
// undefined
回想第二節:反序列化不會複製方法,只會把新 object 接到環境內建的原型上。而序列化記錄能寫的型別都是內建的,例如 Object、Array、Date、Map,沒有一種能寫「這是一個 Cart」。
所以 cart 只會被記成一般的 Object,組回來接上的是 Object.prototype;total() 所在的 Cart.prototype 沒有被記下來,自然接不回去:
Object.getPrototypeOf(clone) === Object.prototype;
// true
就像新家有內建的螺絲起子,卻沒有你自己訂做的那把工具。
因此 structuredClone() 適合用在 data object;若領域模型依賴 class 的 methods、private fields 或 prototype,通常應由 class 自己提供明確的序列化/重建方式。
structuredClone() 不是 state update 的預設解看到深拷貝這麼好用後....容易產生那我需要更新資料把整份資料複製就行?:
const nextState = structuredClone(state);
nextState.user.settings.theme = 'light';
它的確可行,但通常不應是每次更新 state 的第一選擇。Day 23 比較三種更新做法時,這種「整份深拷貝再改」就是被當成反例的那一種,原因有三個:
這和第一節的編輯草稿並不矛盾。
草稿要的是一份和原資料完全切開的副本,改了、丟了都不影響原資料;state update 要的則是下一個版本,應該和舊版本共用沒改的部分。同一個工具,用在需要隔離的地方是對的,用在每次更新就是用錯了地方。
當更新路徑清楚時,還是優先寫出有意圖的淺拷貝:
const nextState = {
  ...state,
  user: {
    ...state.user,
    settings: {
      ...state.user.settings,
      theme: 'light',
    },
  },
};
這段確實比較長,但它精準表達:只有 user.settings.theme 這條路徑改變。
若資料結構太深以至於這樣寫難以維護,下一步通常是調整資料 shape、使用能處理 immutable update 的工具,或把需要隔離的資料在邊界處 clone;不是不加思考地把每次更新都換成 structuredClone()。
回到開頭的編輯草稿:我們需要一份連內部都獨立的副本,structuredClone() 做到了,但它做的不只是「一層層剝開複製」。今天的重點可以收成四句:
structuredClone() 為複製而生:要把資料送出去用 JSON,要在程式裡複製一份用 structuredClone()。DataCloneError,或不報錯卻悄悄遺失,例如 class 的方法。和 Day 23 放在一起看,每種做法保證的 copy 範圍都不同:
| 需求 | 做法 | 新的範圍 |
|---|---|---|
| 排序、反轉、替換 Array 的結果 | toSorted()、toReversed()、with() |
外層 Array |
| 只改某個已知的巢狀欄位 | 沿更新路徑做 spread | 修改路徑上的 object |
| 需要一份完全獨立的副本或快照 | structuredClone() |
整份可序列化資料 |
| 要保留 class 方法、function、DOM reference | 自己設計資料格式與重建流程 | 不要依賴 structuredClone() |
這張表背後只有一個問題:
這份資料接下來是要被「更新」,還是需要「隔離」?
理解「copy 到哪一層」,也就是程式實際要做的意圖,往往比記住任何 API 名稱更重要...。
MDN — Serialization
序列化與反序列化的名詞解釋,對應第二節的「攤平成一串、再照著重建」。
RFC 8259 — The JavaScript Object Notation (JSON) Data Interchange Format
JSON 格式的規範;第 3 節列出 JSON 只有 object、array、number、string、true、false、null 這幾種值。同一份格式也由 ECMA-404 定義。
MDN — JSON
JSON 格式與 JavaScript 語法的差異,以及 JSON.stringify()、JSON.parse() 的用法。
ECMAScript Language Specification — JSON.parse() 與 JSON.stringify()
JSON 解析與序列化行為的 ECMAScript 規範來源。
HTML Standard — Safe passing of structured data
Structured Clone Algorithm、Structured cloning API 與 DataCloneError 的規範來源;第二節圖中的 StructuredSerialize 與 StructuredDeserialize 也定義在這裡。
HTML Standard — StructuredSerializeInternal
說明 memory 的目的是避免同一個 object 被序列化兩次,因而保留循環引用與重複 object 的同一性,對應第四節的「為什麼要這樣設計?」。
MDN — The structured clone algorithm
Structured Clone 支援與不支援的型別,對應第五節的表格;也提到遞迴時會記住看過的 reference,避免在循環中無限走訪。
MDN — structuredClone()
API 使用方式、瀏覽器相容性與實務範例。


 iThome鐵人賽
 看影片追技術