

Uint8Array 這類 TypedArray 名字裡有 Array,卻不是一般 Array;它不是自己保存一串數字,而是用某種數值型別「觀看」一段 ArrayBuffer 裡的 bytes。理解「buffer 擁有、view 觀看」這組關係,就能分清 bytes 什麼時候是共用、複製,還是移交。
前置知識:熟悉一般 Array 與 index 存取,理解 reference 與淺拷貝;讀過 Day 23 的 toSorted()/with() 與 Day 24 的 structuredClone() 會更好。
學習路線:Day 23–25 的 copy 三部曲最後一篇。Day 23 複製外層 Array,Day 24 複製整份資料圖;今天往下到 bytes 層,先認識 ArrayBuffer 與 Uint8Array,再看 bytes 什麼時候共用、複製、移交。
標籤:TypedArray ArrayBuffer Uint8Array View Transfer Binary Data
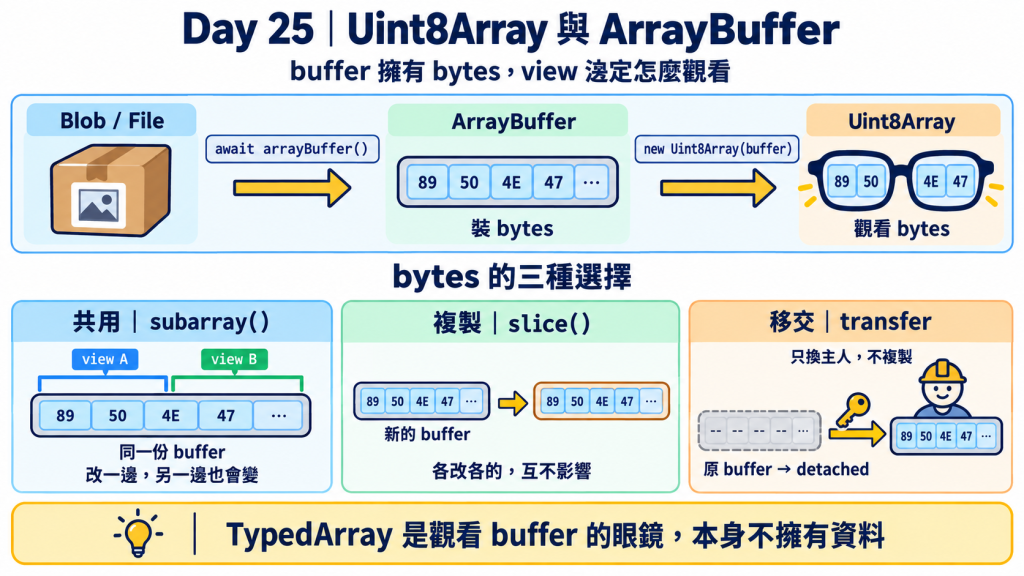
Blob、ArrayBuffer 與 Uint8Array,分辨什麼時候只要搬運 Blob、什麼時候要把 bytes 讀出來。view.buffer 判斷一個操作是共用、複製還是移交 bytes,並依意圖選擇 subarray()、slice() 或 transfer。在前端世界裡,使用者選了一張新的大頭貼,我們要讀取圖片內容,之後再交給 Web Worker 壓縮。在 JavaScript 裡,要讀取圖片、檔案的內容,最常用的就是 Uint8Array。
其實我們在之前的文章早就見過它:
Day 14 用 for await...of 讀 fetch() 的 response.body 時,每個 chunk 印出來都是 Uint8Array(6) [104, 101, 108, 108, 111, 10] 這樣的一串數字。當時我們只把它解碼成文字,沒有追問它到底是什麼;今天就來補上這一塊,好好面對心中的這一塊疑問😅,雖然很多基礎知識要補,還是保持好奇心和耐性吧~
它用起來很像 Array:能用 index 讀寫、有 length、有 map()、forEach(),連 Day 23 的 toSorted()、toReversed()、with() 都有。既然這麼像,先做一個最基本的確認:
const numbers = [10, 20, 30];
const bytes = new Uint8Array([10, 20, 30]);

Array.isArray(numbers); // true
Array.isArray(bytes);   // false
看起來處處像 Array,Array.isArray() 卻直接說「不是」。
看起來
Uint8Array屬於另一個家族:TypedArray,它和一般 Array 從根本的資料模型就不同。這個差異會一路影響到今天的主題:bytes 什麼時候是共用、什麼時候是複製、什麼時候是整個交出去。
先從最基本的開始:Uint8Array 讀寫的 bytes 放在哪裡?
Blob、ArrayBuffer 和 Uint8Array 是什麼?如果你平常處理的都是字串、數字和 JSON,可能沒碰過這三個名字。跟我一樣先花一點時間認識它們🤗~
電腦裡的資料,最後都是一串 bytes。
最小的單位其實是 bit:每個 bit 只能是 0 或 1,像一個 true/false 開關。8 個 bit 排在一起就是 1 個 byte,可能的組合有 2⁸ = 256 種,剛好對應 0–255:
00000000 → 0
00000001 → 1
01001000 → 72   ('H')
10001001 → 137  (PNG 圖檔的第一個 byte)
11111111 → 255
這種只用 0 和 1、逢二進一的寫法就是二進位。每一位代表一個 2 的次方,由右到左依序是 1、2、4、8、16、32、64、128;把是 1 的位數加起來就是十進位的數字,例如 137 = 128 + 8 + 1。
二進位寫起來太長,程式裡更常用十六進位:每一位有 0–9、A–F 共 16 種值,前面加上 0x 表示。
十進位、二進位、十六進位不是三種轉換,而是同一個值的三種寫法;byte 本身完全沒變,就像我們平常說話上在描述「12」和「一打」說的是同一個數量。
十六進位特別適合 byte,是因為 16 = 2⁴:4 個 bit 剛好對應一個十六進位數字。換算時只要每 4 個 bit 切一組:
十進位      137
二進位      1000 1001
            ────  ────
十六進位      8     9    → 0x89
1 個 byte 是 8 個 bit,永遠剛好切成兩組,所以固定寫成兩位:72 是 0100 1000 → 0x48,255 是 1111 1111 → 0xFF。十進位就沒有這個性質,137 的 1、3、7 和它的 bit 沒有對應關係。
而在 JavaScript 世界裡,三種寫法都是同一個值:
137 === 0b10001001; // true:0b 開頭是二進位
137 === 0x89;       // true:0x 開頭是十六進位

(137).toString(2);  // '10001001'
(137).toString(16); // '89'
之後看到 0x89 這種寫法,指的都是同一個 byte。
電腦存取資料以 byte 為基本單位,記憶體也是每個 byte 一個位址。文字、圖片、音樂、壓縮檔,存進硬碟或送上網路時,都是一長串 0–255 的數字;差別只在「怎麼解讀」。
平常寫前端很少直接碰 bytes,因為瀏覽器已經幫我們解讀成字串、圖片或 JSON。可是一旦要處理「檔案本身」,例如讀取使用者上傳的圖片、計算檔案雜湊,或和 Web Worker 交換大量資料,就得直接面對 bytes。
Blob:封好的檔案包裹使用者用 <input type="file"> 選的檔案、用 res.blob() 從後端下載的 PDF 或 Excel,拿到的都是 Blob。input.files[0] 是 File,它是 Blob 的子類別,多了檔名和修改時間:
const file = input.files[0];

file instanceof Blob; // true
file.size;            // 245760:有幾個 bytes
file.type;            // 'image/png':MIME type
Blob就像一個封好的包裹:外面的標籤寫著大小和類型,裡面的內容不能修改,也不能用file[0]讀到某個 byte。它的 bytes 甚至不一定在 JavaScript 的記憶體裡,瀏覽器可以把大檔案留在磁碟上,等真的需要時才讀。
而且 Blob 不看內容。type 只是一張標籤,Blob 不會檢查裡面是不是真的符合:
new Blob([new Uint8Array([1, 2, 3])], { type: 'image/png' });
// 可以建立,但裡面根本不是 PNG
這正是它的用途:只是搬運檔案時,根本不需要打開它。
// 預覽圖片
img.src = URL.createObjectURL(file);

// 上傳給後端
const form = new FormData();
form.append('avatar', file);
await fetch('/api/avatar', { method: 'POST', body: form });
從頭到尾沒碰過任何一個 byte。只有要看或處理內容時,例如判斷是不是 PNG、計算雜湊、交給 Worker 壓縮,才需要把 bytes 讀出來。
ArrayBuffer:一塊裝 bytes 的記憶體ArrayBuffer 就是 JavaScript 裡「一段固定長度的 bytes」。Blob 的 arrayBuffer() 會把整個檔案讀進記憶體,回傳的就是 ArrayBuffer:
const buffer = await file.arrayBuffer();

buffer.byteLength; // 例如 245760:這張圖有 245,760 個 bytes
但它只負責裝 bytes,不提供讀寫單一 byte 的方式:buffer[0] 只會得到 undefined。
ArrayBuffer和Blob最大的差別,在於「bytes 在不在手上」:
Blob |
ArrayBuffer |
|
|---|---|---|
| 內容在哪 | 不一定,可能還在磁碟上 | 一定已經在記憶體裡 |
| 拿到它要多久 | 立刻,不用讀檔 | 要等整份讀完,所以 arrayBuffer() 回傳 Promise |
| 內容能改嗎 | 不能 | 能,透過下面介紹的 view 讀寫 |
| 適合做什麼 | 搬運:預覽、上傳、下載 | 處理:讀取、修改 bytes |
所以 await file.arrayBuffer() 這一行,才是真正「讀檔」的時刻。代價是它一次讀整份:一支 2GB 的影片,就要 2GB 記憶體,可能很慢,甚至直接配置失敗。
如果只需要其中一段,可以先用 slice() 切出一個小 Blob 再讀。Blob 的 slice() 不會讀檔,只是換一張「只提這一段」的包裹標籤:
const head = await file.slice(0, 4).arrayBuffer();

head.byteLength; // 4:只讀了前 4 個 bytes
如果要從頭到尾處理一個大檔案,則可以用 file.stream() 分段讀,每次只拿一小段 chunk,也就是 Day 14 讀 response.body 的同一套方法。
Uint8Array:把 bytes 當成 0–255 的數字來讀寫Uint8Array 是專門用來讀寫 bytes 的「陣列」:每一格就是 1 個 byte,值一定是 0–255 的整數。名字可以拆開讀:
U:unsigned,無號,也就是沒有負數Int8:8 bits 的整數,剛好是 1 個 byteArray:可以用 index 存取,像陣列一樣合起來就是「每一格是一個 8 bits、沒有負數的整數」,也就是前面說的 0–255。
用 index 讀寫每個 byte
const bytes = new Uint8Array(4); // 4 格,預設都是 0

bytes[0] = 72;
bytes[1] = 0x69; // 十六進位寫法也可以,就是 105

bytes;        // Uint8Array(4) [72, 105, 0, 0]
bytes.length; // 4:幾格就是幾個 bytes
三種常見的來源
實務上很少自己一格一格填,Uint8Array 通常是從別處拿到的:
// 1. 從檔案:先讀成 ArrayBuffer,再套上 Uint8Array(兩者的關係,第二節細談)
const fileBytes = new Uint8Array(await file.arrayBuffer());
fileBytes[0]; // 137:PNG 圖檔的第一個 byte 固定是 137(0x89)

// 2. 從文字:TextEncoder 把字串轉成 UTF-8 bytes
const textBytes = new TextEncoder().encode('Hi');
textBytes;    // Uint8Array(2) [72, 105] ← 'H' 是 72,'i' 是 105

// 3. 從網路:Day 14 讀 response.body 時,每個 chunk 就是 Uint8Array
文字的例子最能看出「bytes 只是數字,意義要看怎麼解讀」:同樣的 [72, 105],用 UTF-8 解讀就是 'Hi'。而且字元和 byte 不是一對一,一個中文字在 UTF-8 裡佔 3 個 bytes:
new TextEncoder().encode('中');
// Uint8Array(3) [228, 184, 173]

new TextDecoder().decode(new Uint8Array([72, 105]));
// 'Hi' ← 反過來,把 bytes 解讀回文字
Blob,處理內容用 Uint8Array網路上傳來傳去的都是 bytes,前端拿到什麼形式,取決於你怎麼讀:
| 讀法 | 拿到什麼 |
|---|---|
input.files[0] |
File(Blob 的子類別) |
res.blob()、Axios responseType: 'blob' |
Blob |
blob.arrayBuffer()、res.arrayBuffer() |
ArrayBuffer |
res.body 的每個 chunk(Day 14) |
Uint8Array |
blob.bytes()、res.bytes()(較新的 API) |
Uint8Array |
串起來就是一條由外往內的路:
Blob / File  :封好的包裹,只知道大小與類型,不能逐 byte 讀寫
    ↓ await blob.arrayBuffer()   ← 真正讀檔,整份放進記憶體
ArrayBuffer  :記憶體裡的一段 bytes,本身不能讀寫
    ↓ new Uint8Array(buffer)     ← 不讀檔、不複製,只是套上 view (真的需要觀看每一個byte)
Uint8Array   :用 index 讀寫每個 byte
bytes() 是比較新的捷徑,等於 arrayBuffer() 加上 new Uint8Array() 一次做完;舊環境裡就用兩步的寫法。反過來,處理完的 bytes 也能用 new Blob([bytes], { type: 'image/png' }) 包回 Blob,再拿去預覽或上傳。
這三層都不懂檔案格式,它們只負責把 bytes 交到你手上。真正知道「第幾個 byte 代表什麼」的,是另一層的解析器:
| 層次 | 負責 | 懂格式嗎? |
|---|---|---|
Blob |
包裹:知道大小與類型 | 不懂 |
ArrayBuffer |
拆開包裹,把 bytes 放進記憶體 | 不懂 |
Uint8Array |
把每個 byte 當成 0–255 的數字 | 不懂 |
| 解析器 | 讀這些數字,理解它們代表什麼 | 懂 |
把 Blob 交給 <img>,是瀏覽器的圖片解碼器在解析 PNG;像是如何判斷大頭貼是不是 PNG 的 header[0] === 0x89,就是一個最小的解析器:因為我們知道 PNG 的第一個 byte 固定是 137。
先記住一句話就能往下讀:
Blob是封好的檔案包裹,適合搬運;ArrayBuffer裝 bytes;Uint8Array讓你用 index,把每個 byte 當成 0–255 的數字讀寫。
至於 ArrayBuffer 和 Uint8Array 為什麼要分成兩個東西、Uint8Array 明明長得像 Array 卻又不是 Array,下一節開始拆開來看。
一般 Array 像一個收納盒:東西就放在盒子裡,放什麼都可以。
TypedArray 不是盒子,比較像一副眼鏡:資料放在背後的 ArrayBuffer 裡,TypedArray 只決定「用什麼規則來看這些 bytes」。
| 一般 Array | TypedArray | |
|---|---|---|
| 資料放在哪 | 自己身上 | 背後的 ArrayBuffer |
| 它負責什麼 | 裝資料 | 解讀資料:決定怎麼讀、怎麼寫 |
| 換一種看法 | 沒有這回事 | 同一份 bytes,換一種 TypedArray 就讀出不同的數字 |
實際看一次。準備一份 buffer,再同時戴上兩副眼鏡:
const buffer = new ArrayBuffer(4);       // 4 個 bytes,全是 0,沒辦法直接讀

const unsigned = new Uint8Array(buffer); // 眼鏡一:每格 1 byte,沒有負數(0–255)
const signed = new Int8Array(buffer);    // 眼鏡二:每格 1 byte,有負數(-128–127)

unsigned[0] = 255;

unsigned; // Uint8Array(4) [255, 0, 0, 0]
signed;   // Int8Array(4) [-1, 0, 0, 0]  ← 沒動過 signed,它卻也變了
          同一份 ArrayBuffer(4 bytes)
          ┌────┬────┬────┬────┐
          │ FF │ 00 │ 00 │ 00 │
          └────┴────┴────┴────┘
unsigned:[255,  0,  0,  0]
signed  :[ -1,  0,  0,  0]
這個例子一次說明了兩件事:
new Uint8Array(buffer) 沒有複製任何東西;unsigned[0] = 255 寫進去的其實是 buffer,所以觀看同一份 buffer 的 signed 也看到了。11111111,無號的規則讀成 255,有號的規則把最高位的權重當成 -128,讀成 -1。這和第一節的 137/0x89 不同:那只是換寫法,值不變;view 換的是解讀規則。兩個小細節:
new ArrayBuffer(4) 的 4 是 byte 數;TypedArray 直接傳數字時則是格數,例如 new Uint32Array(4) 是 4 格 × 4 bytes = 16 bytes。new Uint8Array([10, 20, 30]) 是捷徑寫法,會自動配置一份新的 buffer 再填值;傳 buffer 的寫法才是「觀看既有的 bytes」。因為真實世界的資料格式各不相同:有沒有負數、是不是小數、幾個 bytes 算一個數字。JavaScript 為常見的格式各準備了一副眼鏡:
| View | 每格 | 範圍/型別 | 常見用途 |
|---|---|---|---|
Uint8Array |
1 byte | 0–255 | 檔案、網路、UTF-8 文字:最通用的「原始 bytes」 |
Uint8ClampedArray |
1 byte | 0–255,超出時停在邊界 | Canvas 像素(getImageData() 的 RGBA) |
Int16Array |
2 bytes | -32768–32767 | 音訊取樣(WAV 常見的 16-bit PCM) |
Uint32Array |
4 bytes | 0–4294967295 | 大範圍的計數、索引 |
Float32Array |
4 bytes | 小數 | Web Audio 的音訊資料、WebGL 的座標 |
DataView |
自己指定 | 每次讀寫時指定型別 | 檔案標頭這類混合格式 |
每格超過 1 byte 的 view,會把幾個 bytes 拼成一個數字。同一份 4-byte buffer,Uint8Array 看到 4 格,Uint32Array 只看到 1 格。選對眼鏡,拼 bytes、判斷正負號這些麻煩事就由引擎幫你做。
TypedArray 不裝資料,只決定怎麼看。同一份 bytes 可以同時戴上好幾副眼鏡,選哪一副,就是選用哪一種規則去讀它。
最快的方法,是對兩者做一模一樣的事,看結果哪裡不同:
const arr = [0, 0, 0];
const bytes = new Uint8Array(3); // 也是 3 格,預設全是 0

// 1. 放一個字串
arr[0] = 'hi';    // ['hi', 0, 0]
bytes[0] = 'hi';  // [0, 0, 0]     ← 放不進去,變成 0

// 2. 放一個超過 255 的數字
arr[1] = 300;     // ['hi', 300, 0]
bytes[1] = 300;   // [0, 44, 0]    ← 值變了,卻不報錯

// 3. 多加一格
arr.push(1);      // 長度變成 4
bytes.push;       // undefined     ← 根本沒有 push

// 4. 直接寫到很後面的位置
arr[6] = 1;       // ['hi', 300, 0, 1, <2 empty items>, 1] ← 自動變長,中間留下空位
bytes[6] = 1;     // 什麼事都沒發生,長度還是 3
整理成一張表:
| 做同一件事 | 一般 Array | Uint8Array |
|---|---|---|
| 放字串、物件 | 可以,什麼都能放 | 不行,只收 0–255 的整數 |
| 放 300 | 原樣放入 | 被截成 44,不報錯 |
| 加長、縮短 | push()、length = n 都行 |
不行,長度建立時就固定 |
| 寫到範圍外 | 自動變長,中間留下空位 | 直接忽略 |
這些差異不用硬背。第二節說 TypedArray 是一副眼鏡;更精確地說,每副眼鏡上都刻著一套數值規則:每格幾個 bits、有沒有負數、是整數還是小數。Uint8Array 的規則是「每格 8 bits、沒有負數、只有整數」。
要注意,規則不只管「顯示」,也管「寫入」:寫進去時,值會先照規則轉成 bytes 存起來;讀出來時,再照同一套規則把 bytes 轉回數字。所以 bytes[1] = 300 之後,buffer 裡存的就是 44,不是「300 被顯示成 44」。
上面四個差異,都是這套規則的結果:
'hi' 轉不成數字,整數規則就存成 0。換一套規則,同樣的寫入就會得到不同的結果:
| 寫入的值 | Uint8Array |
Int8Array |
Uint8ClampedArray |
Float32Array |
|---|---|---|---|---|
300 |
44 | 44 | 255 | 300 |
-1 |
255 | -1 | 0 | -1 |
1.5 |
1 | 1 | 2 | 1.5 |
'hi' |
0 | 0 | 0 | NaN |
一般 Array 沒有規則,放什麼就存什麼;TypedArray 則是先講好規則,再照規則存取。
至於 300 為什麼變成 44,回到第一節的二進位就看得出來:300 需要 9 個 bit,一格只有 8 個 bit,最高的那一位被切掉,剩下的就是 44。
300 → 1 0010 1100   (9 bits)
         ↓ 只留下低 8 bits
 44 →   0010 1100   (32 + 8 + 4)
Day 23、Day 24 都在問同一件事:copy 之後,新舊資料會不會互相影響?
到了 bytes 層,答案只要看一個地方:兩個 view 背後,是不是同一份 buffer。
每個 TypedArray 背後都有一份 buffer。分三種 copy 之前,先釐清最容易搞混的一點:同樣寫 new Uint8Array(...),括號裡丟進去的東西不同,拿到的 buffer 就不同。
| 丟進去的東西 | 白話 | 背後的 buffer | 之後修改,會影響原本的嗎? |
|---|---|---|---|
ArrayBuffer |
把眼鏡戴到這份 bytes 上 | 就是你給的那一份 | 會,兩邊是同一份 |
一般陣列,例如 [10, 20, 30] |
照著這些數字,抄進一份新的 bytes | 新配置的 | 不會 |
另一個 TypedArray,例如 bytes |
照著它看到的數字,重抄一份 | 新配置的 | 不會 |
數字,例如 3 |
準備 3 格、全是 0 的新 bytes | 新配置的 | 沒有原本的資料 |
實際改改看:
const buffer = new ArrayBuffer(3);
const arr = [0, 0, 0];

const a = new Uint8Array(buffer); // 丟 buffer
const b = new Uint8Array(arr);    // 丟一般陣列

a[0] = 1;
b[0] = 1;

new Uint8Array(buffer)[0]; // 1 ← buffer 被改到了
arr[0];                    // 0 ← 原本的陣列沒事
用一句話記:只有
ArrayBuffer是「bytes 本身」,丟進去就是直接看它;其他東西都只是「一串數字」,TypedArray 會照著抄一份新的。
TypeArray 處理 bytes 的方式可以分成三種,各有一個代表方法:
| 代表方法 | 白話 | 原本的 bytes 會怎樣 | |
|---|---|---|---|
| 共用 | subarray() |
再戴一副眼鏡,看同一份 bytes 的其中一段 | 改一邊,另一邊也跟著變 |
| 複製 | slice() |
把 bytes 影印一份,帶走自己用 | 各改各的,互不影響 |
| 移交 | transfer |
把 bytes 整份交給別人 | 自己這邊空了 |
怎麼選,只要問自己:這份 bytes 之後我還要不要用?
subarray()
slice()
transfer
其他方法也都能歸進這三類:new Uint8Array(buffer) 屬於共用;toSorted()、with()、new Uint8Array(view) 屬於複製。
subarray() 只是多看一段,不複製const bytes = new Uint8Array([10, 20, 30, 40]);
const part = bytes.subarray(0, 2); // 只看前 2 格
part.buffer === bytes.buffer; // true:背後是同一份
part[0] = 99;
bytes; // Uint8Array(4) [99, 20, 30, 40] ← 改 part,bytes 也變了
subarray() 沒有複製任何 bytes,只是在同一份 buffer 上框出一段來看,所以又快又省記憶體。
要注意,它框住的只是一段,背後共用的卻是整份 buffer:
const middle = bytes.subarray(1, 3); // 只看 [20, 30]

middle.length;            // 2
middle.buffer.byteLength; // 4 ← 背後還是整份 buffer
所以只要 middle 還在,整份 buffer 就不會被回收;把 middle.buffer 拿去 transfer,交出去的也是整份。從大檔案切一小段要長期保存或單獨交出去時,改用下面的 slice()。
slice() 影印一份,各改各的const copy = bytes.slice(0, 2);
copy.buffer === bytes.buffer; // false:新的一份
copy[0] = 1;
bytes[0]; // 99 ← 不受影響
slice() 會準備一份新的 buffer,把 bytes 抄過去,之後兩邊各改各的。toSorted()、toReversed()、with() 也是同一類。
和一般 Array 比:Array 的 slice() 只複製外層,裡面如果放的是物件,還是同一個;TypedArray 每格都是數字,沒有東西可以共用,所以副本完全獨立。另外,它只會抄看得到的範圍:對 middle 做 slice(),新 buffer 只有 2 bytes。
transfer 把 bytes 交出去,自己這邊就空了複製很安全,但有成本。一張照片可能好幾 MB,影片甚至上百 MB;如果資料交給 Web Worker 之後自己就不再用,多複製一份只是白花時間和記憶體。
這時可以用 transfer:不複製,直接把 bytes 交出去。structuredClone() 和 postMessage() 都有這個選項,把要交出去的 buffer 放進清單就行:
const buffer = new ArrayBuffer(1024);
const bytes = new Uint8Array(buffer);
bytes[0] = 42;

const message = structuredClone({ buffer }, { transfer: [buffer] });

new Uint8Array(message.buffer)[0]; // 42:bytes 到了對方手上
buffer.byteLength;                 // 0 :原本的 buffer 空了
bytes.length;                      // 0 :眼鏡還在,但已經沒東西可看
transfer 沒有複製任何 bytes。 它做的事比較像交出一把鑰匙:記憶體還是同一塊,只是「誰能使用它」換了人。
transfer 之前:buffer          ──→ [ 42, 0, 0, ... ]

transfer 之後:buffer          ──→ (空了)
               message.buffer  ──→ [ 42, 0, 0, ... ]  ← 同一塊記憶體,沒有搬動
所以不管資料是 1 KB 還是 1 GB,transfer 幾乎都不花時間。交出去之後,原本這邊會發生兩件事:
bytes 也跟著不能用:它只是眼鏡,本身沒有資料;眼前的 bytes 被拿走,自然什麼都看不到,bytes[0] 也只會得到 undefined。為什麼交出去之後,原本的就不能用? 先想想如果不這樣設計會怎樣:
Worker   :正在壓縮第 100 個 byte……
主執行緒 :同時把第 100 個 byte 改成 0
結果     :壓出來的圖片壞掉,而且每次壞的地方都不一樣
主執行緒和 Worker 是兩條同時在跑的執行緒。如果交出去之後兩邊都還能改同一塊記憶體,就可能出現上面這種狀況,非常難除錯。
所以 transfer 定了一條簡單的規則:同一時間,只有一個人能用這份 bytes。交出去的那一刻,原本的就作廢,就像把鑰匙交出去之後,自己那把就打不開門了。
把複製和移交放在一起看:
| 複製 | 移交 | |
|---|---|---|
| 速度 | 慢,要把 bytes 抄一份 | 快,只換主人 |
| 兩邊會不會打架 | 不會,各拿一份 | 不會,原本的已經作廢 |
| 代價 | 多佔一份記憶體 | 自己不能再用 |
兩者都不會打架,只是方法不同:複製靠「各拿一份」,移交靠「只剩一個主人」。移交比較快,代價是自己不能再用。
補充:「同時在跑」不等於「非同步」。Promise、
await雖然是非同步,但主執行緒一次只做一件事,大家輪流來,不會有兩段程式碼同時改同一個 byte。只有像 Worker 這種真正同時執行的另一條執行緒,才需要擔心這個問題。
buffer?** 先拆開 structuredClone() 的兩個參數:
structuredClone(要送的資料, { transfer: [要交出鑰匙的東西] });
transfer 清單:列在這裡的東西不複製,改成交出鑰匙。清單裡只能放「手上有鑰匙」的東西,規格稱為 transferable object,例如 ArrayBuffer,還有 Day 14 的 ReadableStream。Uint8Array 這類 view 只是眼鏡,沒有鑰匙可以交,所以放進清單會直接失敗:
const photo = new Uint8Array([1, 2, 3]);

structuredClone({ photo }, { transfer: [photo] });
// DataCloneError: Found invalid value in transferList.
//                 ↑ transfer 清單裡有不能交出去的東西
DataCloneError 就是 Day 24 看過的那個錯誤:這份資料沒辦法照要求送出去。Day 24 是因為 function 複製不了;這裡則是因為 view 交不出鑰匙。
正確的寫法是:資料照樣送 photo,鑰匙交 photo.buffer:
const result = structuredClone({ photo }, { transfer: [photo.buffer] });

result.photo;  // Uint8Array(3) [1, 2, 3] ← 對方拿到一副新眼鏡,看的是交過去的 bytes
photo.length;  // 0 ← 自己這邊的眼鏡,已經沒東西可看
眼鏡本身很小,可以照常複製一副給對方;真正大的 bytes 則是交出鑰匙,不用複製。實務上交給 Worker 也是同樣寫法:worker.postMessage(photo, [photo.buffer])。
移交的不是
Uint8Array裡那串數字,而是背後擁有 bytes 的ArrayBuffer;觀看它的 view 只是跟著失效。
回到開場的大頭貼:使用者選了一張圖片,我們要先判斷格式、留一份備份,再交給 Web Worker 壓縮。三種操作剛好各用上一次:
const file = input.files[0];
const buffer = await file.arrayBuffer();
const bytes = new Uint8Array(buffer);

// 共用:只看前 4 個 bytes 判斷是不是 PNG,不需要複製整張圖
const header = bytes.subarray(0, 4);
const isPng = header[0] === 0x89 && header[1] === 0x50;

// 複製:壓縮失敗時要能退回原圖,transfer 前先留一份
const original = bytes.slice();

// 移交:把整張圖交給 worker,不再多複製一份
worker.postMessage({ buffer }, { transfer: [buffer] });

bytes.length;    // 0  ← 已交出去
header.length;   // 0  ← 同一份 buffer 的 view,也一起失效
original.length; // 圖片原本的大小 ← 自己的 buffer,不受影響
| 需求 | 選擇 | 為什麼 |
|---|---|---|
| 判斷是不是 PNG | 共用:subarray() |
只是看前 4 個 bytes,不需要複製整張圖 |
| 壓縮失敗時要能退回原圖 | 複製:slice() |
transfer 之後原本的會失效,得先留一份 |
| 把整張圖交給 Worker | 移交:transfer |
自己不再用,不必多複製一份 |
順序也很重要:備份一定要在 transfer 之前做。交出去之後,bytes 已經看不到任何東西,想複製也來不及了。
補充:transfer 只讓
buffer失效,原本的file不受影響。Blob是另一個包裹,手上還有file時,壓縮失敗大可重新await file.arrayBuffer()讀一次,不必先複製、多佔一份記憶體。這裡示範的是沒有來源可以重讀的情況,例如 bytes 是從fetch()的 stream 一段段組出來的。
「大檔案用 transfer 比較快」來實際測測看會滿有趣的:
function measure(mb) {
  const buffer = new ArrayBuffer(mb * 1024 * 1024); // 配置 mb MB 的假檔案,內容全是 0

  let start = performance.now();
  structuredClone(buffer);                         // 複製:每個 byte 都要抄一次
  const copyTime = performance.now() - start;

  start = performance.now();
  structuredClone(buffer, { transfer: [buffer] }); // 移交:不搬資料,只換主人
  const transferTime = performance.now() - start;

  console.log(`${mb} MB|複製 ${copyTime.toFixed(1)} ms|移交 ${transferTime.toFixed(2)} ms`);
}

measure(10);
measure(100);
measure(500);
mb * 1024 * 1024 是把 MB 換算成 bytes(1 MB = 1024 × 1024 bytes),因為 new ArrayBuffer() 的參數是 byte 數。複製的成本只跟大小有關、跟內容無關,所以用一塊全是 0 的 buffer 當假檔案就夠了,不用真的找一個 500 MB 的影片來測。
我在自己的電腦上量到的結果大約是這樣(數字會隨機器不同,重點看趨勢):
| 大小 | 複製 | 移交 |
|---|---|---|
| 10 MB | 約 2 ms | 不到 0.1 ms |
| 100 MB | 約 48 ms | 不到 1 ms |
| 500 MB | 約 196 ms | 不到 1 ms |
兩件事很明顯:
記憶體也可以觀察:打開 Chrome 的工作管理員(Shift + Esc),複製時記憶體會暫時多出一整份,移交則不會。
所以判斷的標準很簡單:幾 KB 的小資料,複製和移交差不了多少,用哪個都行;圖片、影片、PDF 這類動輒幾 MB 以上的資料,交出去之後自己又不再用,就值得用 transfer。
今天從一個問題出發:Uint8Array 長得像 Array,為什麼不是 Array?答案可以收成一張圖:
Blob / File    封好的包裹:知道大小與類型,適合搬運
    ↓ await blob.arrayBuffer()
ArrayBuffer    記憶體裡的 bytes:負責「裝」
    ↓ new Uint8Array(buffer)
TypedArray     眼鏡:負責「用什麼規則讀寫」
               (Uint8Array、Int8Array、Float32Array……)
ArrayBuffer 裡,它本身不能讀寫;Blob 則是還沒拆開的包裹。subarray()(共用),要一份自己的用 slice()(複製),交出去不再用就 transfer(移交)。要判斷是哪一種,看 .buffer 是不是同一份。總結一句話:
Uint8Array名字裡有 Array,但它不是 Array;它是觀看ArrayBuffer的眼鏡,本身不擁有資料。bytes 是共用、複製還是移交,看背後的 buffer 就知道。
這也是 Day 23–25 copy 三部曲的最後一站:Day 23 複製外層 Array,Day 24 複製整份資料,今天走到了最底層的 bytes,也探索自己平常比較少研究的一塊,以後 review 時再看到這些用法,至少不用再滿頭問號了~。
ArrayBuffer、view 關係的總覽。Blob — 封好的檔案包裹:size、type,以及 arrayBuffer()、bytes()、stream() 等讀取方法。ArrayBuffer — 原始 bytes 儲存空間、byteLength 與 detached。Uint8Array — 建立 view 的各種方式與方法。toSorted/toReversed/with 同時加到 Array 與 TypedArray。TypedArray.prototype.subarray() 與 slice() — 共用 buffer 與複製 bytes 的差別。ArrayBuffer.prototype.transfer() — ES2024 的 buffer 所有權移交。structuredClone()、postMessage() 的 transfer 選項,以及哪些資源可以移交。

 iThome鐵人賽
 看影片追技術