
Day12 到 Day15,我們把檢索階段的四個指標一個一個拆開來看,Day16 也整合回顧了一次:Context 準不準、全不全、關鍵事實齊不齊、面對雜訊穩不穩。但 Context 只是原料,真正交到使用者手上的是語言模型產生的回答。從今天開始,我們進入回答品質評估,第一個指標是 Answer Relevancy(答案相關性)。
Answer Relevancy 想回答的問題很單純,模型的回答,有沒有對準使用者問的問題。回答太拖泥帶水、混進不相關的資訊、或是只答了一半,分數都會往下掉。延續特休的例子,使用者問「特休一天需要提前幾天申請?」,假設有兩個回答。回答 A 是「特休需要提前 3 天向主管提出申請」;回答 B 是「公司的特休依年資計算天數,滿一年有 7 天,另外也有病假與事假的規定」。回答 B 讀起來沒有錯,也很有禮貌,卻完全沒有回答「提前幾天」。這種「看似有回答、其實沒切題」的情況,正是 Answer Relevancy 要抓的問題。
它不直接拿回答去跟問題比,而是反過來,請 LLM 根據回答「猜」使用者原本問了什麼,再看猜出來的問題跟原本的問題像不像。具體來說,會先請 LLM 根據模型的回答,反推出 N 個可能的問題(RAGAS 預設 N = 3),接著把原始問題與反推出來的問題,都轉成 Embedding 向量,計算每個反推問題與原始問題的 cosine similarity(餘弦相似度),最後取平均,就是 Answer Relevancy。
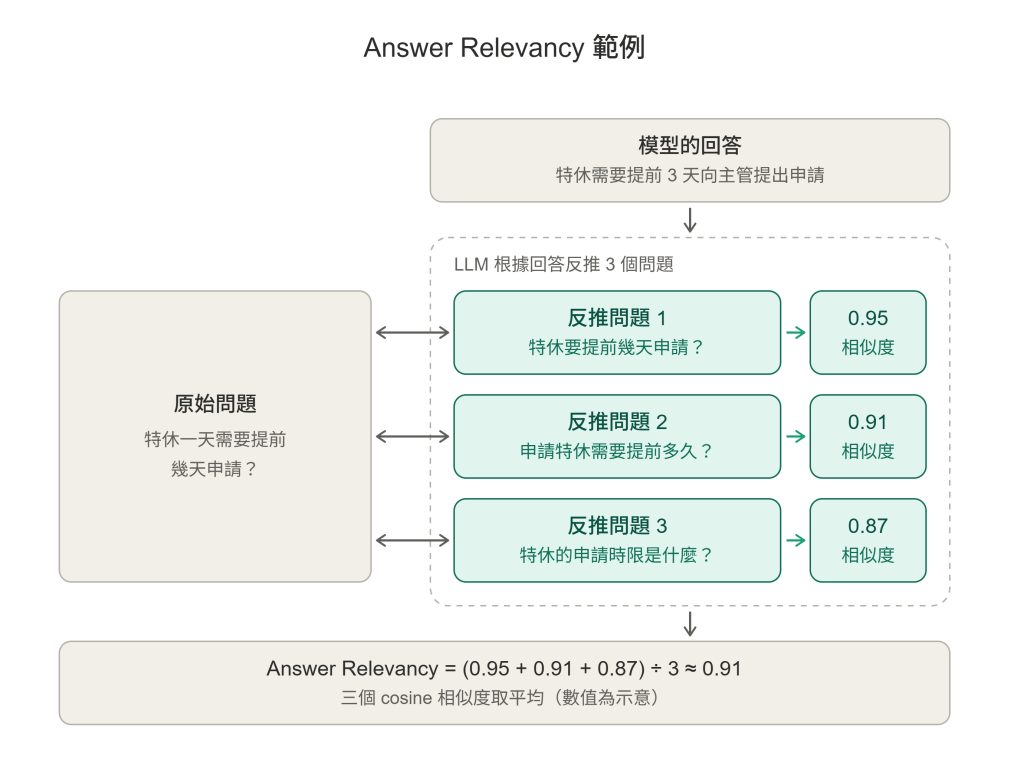
如果回答很切題,反推出來的問題就會很像原本的問題。回答 A 反推出的問題大概是「特休要提前幾天申請?」,跟原始問題幾乎一樣,相似度就高。回答 B 反推出的問題則會是「特休天數怎麼計算?」「公司有哪些假別?」,離原始問題越來越遠,平均相似度自然下降。另外,如果回答是「我不知道」「資料中沒有提到」這類迴避型的回答,RAGAS 會把它判定為 noncommittal(不置可否),分數直接歸零。
這裡有一個容易搞混的地方,Answer Relevancy 只看「切不切題」,不看「對不對」。假設模型回答「特休需要提前 10 天申請」,這句話切題,但數字是錯的,它的 Answer Relevancy 依然會很高。所以這個指標高,不代表答案可以相信,只代表模型有在回答使用者問的事情。它和 Context Precision 也不一樣:Context Precision 檢查的是「找回來的 Context」相不相關,Answer Relevancy 檢查的是「模型產生的回答」相不相關,一個看輸入給模型的資料,一個看模型輸出的結果。
當分數偏低時,可以從幾個方向檢查。可能是 Prompt 沒有限制回答範圍,模型習慣多說一堆補充資訊;可能是 Context 雜訊太多,模型被無關內容帶偏,這時可以回頭對照 Noise Sensitivity;也可能是使用者的問題本身模糊,模型只能猜測意圖,或是模型太保守,動不動就回答「找不到資料」。
Answer Relevancy 告訴我們,回答有沒有對準問題。但切題不代表有根據:模型可能很切題地回答「逾期一律不核准」,而這句話在 Context 裡根本沒有。下一篇,我們來看 Faithfulness(忠實度),檢查回答是不是真的有憑有據。


 iThome鐵人賽
 看影片追技術