
大綱裡 Day15、22、29 是「彈性格」——有題目可以寫,但隨時可以被意外取代。今天沒有意外,所以照原計畫做一個小實驗。
題目是從 Day14 長出來的。那天看到 system prompt 其實是一個函式:AGENTS.md 會被包進 <project_context> 標籤,--append-system-prompt 的內容則直接接在預設 prompt 後面。這引出一個很實際的問題:
同樣一份規則,用
AGENTS.md檔案給,跟直接灌進 system prompt,效果一樣嗎?
這不是學術問題。很多團隊會在「規則放 repo 裡」和「規則由平台統一注入」之間做選擇,前者跟著程式碼走,後者方便集中管理。
Day14 結尾我寫過:預期「成本影響很小——加料加在最前面,反而是最容易被快取的位置」。
更具體一點,我的預測是:兩種放法的行為和成功率沒有差別,成本差距落在雜訊範圍內。 理由是兩者最後在 system prompt 裡的位置幾乎相同:
// dist/core/system-prompt.js 的組裝順序(節錄)
let prompt = `You are an expert coding assistant ...`;  // 預設 prompt
if (appendSection) prompt += appendSection;              // --append-system-prompt
if (contextFiles.length > 0) prompt += "<project_context>...";  // AGENTS.md
一個緊接在預設 prompt 後面,另一個再往後一點點。差別只在後者多了一層 XML 包裝。
AGENTS.md 裡的規則(Day9)。有 AGENTS.md:跟 Day9 一樣,規則放在專案根目錄的檔案裡。規則灌進 system prompt:把檔案刪掉,把一字不差的同一份內容(1,145 字元)用 --append-system-prompt 傳進去。gpt-5.6-luna。| 任務 | 條件 | 成功 | 成本中位數 | tokens 中位數 | 跑了 check.py |
|---|---|---|---|---|---|
| T2 新增 endpoint | 有 AGENTS.md | 5/5 | $0.0076 | 77,234 | 5/5 |
| T2 新增 endpoint | 規則灌進 system prompt | 5/5 | $0.0063 | 75,789 | 5/5 |
| T3 修 CI 檢查 | 有 AGENTS.md | 5/5 | $0.0032 | 31,675 | 5/5 |
| T3 修 CI 檢查 | 規則灌進 system prompt | 5/5 | $0.0043 | 34,649 | 5/5 |
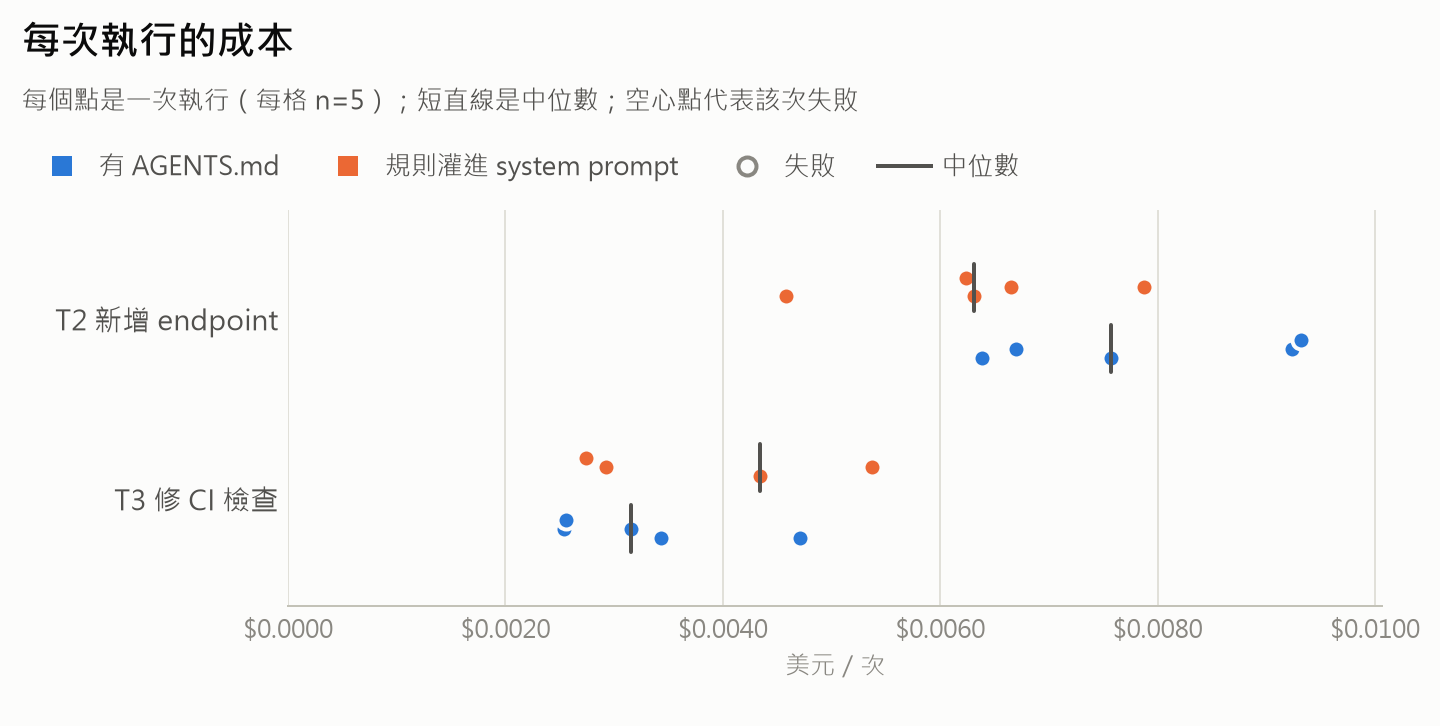
20 次全部成功,20 次全部跑了 check.py。 Day9 看到 AGENTS.md 最重要的效果是「讓 agent 一定會照規矩驗收」,這個效果換成 system prompt 一樣成立——規則有沒有送到模型眼前才是關鍵,用哪種方式送不重要。
中位數乍看有差,但注意方向:
兩個任務的方向相反。 把每一次的成本攤開更清楚:
| 任務 | 條件 | 五次的成本 |
|---|---|---|
| T2 | 有 AGENTS.md | $0.0064、$0.0067、$0.0076、$0.0092、$0.0093 |
| T2 | 規則灌進 system prompt | $0.0046、$0.0062、$0.0063、$0.0066、$0.0079 |
| T3 | 有 AGENTS.md | $0.0025、$0.0026、$0.0032、$0.0034、$0.0047 |
| T3 | 規則灌進 system prompt | $0.0027、$0.0029、$0.0043、$0.0044、$0.0054 |
每一格的範圍都跟對面那格重疊。如果放法真的影響成本,兩個任務的方向應該一致;方向相反,最合理的解釋就是隨機變異。這跟 Day9 T2 在校準和正式實驗之間方向翻轉,是同一個教訓。
有一個數字完全不受雜訊影響——第一次模型呼叫的輸入 token:
| 任務 | 有 AGENTS.md | 規則灌進 system prompt | 差距 |
|---|---|---|---|
| T2 | 1,508 | 1,454 | 54 |
| T3 | 1,473 | 1,419 | 54 |
每一次執行都是這兩個數字,一個不差。同樣的內容放在 AGENTS.md,每次請求多 54 個 token。
這 54 個 token 就是 Day8 看到的那層包裝:
<project_context>

Project-specific instructions and guidelines:

<project_instructions path="D:\...\work\AGENTS.md">
(AGENTS.md 內容)
</project_instructions>

</project_context>
標籤、那句說明、還有檔案路徑。54 個 token 很少——這兩個任務一次執行大約 8~13 輪模型呼叫,加總也才四、五百個 token,而且大多會命中快取——但它是真實存在、可以精確量出來的成本。
既然效果一樣、成本差距微不足道,選擇的依據就應該是維護,不是效能:
放 AGENTS.md 的好處
灌進 system prompt 的好處
我自己的結論是:**專案慣例放 AGENTS.md,平台政策用 system prompt 注入。**這跟兩者的效能無關,純粹是看規則「屬於誰」。
這次實驗有一次執行只跑了 6 輪就停了,成本 0.0004 美元,判定失敗。打開記錄一看,錯誤訊息是:
Codex error: Our servers are currently overloaded. Please try again later.
服務商過載,agent 根本沒機會做完。Day7 設計了「基礎設施失敗不算 agent 失敗」的規則,但這次暴露了一個漏洞:原本的規則只抓「一次工具都沒呼叫就出錯」的情況,這次 agent 在出錯前已經呼叫了 3 次工具,所以沒被抓到。
修法是加一條規則:**執行從頭到尾沒有正常結束、而且中間出現過服務商錯誤,就算基礎設施失敗。**用新規則回頭掃過所有實驗,只有這一次符合,重跑之後成功。量測台也是程式,也會有 bug;重點是讓它在每一次踩到的時候變得更準。
AGENTS.md 真正的優勢之一是分層,這個實驗只放了一份,所以那個優勢沒有機會出現。Day16 拆 thinking level:Pi 的七個思考檔位怎麼對應到不同模型,以及關掉思考為什麼不等於「不要想」。


 iThome鐵人賽
 看影片追技術