
第二幕結束時,專案中的畫面已經長得稍微像樣了。但如果今天出了一張新專輯,我想把它加進網站,要做的事情是:打開 data.ts,照格式多寫一筆資料,commit、push,然後重新部署。
而且目前的實作,是先把整份 data.ts 交給瀏覽器,再由瀏覽器做搜尋和篩選。25 張沒什麼,但如果變成 2500 張,每個人都得先拿到一大堆根本沒看到的資料。
到目前為止,我們做的都是海面上看得到的東西。從今天開始,要潛到海面之下:讓資料離開程式碼,住進真正的資料庫。
先想清楚,資料一直寫在 data.ts 裡,到底會出什麼問題:
| 問題 | 例子 |
|---|---|
| 改資料就要改程式 | 新增一張專輯,要 commit、push、重新部署 |
| 資料全部送到瀏覽器 | 現在 25 張還好,2500 張呢?每個人都要先下載全部 |
| 使用者產生的資料沒地方放 | 收藏現在只能存在瀏覽器;之後使用者回報的資料錯誤,要存去哪? |
| 沒辦法控制誰看得到什麼 | Day 6 說過:送到使用者手上的東西,沒有秘密 |
前兩個是「麻煩」,後兩個是「做不到」。收藏要跟著帳號走、回報要讓管理員看得到——這些都需要一個不在任何人瀏覽器裡、大家都連得到的地方。
那個地方,就是資料庫。
我在另一個專案裡換過三次資料庫:NoSQL 格式自由、上手快,但資料之間的關係一多就開始吃力;SQLite 整個資料庫就是一個檔案,本機很方便,但放進 Vercel 這類沒有持久磁碟的環境,寫進去的內容不能當成永久資料——我需要一個獨立於網站程式之外的資料庫;最後選了 PostgreSQL,關聯式,而且是一個獨立存在、有網址可以連過去的資料庫。
回頭看之前畫的關係圖:藝人有很多專輯,專輯有很多版本,版本有很多內容物。這張圖本身,就是選關聯式資料庫的理由。
選定資料庫類型之後,還要決定「誰來幫你管」。常見的幾個平台:
| 平台 | 資料庫類型 | 除了資料庫還提供什麼 | 適合 |
|---|---|---|---|
| Supabase | PostgreSQL(關聯式) | 登入、檔案儲存、權限規則 | 需要關聯式資料,又想要登入一起處理 |
| Neon | PostgreSQL(關聯式) | 主要就是資料庫 | 只需要資料庫,登入另外處理 |
| PlanetScale | MySQL(關聯式) | 主要就是資料庫 | 已經熟悉 MySQL 的團隊 |
| Firebase | Firestore(文件式) | 登入、檔案儲存、推播 | 資料關係簡單、偏即時同步的 App |
| MongoDB Atlas | MongoDB(文件式) | 主要就是資料庫 | 資料格式變化大、關係少 |
MySQL 跟 PostgreSQL 一樣是關聯式資料庫,都用資料表和 SQL,差別在細節功能和生態系。
另外,AWS、Google Cloud 這類大型雲端平台也有自己的資料庫服務(例如 AWS 的 RDS),能選的資料庫種類多、控制權更大,但要自己設定的東西也比較多。平台有非常多種可以選擇,這邊舉的只是冰山一角。
我認為這個專案可以採用關聯式資料庫,而且後面又要用到登入和權限規則,所以我選 Supabase。
那 Prisma 呢? 它能讓你用 TypeScript 的寫法操作資料庫,還會自動產生型別,我在另一個專案用過,很好用。(它是一種ORM,有興趣可以上網查一下)但這次後面要接 Supabase 的登入和權限規則,今天先不做這個,把這條線走完再說。
Day 9 我們替資料定了型別。現在要把這些型別,變成資料庫裡的資料表。
先這樣理解會比較直覺:
| TypeScript 裡的概念 | 資料庫裡常見的做法 |
|---|---|
一種主要的東西,例如 Album |
通常會有一張對應的資料表 |
一個簡單的屬性,例如 title |
通常會有一個對應的欄位 |
| 很多筆資料 | 很多列 |
| 巢狀的關係,例如專輯裡的版本 | 常拆成另一張表,用外鍵連起來 |
程式裡的型別和資料庫的表,不一定是一對一的。型別描述的是「程式希望拿到什麼形狀」;schema 描述的是「資料怎麼存比較合理」。
真正需要想一下的,是巢狀的資料。在之前設計的型別裡,版本是放在專輯裡面的一個陣列:
type Album = { id: string; title: string; versions: AlbumVersion[]; // 版本放在專輯裡面};
PostgreSQL 其實可以把一整包 JSON 塞進某個欄位。但版本不是一段單純的附加文字:它自己還有名稱、格式、內容物、成員款,而且之後可能需要獨立搜尋或修改。所以這裡更適合把它拆成另一張表,每一列記著「我屬於哪一張專輯」:
albums(專輯)
┌─────────────────────┬──────────────┐
│ id                  │ title        │
├─────────────────────┼──────────────┤
│ aespa-armageddon    │ Armageddon   │
└─────────────────────┴──────────────┘
          ↑
          │ 屬於誰
          │
album_versions(版本)
┌──────────────┬─────────────────────┬──────────────┐
│ id           │ album_id            │ name         │
├──────────────┼─────────────────────┼──────────────┤
│ superbeing   │ aespa-armageddon    │ Superbeing   │
│ zine         │ aespa-armageddon    │ Zine         │
└──────────────┴─────────────────────┴──────────────┘
這裡出現兩個常聽到的名詞:
id
album_id,指向它所屬的那張專輯還記得 Day 9 說的嗎:替每個欄位問一句「它屬於誰」。 那個問題的答案,到了資料庫裡,就變成了外鍵。
跟之前一樣,先把結構談清楚,再讓 AI 寫程式。 以下是我給 Codex 的 prompt:
請根據
data.ts裡的型別,設計對應的 PostgreSQL 資料表,準備放在 Supabase 上。
- 列出每一張資料表、欄位、型別、主鍵和外鍵
- 說明每張表之間的關係
- 不需要
tags欄位先不要建立任何東西,等我確認。
我確認過後的資料表關係大致上是這樣:
artist_memberships(成員關係)
 member_id   group_id
   │           │
   └─────┬─────┘
         ▼  兩個欄位都指向藝人
artists(藝人)
   │ 一個藝人,有很多張專輯
   ▼
albums(專輯)
   │ 一張專輯,有很多個版本
   ▼
album_versions(版本)
   │ 一個版本,有很多項內容物;也可能有很多種成員款
   ├───────────────────────────┐
   ▼                           ▼
version_inclusions(內容物)  version_designs(成員款)
多出來的 artist_memberships 是一張「關係表」:每一列記一組「誰是哪個團的成員」,例如 member_id 是 Jimin、group_id 是 BTS,兩個欄位都指回 artists。有了它,搜尋成員的名字,也找得到團體的專輯。(這是中間我告訴 AI 我希望有這個功能之後他做的修改。此外,資料表的設計方法並不唯一,要考量的點很多。)
資料表的樣子確定了,接下來要真的把表建出來、把資料搬進去。
資料表可以在 Supabase 後台用滑鼠點出來,但這樣做,專案裡通常只看得到「現在長什麼樣」,看不到「怎麼一步步變成這樣」:換一台電腦、開一個測試環境,就很難照樣重現。
比較好的做法,是把「建表」、「加欄位」這些動作 寫成一個一個的檔案 ,按順序執行。這些檔案就叫 migration,可以把它想成資料表結構的版本紀錄:Git 是記錄程式碼怎麼改變,migration 記錄 schema (資料庫結構)怎麼改變。已經套用到雲端的,就不要回頭改,而是再新增下一份。
要注意的是,migration 管的是結構,不是內容。之後新增、修改專輯資料,走後台或管理介面,不是再寫一份 migration。
把表和資料送進 Supabase,常見的有三種方式:
| 方式 | 怎麼做 | 適合 |
|---|---|---|
| SQL Editor | 在 Supabase 後台貼上 SQL,按執行 | 資料不多,想親眼看每一步 |
| Supabase CLI(我用的) | migration 和初始資料都放在專案裡,用指令推上雲端 | 想留下紀錄,之後能在別的環境重建 |
| 寫程式匯入 | 寫一支程式,透過 API 一筆一筆寫入 | 資料要先從別的地方轉換;需要另一把高權限的金鑰(第五節會提到),只能在自己電腦上跑 |
沒有哪一種一定比較好。我選 CLI,因為這樣 migration 會留在專案裡、跟著 Git 一起被記錄。
這次我自己只做了兩件事:在 Supabase 建立專案,以及在終端機登入 Supabase CLI ,其他的都基本上交給 AI 處理:
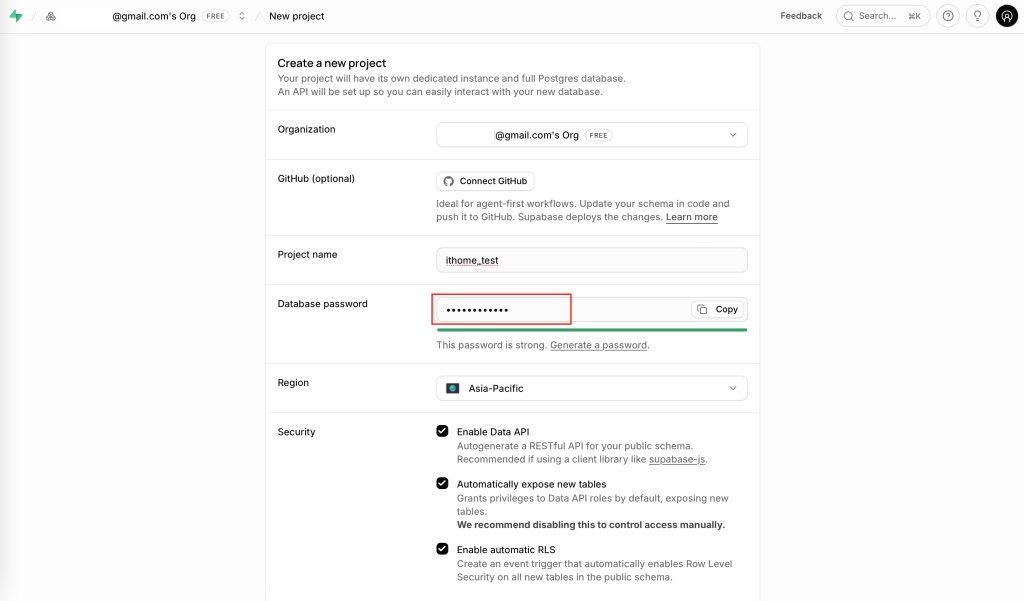
【圖1|建立 Supabase 專案】 (要設定資料庫密碼,後面會用到)
以下是我在登入、連結專案所用的幾個終端機指令(須先安裝 supabase CLI,不知道怎麼安裝也可以請 AI 幫你安裝):
supabase login:登入 Supabase (會開瀏覽器,去得驗證碼,複製回終端機)supabase init:初始化專案supabase link --project-ref <你的-project-ref>:連接專案(會需要輸入當初創建專案所設的密碼)。
另外,<你的-project-ref> 就是你在專案首頁,網址的最後那串東西。
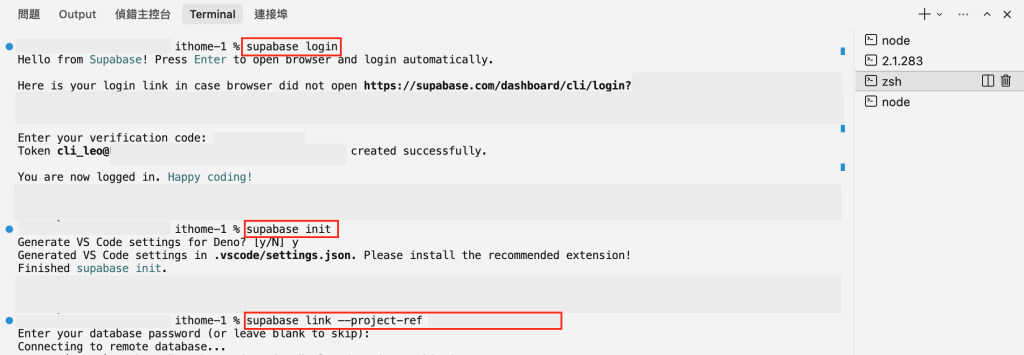
【圖2|透過 Supabase CLI 連接資料庫】
不過要記得,CLI 連上之後,能做的事很多——改結構、刪資料表,甚至清空整個雲端資料庫都可以。Git 的紀錄還有機會救回來,資料庫的資料刪了就沒了。所以我會這樣分工:
| 誰 | 做什麼 |
|---|---|
| AI 可以做 | 寫 migration 和 seed、預演 |
| 要先讓我看過 SQL | 真正推上雲端的資料庫 |
| 一律要我同意 | 刪除資料表、清空或重設資料庫(例如 supabase db reset --linked) |
這一步我其實沒特別寫什麼長的 prompt。因為在我確認 schema 之後,AI 有詢問我是否可以往下做,每做完一步就停下來問我要不要繼續;像 supabase db push 這種會動到雲端資料庫的指令,工具也會先跳出來,要我按同意才會執行。
如果你的工具不會停下來問,就把這幾條寫進 prompt:
- 推上雲端之前先預演,讓我看過 SQL
- 資料表要開啟 RLS,只允許讀取
- 不要為了讓匯入成功而關閉權限保護
- 不要執行任何刪除、清空或重設資料庫的指令
- 完成後回報每張表的筆數
data.ts 產生匯入用的 SQL,而不是手寫幾百行。這種「放入第一批資料」的動作叫做 seed,像播種一樣;它只用在新環境的第一次,之後不會每次重跑。supabase db push --dry-run 看會執行哪些 migration,確認過再 supabase db push 建表,最後 supabase db push --include-seed 把資料一起推上去。supabase inspect db table-stats --linked 看每張表的筆數,跟原本的資料對一下。搬完之後,AI 告知每張表的筆數:(擔心出錯的話可以從後台確認,但理論上機率很低)
| artists | albums | album_versions | version_designs | version_inclusions | artist_memberships |
|---|---|---|---|---|---|
| 124 | 25 | 72 | 131 | 242 | 105 |
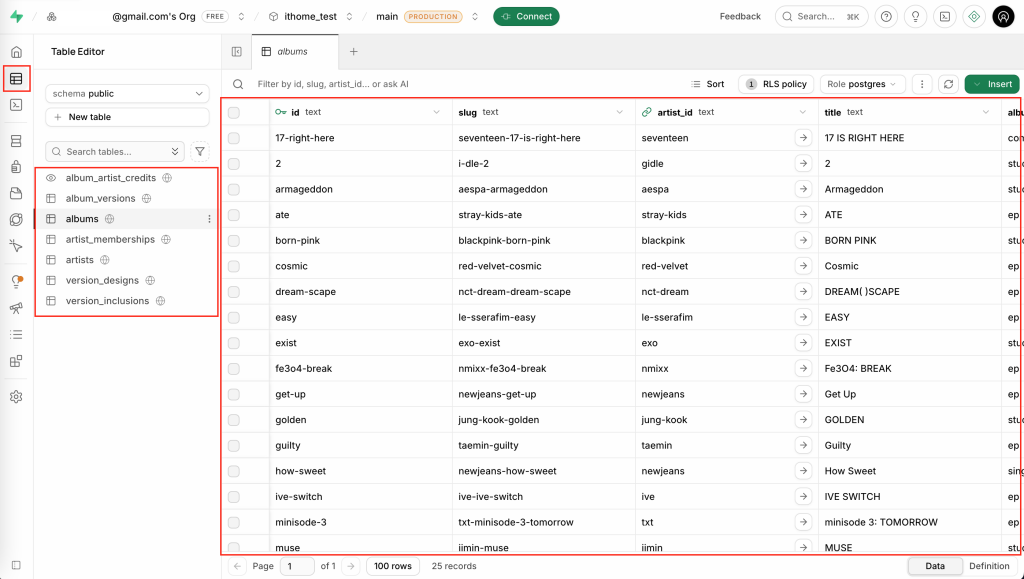
【圖3|匯入成果】(進入 supabase 網頁版後台,從左側可以選 Table Editor,可查看目前有的資料)
資料庫建好了,接下來要讓網站可以讀得到,現在是第一次需要金鑰的時候。
Supabase 有兩類金鑰:
| 金鑰 | 能做什麼 | 可以放在前端嗎? |
|---|---|---|
| Publishable key(公開金鑰) | 能做的事,由剛剛設的權限規則決定 | 可以,它本來就設計成放在前端 |
| Secret key(管理者金鑰) | 權限很高,通常不受權限規則限制 | 絕對不行,只能放在可信任的伺服器環境 |
如果看到比較舊的教學,這兩把金鑰可能叫做
anon和service_role。以你後台實際看到的名稱為準。
這篇目前只需要公開金鑰。 管理者金鑰是給「寫程式匯入」或之後的管理功能用的,今天我沒有用,就先不放。
這裡有一個 Next.js 特有、很容易出事的細節:
環境變數的名稱,如果以
NEXT_PUBLIC_開頭,就會被送到瀏覽器。
公開金鑰可以用 NEXT_PUBLIC_ 開頭,管理者金鑰絕對不行 ——加了,就等於把「可以讀寫所有資料」的權限公開給全世界。AI 有時候為了「讓程式能動」,會把所有金鑰都加上 NEXT_PUBLIC_,這一條等一下會寫進 prompt。(怕的話也可以提前跟 AI 說)
之前提過,可以用 .gitignore 決定哪些檔案不要進 commit。今天就來實際用一次。
金鑰放在專案裡的 .env.local 檔案,而不是直接寫在程式碼裡:
NEXT_PUBLIC_SUPABASE_URL=專案網址
NEXT_PUBLIC_SUPABASE_PUBLISHABLE_KEY=公開金鑰
進入 supabase 專案後,在頂部有一個綠色「connect」按鈕,點進去之後,選擇 next.js,可以看得到這兩個參數
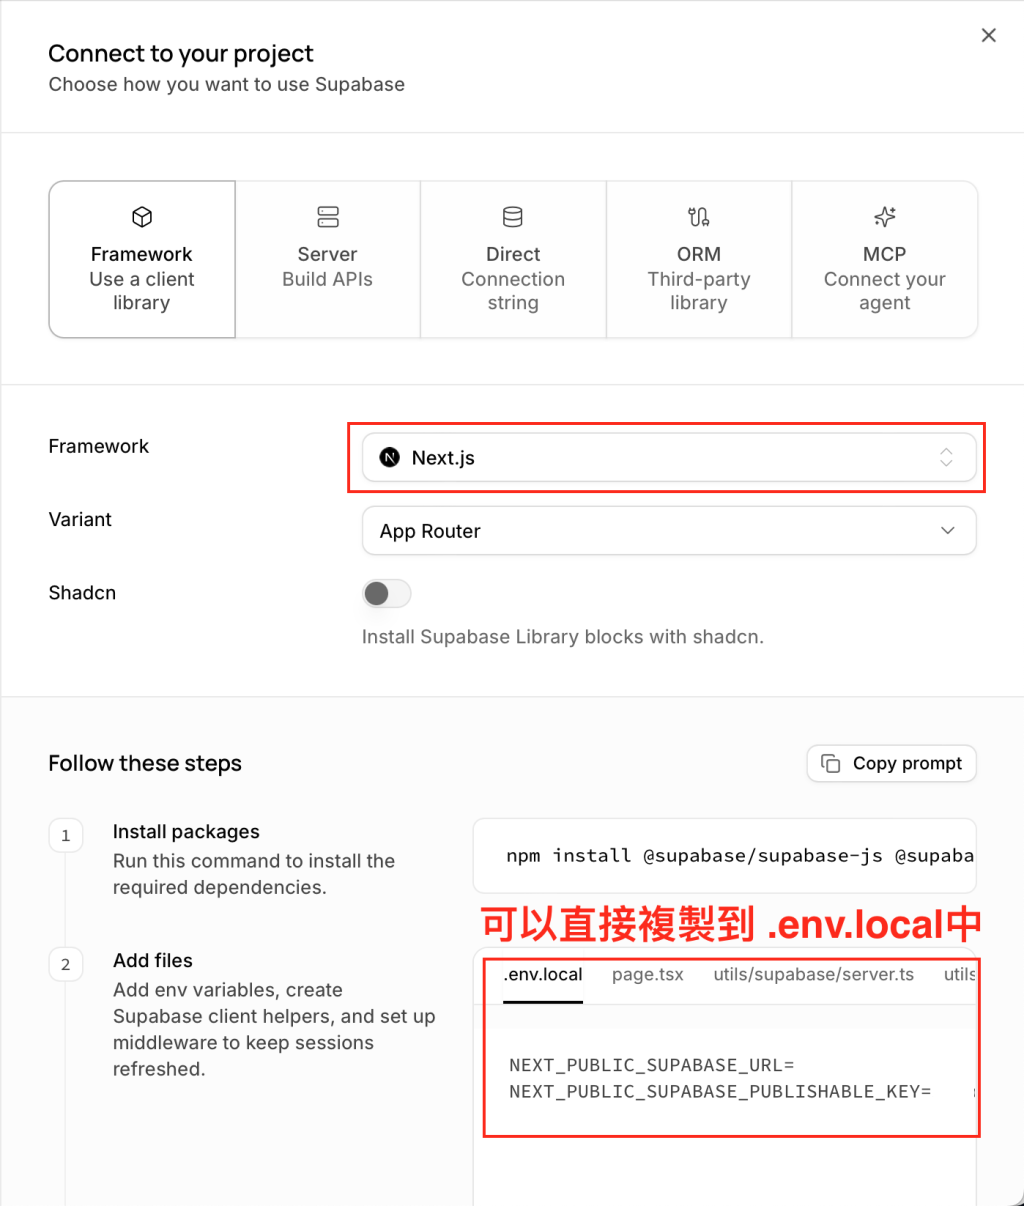
【圖4|參數位置】 (也可以直接點 Copy Prompt 交給 AI,讓 AI 處理。 但通常在讓 AI 處理之前,我會先確認他具體改什麼、為什麼改這個、是否會有動到其他東西。)
存好之後,可以跑一次 git status,理論上 .env.local 不應該出現在清單裡。如果不小心 commit 甚至 push 了,光是把檔案刪掉並不夠——它已經留在 Git 的紀錄裡了,要去 Supabase 重新產生 一組新的金鑰,讓舊的失效。
.gitignore 擋得住 Git,擋不住 AI這裡有一件很容易誤會的事:
.gitignore只代表 Git 不會 commit,不代表 AI 工具看不到。
Codex、Claude Code 這類 AI 工具,本來就能讀取專案裡的檔案。你沒有把金鑰貼進對話框,不代表它讀不到 .env.local。所以我會額外注意:
.env.local,只告訴它「變數名稱是什麼」,或是需要的時候請他用變數名稱跟我溝通,而不是請他直接編輯環境變數檔案。.env.local 排除
之前有說「送到別人手上的東西,沒有秘密」,這次的「別人」,也包括 AI。
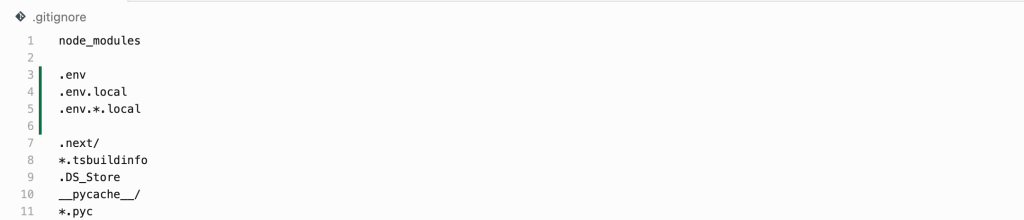
【圖5|.gitignore 內容】
變數設定好了,最後一步是讓頁面改成去資料庫拿資料。
這一步同樣很短:我填好 .env.local、跟 AI 說一聲,它就先用公開金鑰測試讀取,再把首頁、列表、詳情頁的資料來源,一頁一頁換成 Supabase,最後自動跑了型別檢查和 build 測試。收藏頁裡用來顯示專輯資訊的資料,也改成從 Supabase 來;但目前「收藏了哪些」本身還是存在瀏覽器,等之後有了登入會搬。
改完之後,data.ts 並沒有消失:它還留著型別和標籤,也是之後重新產生 seed 的來源。只是專輯資料本身,已經不從這裡來了。
最後,來做今天最有感的測試:不改任何程式,直接改資料庫裡的資料。
npm run dev)title 暫時改掉選 title 是因為它只是一般的文字欄位:網址和其他資料表用的是 id,改名字不會影響到別的東西。id 不要動。
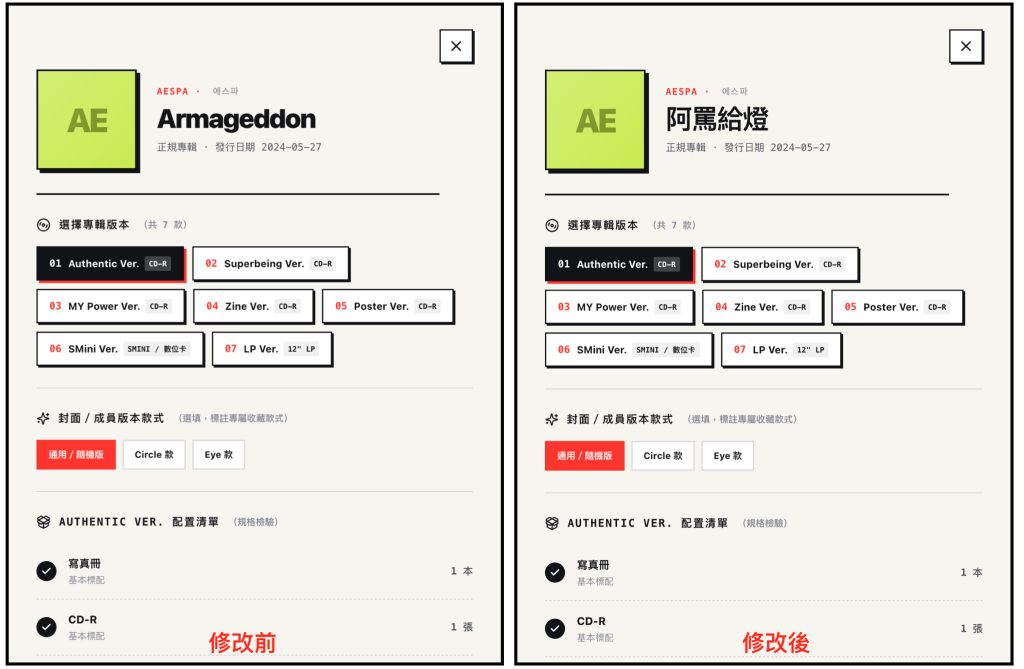
【圖6|更改某一張專輯名稱,重整頁面】 (沒有重啟開發伺服器)
名字變了——改一筆資料,終於不再是改一行程式碼了。 測完記得改回來。
部署之後再做一次同樣的測試,詳情頁不一定會馬上跟著變,這跟部署的設定有關。這個問題,等到部署那天再回來看。
最後順手確認兩件事:
git status 裡看不到 .env.local
NEXT_PUBLIC_,只有網址和公開金鑰Day 9 我們替別的產品也畫過資料模型。搬進資料庫,可能會長成這樣(取決於功能的需求而有變化):
記帳
accounts(帳戶)
   │ 一個帳戶,有很多筆交易
   ▼
transactions(交易)── category_id ──→ categories(分類)
點餐
menu_items(餐點)
   │ 一個餐點,有很多種規格
   ▼
item_options(規格:大小、甜度、冰塊)
不管是什麼產品,拆表的方式都一樣:替每個欄位問「它屬於誰」,屬於別人的,就用外鍵指過去。這部分,我通常會先詢問 AI,詢問他的建議,在詢問過程中也會詳細的描述我需要的功能可能有哪些,因為不同的功能,對於資料庫的設計可能會有不同。
今天做的事,說穿了就是一件:讓資料離開程式碼。 在那之前,資料是網站的一部分,改資料等於改程式。現在,資料住在海面之下,網站只是在需要的時候去把它撈上來。
不過,你可能注意到一件事。今天從頭到尾,我們好像一支 API 都沒寫,網站就拿到資料了。但其實,程式碼裡的 Supabase 套件,背後做的事情就是帶著網址和公開金鑰,向 Supabase 發出請求、拿回結果。
我們早就在用 API 了。
那 API 到底是什麼?常聽到的 CRUD、RESTful 又是什麼意思?明天,我們先不寫程式,用 Postman 親手打幾次 API,把這些概念弄清楚。
我們明天見。


 iThome鐵人賽
 看影片追技術