
到目前為止,整個系統現在沒有任何告警或儀表板,Canary 壞了要靠人自己想到去切 Kill Switch。今天開始的 Stage 3,要處理的就是這件事。我們不再使用 "指令" 來了解關鍵資訊,而是把它們用 Dashboard 來呈現,讓大家一看就明白出了什麼事。
要做到告警、做到儀表板,前提是要能看到 Stable/Canary 各自的健康數據——延遲多少、錯誤率多少、資源用了多少。這些數據要從哪裡生出來?答案其實 Day06 就已經準備好了:那天裝上的 OTel Java Agent,本來就會在背景自動產生這些 Trace/Metrics 資料。
我們可以把 Otel Java Agent 自動產生的資控資料分兩種:
Trace(追蹤):一次 request 完整的處理過程,由一串有先後關係的 Span 組成。OTel 官方定義「一個 Span 代表一個工作單元或一次操作」,每個 Span 都帶著開始/結束時間(因此能算出耗時)、狀態(成功或錯誤)、以及一組描述性的 attribute。Day07 我們已經看過 trace_id/span_id 出現在 Pod 的 log 裡,那就是 Trace 資料的一部分。
Metrics(指標):OTel 官方定義是「在執行期對一個服務做的測量」,重點是「統計聚合」,不是追蹤單一 request,而是回答「整體而言」的問題。OTel Java Agent 會自動產生 JVM 執行期指標(記憶體用量 jvm.memory.used、GC 耗時 jvm.gc.duration、執行緒數 jvm.thread.count……),以及 HTTP Server 的 請求延遲 http.server.request.duration(這是一個 histogram,可以算出 P50/P95/P99)。這些名稱送到 Prometheus 之後會變成底線寫法,例如 jvm.memory.used 會變成 jvm_memory_used_bytes。Day16 驗證 OTel Collector 有沒有真的收到資料時,查的就是這個指標。
在 Stage 3,我們會根據上述這些資料來觀察 demo-app 的建康狀況。
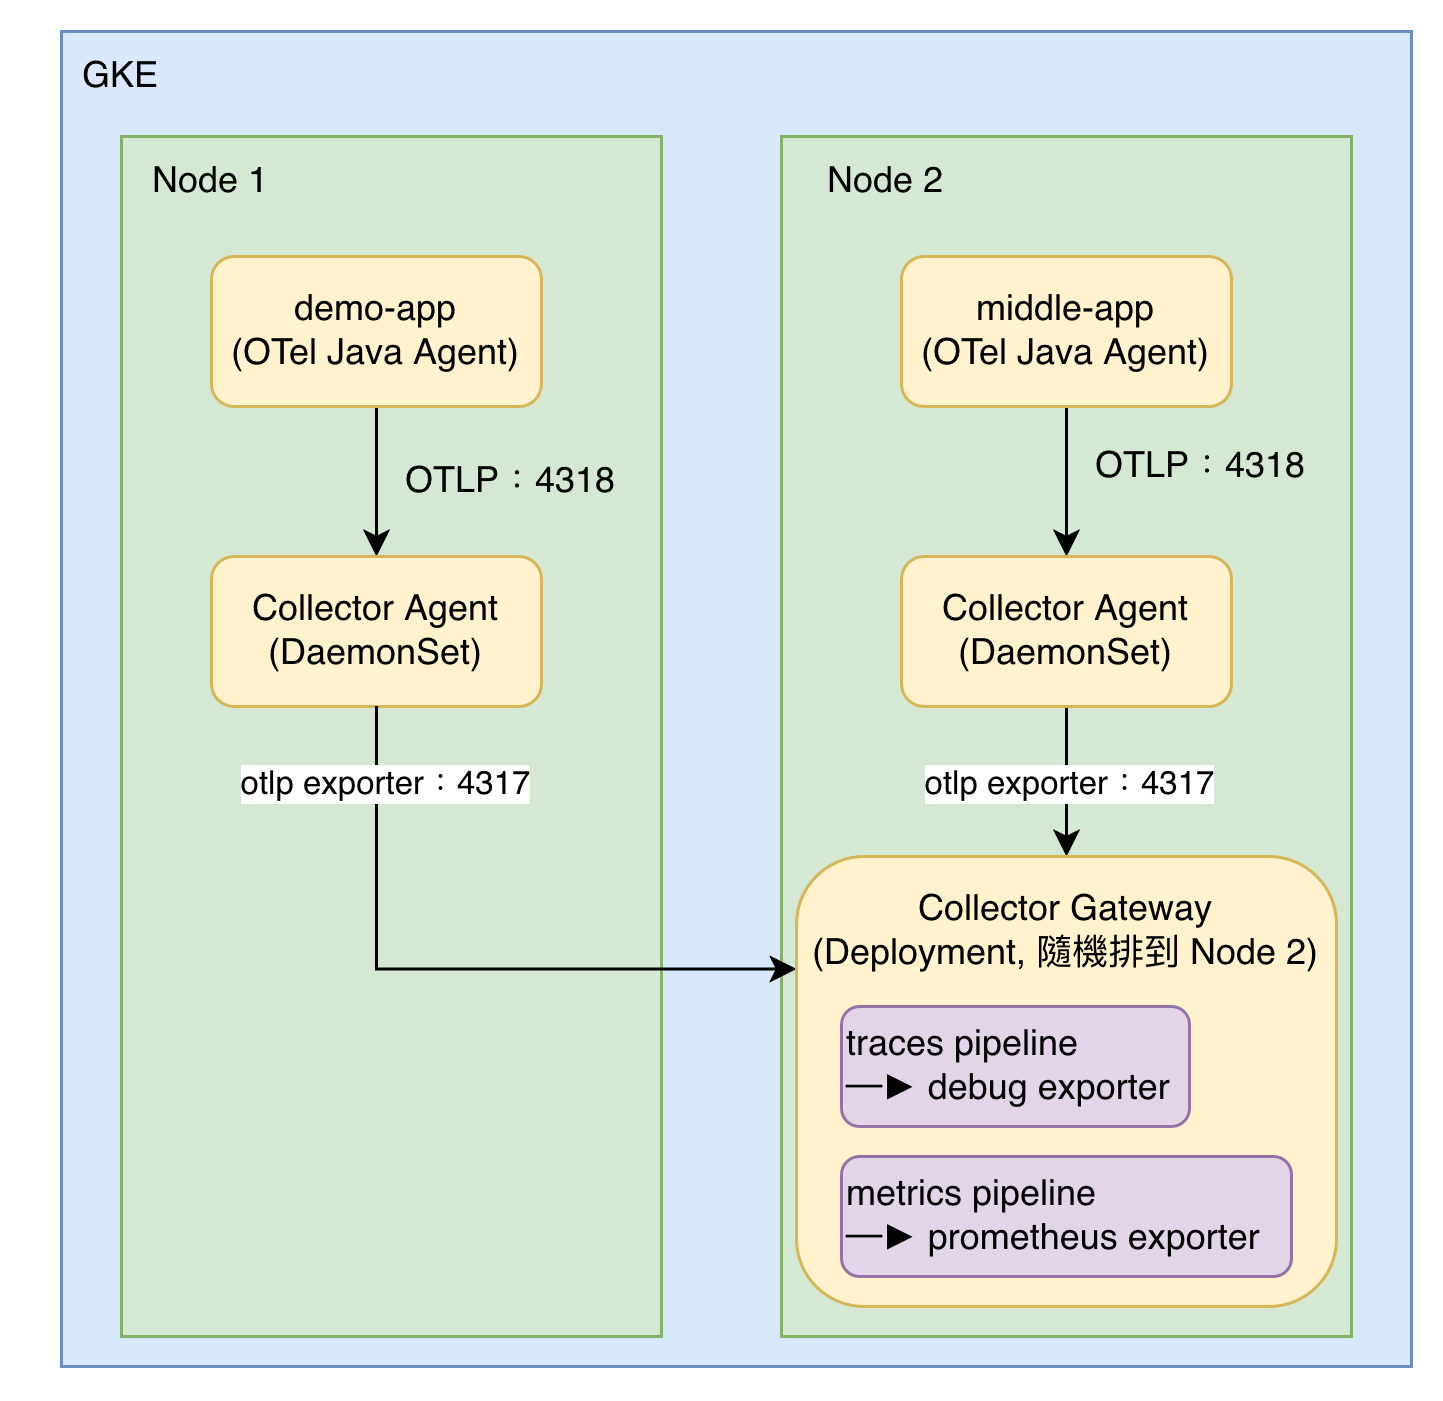
OTel Collector 官方文件把這個中繼角色拆成兩種部署模式:OTel Collector Agent(跑在每台機器/容器上的常駐程式)和 OTel Collector Gateway(集中收資料的中央服務)。這個專案兩種都用,讓資料先進 OTel Collector Agent、再匯到 OTel Collector Gateway:
每台機器/容器上的 App 只要知道「同節點的 OTel Collector Agent 在哪裡」就好,然後把監控數據送過去,讓 OTel Collector Agent 去決定要把數據傳到哪些監控工具。(好多 Agent 啊 😅)
真實設定放在 config repo、observability ArgoCD Application 的 source.path 目前指到的 otel-agent.yaml 與 otel-gateway.yaml。
# otel-agent.yaml(DaemonSet 片段)
spec:
  containers:
    - name: otel-agent
      ports:
        - name: otlp-grpc
          containerPort: 4317
          hostPort: 4317
        - name: otlp-http
          containerPort: 4318
          hostPort: 4318
我們先跳到 demo-app 的 2 個 deployment.yaml:demo-app-v1.yaml 和 demo-app-v2-canary.yaml。在這裡加入 2 個環境變量的設定,OTel Java Agent 需要它們,才能把監控需要用的數據傳送到 Collector Agent:
# demo-app-v1.yaml(同 demo-app-v2-canary.yaml,Deployment 環境變數片段)
- name: HOST_IP
  valueFrom:
    fieldRef:
      fieldPath: status.hostIP
- name: OTEL_EXPORTER_OTLP_ENDPOINT
  value: "http://$(HOST_IP):4318"
OTel Java Agent 預設用 HTTP 協定把資料送給 Collector Agent,對應的埠是 4318;也可以改設定成走 gRPC,這時對應的埠就要換成 4317。
Day13 引入的 middle-app-b.yaml/middle-app-c.yaml 也是同一顆 OTel Java Agent、同一套環境變數,這裡不重複貼設定——所以從今天開始,demo-app 跟 middle-app 產生的監控數據,會一起送進同一組 Collector Agent/Gateway。
Collector Agent 有一個自己的資料處理 pipeline(好多 pipeline 啊 @@)。收到資料後,會先透過 k8sattributes 這個 processor,自動幫每筆 Trace/Metrics 打上是哪個 Pod、哪個 Namespace、哪個 Node 送出來的。Processor 是 OTel Collector pipeline 裡,資料從 receiver 收進來、送到 exporter 之前,負責轉換/過濾/豐富化的中間步驟。
# otel-agent.yaml(DaemonSet ConfigMap 片段)
processors:
  k8sattributes:
    auth_type: "serviceAccount"
    passthrough: false
    filter:
      node_from_env_var: KUBE_NODE_NAME
    extract:
      metadata:
        - k8s.node.name
        - k8s.namespace.name
        - k8s.pod.name
        - k8s.pod.uid
        - k8s.deployment.name
    pod_association:
      - sources:
          - from: resource_attribute
            name: k8s.pod.ip
      - sources:
          - from: connection
extract.metadata 列出實際要打上去的欄位
接著,透過 Exporter 把資料轉發給 Collector Gateway:
exporters:
  otlp:
    endpoint: "otel-collector.<namespace>.svc.cluster.local:4317"
    tls:
      insecure: true
Exporter 是 pipeline 的最後一棒,負責把 processor 處理完的資料送到後端。這裡的「後端」是同一叢集裡的 Collector Gateway。這裡用的是 otlp exporter,透過 gRPC 把資料送到 Collector Gateway。endpoint 指向 Collector Gateway 的 Kubernetes Service DNS name,加上 4317,tls.insecure: true 代表叢集內部傳輸先不加密。
otel-collector.<namespace>.svc.cluster.local 這個 DNS 名稱背後,對應的就是 otel-gateway.yaml 裡定義的這個 Service:
# otel-gateway.yaml(Service 片段)
apiVersion: v1
kind: Service
metadata:
  name: otel-collector
  namespace: <namespace>
  labels:
    app.kubernetes.io/name: otel-gateway
spec:
  selector:
    app: otel-gateway
  ports:
    - name: otlp-grpc
      port: 4317
    - name: otlp-http
      port: 4318
    - name: prometheus
      port: 8889
metadata.labels 裡的 app.kubernetes.io/name: otel-gateway,Day16 佈署 Prometheus 時,會說明 Prometheus 如何透過這個 label 知道要收集誰提供的監控數據。ports 裡底下有 3 個具名的 port。prometheus(8889),是為了給 Prometheus 來獲取資料而設定的。# otel-gateway.yaml(ConfigMap 摘錄)
processors:
memory_limiter:
check_interval: 1s
limit_mib: 1000
spike_limit_mib: 200
transform:
error_mode: ignore
metric_statements:
- context: resource
statements:
- keep_keys(attributes, ["service.name", "service.version", "deployment.environment"])
batch:
send_batch_size: 10000
timeout: 10s
三個 processor 依序執行:memory_limiter 跟 batch 是官方建議的標準組合,順序固定(memory_limiter 一定放最前面、batch 放最後面);中間插入的 transform 用來過濾放行指定的 resource attributes。
memory_limiter:防止 collector 發生記憶體不足——監控目前的記憶體用量,一旦超過門檻就拒收新資料、強制觸發 GC;放在 pipeline 最前面,是為了讓「拒收」這件事能把 backpressure 往回傳給上游的 receiver,減少資料在觸發限制時被憑空丟掉的機率。transform:下面會用到的 resource_to_telemetry_conversion 開關,會把 resource attribute 整包轉成 Prometheus label——如果不先篩選,Collector Agent 端 k8sattributes processor 打上的 k8s.pod.name/k8s.pod.uid 這類每個 Pod 都不同的欄位也會一起被轉換。尤其 k8s.pod.uid 每次 Pod 重啟都換一個新值,等於每次重啟都在 Prometheus 裡憑空多出一組新的時間序列,是真正的 cardinality(時間序列基數)洩漏源頭。這裡用 keep_keys() 提前只保留區分 Stable/Canary 身分實際需要的三個欄位,其餘全部丟棄,把轉換範圍鎖死在可控範圍內。batch:放在最後,把多筆資料包成一批再送出,用意是更有效率地壓縮資料、減少傳輸資料所需的連線數量。send_batch_size/timeout 兩個條件只要滿足一個,這批就會被送出去。Collector Gateway 這邊的 container 記憶體 limits 特意設成 1280Mi,高於 memory_limiter 的 1000 MiB 上限——留出緩衝,確保是 memory_limiter 先介入擋資料,而不是 K8s OOM Killer 先把整個 Pod 殺掉。
Trace 資料今天先送去 debug exporter,也就是把 pipeline 最後處理完的數據 印到 Pod 自己的 stdout,因為專門收集 Trace 資料的工具 Tempo 要到 Day18 才會部署,今天只驗證「資料真的送到 OTel Collector Gateway」這件事:
exporters:
  debug:
    verbosity: normal
Metrics 資料則送去 prometheus exporter:
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
    resource_to_telemetry_conversion:
      enabled: true
prometheus exporter,做的事情是把資料 轉成 Prometheus 認得的格式,暴露在 otel-collector 這個 Service 的 8889 port 上,等別人主動來抓。是 Pull,不是 Push。resource_to_telemetry_conversion 這個開關的用途已在前面提到,會把 resource attribute 整包轉成 Prometheus label。
我們一樣把佈署的工作交給 ArgoCD。這次的 ArgoCD Application 是 observability-app.yaml:
# observability-app.yaml
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: observability
  namespace: argocd
spec:
  project: <namespace>
  source:
    repoURL: '<config repo 的 git clone URL,已省略帳號與 repo 名稱>'
    path: <config repo 裡對應目前進度的快照路徑>
    targetRevision: main
  destination:
    server: 'https://kubernetes.default.svc'
    namespace: <namespace>
  syncPolicy:
    automated:
      prune: true
      selfHeal: true
    syncOptions:
      - CreateNamespace=true
destination.namespace 設成 <namespace>,OTel Collector Agent/Gateway 跟 demo-app、APISIX 部署在同一個 namespace。syncPolicy.automated 開啟 prune/selfHeal:git 裡刪掉的資源,ArgoCD 會自動清掉;叢集裡有人手動改動跟 git 宣告的狀態不一致,也會被自動蓋回去。syncOptions 的 CreateNamespace=true,讓 ArgoCD 在套用資源前,先確保 <namespace> 這個 namespace 存在。/metrics 端點,但還沒有真正的 Prometheus 來抓。我們會在 Day16 佈署 Prometheus 並且驗證整條管道。


 iThome鐵人賽
 看影片追技術