
Hello, 各位 iT 邦幫忙 的粉絲們大家好~~~
這系列文源自這幾年在團隊裡導入 AI Coding 之後,一路踩雷、修正、再踩雷的真實過程。把這些收斂出來的方法整理成文,也許對正在煩惱同樣問題的你會有些幫助。
就當作是一份邊做邊記的工程筆記吧!
本篇是 當 AI 加入團隊:打造可審查、可驗證、會自我改善的 AI 開發工作流 系列文的 EP17。
有一類知識文件,我們刻意用不同的方式來寫。
不是「這個問題的標準答案是什麼」,而是「看到這個症狀,第一步該檢查什麼」。
這類文件示範了另一種累積知識的方式——從真實案例裡抽出症狀、證據、可能原因、下一步檢查,而不是只記一個「最後怎麼修好的」。
# triage: 某告警持續觸發

## 症狀
- 裝置在某段時間內反覆觸發同一則告警

## 先檢查的證據
1. 該時段的服務狀態日誌
2. 對應告警前後是否有韌體或設定變更紀錄

## 常見成因(依機率排序)
1. 設定值在更新後未同步(最常見)
2. 裝置端暫時性連線抖動(次常見)
3. 感測元件本身異常(少見,需要進一步硬體檢查)

## 下一步
- 若成因 1、2 都排除,才進入更深的日誌分析或程式碼調查
分診表把「老手看一眼症狀就知道大概方向」這種直覺,轉譯成一份可以被複製的判斷路徑。
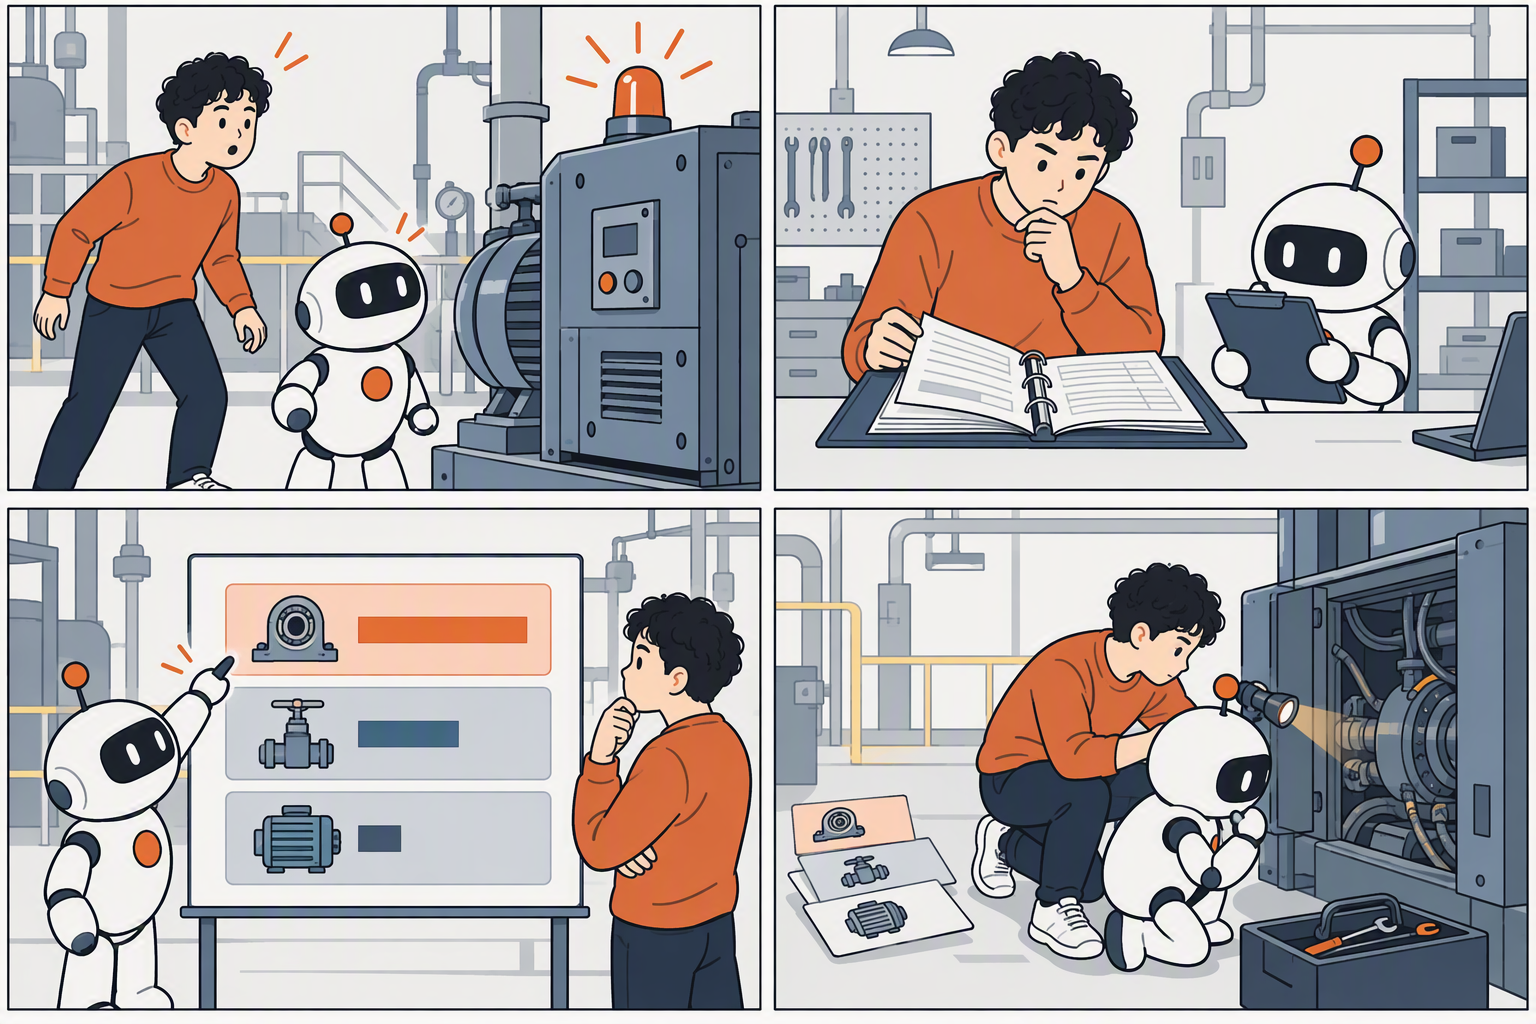
這種寫法的好處是:當新的事件跟舊案例的症狀相似時,AI 可以先走最小的確認路徑,而不是每次都從零開始猜。
而如果症狀對不上任何已知案例,它也很清楚知道自己該往哪個方向深挖,而不是漫無目的地翻日誌。
它不追求百分之百準確,但求先幫忙排除掉最常見的那 80%,把真正困難的案例留給人去深入調查。
這加起來其實就一句話:分診表不追求百分之百準確,但求先排除最常見的那 80%。
累積了這麼多能力跟知識,接下來該回頭盤點:這一切自動化,到底靠什麼原則才不會愈做愈亂?
下一篇來談可重複與可驗證。


 iThome鐵人賽
 看影片追技術