

三位專員做完、契約也定了,今天主管正式上場。
不過我不打算一次把三位都接上去。這篇只做最小的形式:一位主管、一位專員,而且只接 W1。目標是回答一個問題——主管拿到工具之後,會不會老實派工。
結果是它會派工,但同時做了兩件我沒料到的事。
接三位專員的話,一封信可能派兩次工,出問題時我得先判斷是派錯人、還是專員答錯、還是主管整理錯。只接一位,可能性少很多:要嘛該派沒派,要嘛派了但傳錯參數,要嘛專員回報之後主管亂整理。
這條路線也呼應 Day 11 的決定。W1 是獨立的 workflow,有自己的入口,主管只是「另一個呼叫它的人」。接上去不需要改 W1 一行程式。
整體結構如下圖,主管底下多了一個工具,工具後面接的是 Day 11 那個獨立的 workflow。
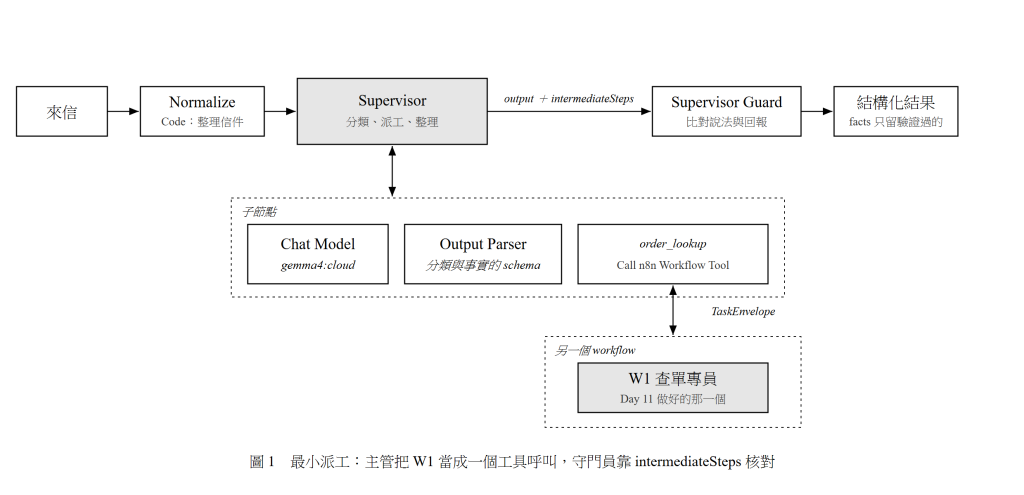
n8n 裡讓 Agent 呼叫另一個 workflow 的節點是 Call n8n Workflow Tool。設定 Source 選 Database,Workflow 選 W1,下面會跳出 W1 的 Execute Workflow Trigger 定義的輸入欄位——這就是 Day 11 把輸入欄位先列出來的回報,這裡直接變成一張表單。
每個欄位填一個運算式,值交給模型決定:
task_id         {{ $fromAI('task_id', '工單編號,格式 t_ 加任意英數字', 'string') }}
question        {{ $fromAI('question', '要這位專員查什麼,用一句中文描述', 'string') }}
order_id        {{ $fromAI('order_id', '客戶在信件中明確提到的訂單編號…', 'string') }}
customer_email  {{ $fromAI('customer_email', '客戶的 email 地址', 'string') }}
need_csv        {{ $fromAI('need_csv', '需要回報的欄位,逗號分隔,例如 status,eta', 'string') }}
attempt         {{ $fromAI('attempt', '第幾次嘗試,第一次填 1', 'number') }}
工具描述寫法跟 Day 11 給 W1 的工具一樣,三段式:
派工給查單專員。專員會從訂單系統查出訂單狀態、物流、到貨時間、金額或會員資料,並回報有來源的事實。
使用時機:客戶詢問訂單、物流、到貨、退貨時需要訂單資料。
不要用在商品知識或政策問題。
最後一句現在沒有作用,因為還沒有第二位專員可以選。等 Day 18 把 W2 接上去,這一句才開始決定派給誰。
你是「好豆選物」客服部門的主管。你不直接處理客戶問題,
你的工作是判斷客戶來信的需求,並派工給合適的專員。

## 你的團隊
- order_lookup(查單專員):能從訂單系統查詢訂單狀態、物流、到貨時間、金額

## 你的工作流程
1. 閱讀客戶來信,判斷客戶想知道什麼。
2. 如果需要查詢訂單資料,呼叫 order_lookup 工具派工。
3. 收到專員回報後,整理成結構化的結果輸出。

## 派工規則
- 派工時,question 要寫清楚「要查什麼」,不要寫「怎麼查」。
- order_id 只填客戶明確提到的編號。客戶沒提到就填空字串。
- need 填你需要專員回報的欄位。

## 重要限制
- 你自己沒有查詢訂單的能力。不要假裝你知道訂單狀態。
- 你不寫給客戶看的回信。你的輸出是給系統用的結構化資料。
- 每封信最多派工 2 次。
「你自己沒有查詢訂單的能力」這句是必要的。模型對訂單編號、物流、到貨日這些概念很熟,不講清楚的話,它會直接用常識編一套說法。
AI Agent 節點的 Options 裡有一個 Return Intermediate Steps,預設是關的。打開之後,輸出會多一個 intermediateSteps 陣列,記錄每一次工具呼叫的輸入和回傳值。
這個設定是後面所有檢查的基礎。沒有它,我只看得到主管最後「說」它查到什麼;有了它,我才能把主管的說法跟專員實際回報的內容對起來。
守門員的核心就是這個比對:
const steps = Array.isArray(item.intermediateSteps) ? item.intermediateSteps : [];
const calls = steps.map(s => ({ tool: s.action?.tool, input: s.action?.toolInput, result: parseObservation(s.observation) }));
const reported = calls.flatMap(c => c.result?.facts ?? []);
const reportedKeys = new Set(reported.map(f => `${f.key}::${f.source}`));

for (const f of claimed) {
  if (!SOURCE_RE.test(f.source)) { rejected.push({ f, why: 'bad_source_format' }); continue; }
  if (!reportedKeys.has(`${f.key}::${f.source}`) && !reportedValues.has(`${f.source}::${String(f.value)}`)) {
    rejected.push({ f, why: 'not_reported_by_worker' });
    continue;
  }
  kept.push(f);
}
Day 11 的守門員檢查的是「這筆事實有沒有來源」,這裡的守門員檢查的是「這個來源是不是真的講過這句話」。
從 50 封評估信裡挑了 15 封,都是查單類的題目,包含有編號的、沒編號的、查無訂單的、一信兩問的,還有一封客訴。
意圖分類 14 封正確。派工 14 次,唯一沒派工的是問咖啡豆保存方式那封,主管判成 product_qa 然後直接標記需要人工——這題本來就該派給 W2,但 W2 還沒接上去,所以這個行為是對的。
主管宣稱收集到 41 筆事實,守門員擋下 2 筆,最後收下 39 筆。
EV13 這封信問「A10294 出貨了嗎?另外淺焙的豆子可以做冰滴嗎?」
主管派工給 W1,W1 回報兩筆事實:狀態是備貨中、預計到貨 2026-09-17。然後主管在輸出裡寫了三筆:
[
  { "key": "訂單 A10294 狀態", "value": "備貨中 (packing)", "source": "orders!A10294" },
  { "key": "訂單 A10294 出貨日期", "value": "尚未出貨", "source": "orders!A10294" }
]
第二筆是它自己加的。W1 從頭到尾沒有回報過「出貨日期」這個欄位。
麻煩的地方在於,這個推論其實是對的:備貨中就是還沒出貨。但它把一個推論寫成了事實,而且掛上一個格式完全合法的來源 orders!A10294。單看這筆資料,沒有任何線索顯示它是推論出來的。
這就是為什麼守門員要比對 intermediateSteps。只檢查格式的話,這筆會直接過關,然後 W3 會寫出「您的訂單尚未出貨」,而這句話沒有任何一位專員負責。
推論本身不是壞事,Day 09 的契約裡本來就有 derived 欄位放推論。問題是它被放錯地方了。
EV35 是那封客訴信:「第三次了!!包裝又是破的……我要求全額退款……訂單 A10295。」
主管收集的事實裡有一筆:
{ "key": "訂單編號", "value": "A10295", "source": "客戶來信" }
訂單編號確實是客人自己寫的,這筆資料也沒錯。但 source 填「客戶來信」不符合格式規範,守門員直接擋掉。
這條擋得有點嚴,不過我決定維持。客人說的話是「主張」不是「事實」,兩者混在一起,後面就沒辦法區分「系統查到的」和「客人聲稱的」。客人聲稱的東西該放在 clean_question 裡,而它本來就在那裡了。
EV35 的標準答案是 complaint,主管判成 return_refund,這是 15 封裡唯一的分類錯誤。
不過 needs_human 它標了 true。依照 Day 09 定的規則,return_refund 本來就一定要人審,所以就算分類錯了,這封信還是會走到人工那一關,不會被自動回覆。
這正是 Day 09 說的「能用架構擋下來的,就不要只靠 prompt」。分類是機率問題,一定會錯;路由規則是程式,不會錯。把「要不要轉人工」綁在路由規則上而不是綁在分類的準確度上,錯誤才不會直接變成事故。
標準答案說不需要人工的 14 封信裡,主管把其中 6 封標成 needs_human: true。
看它的理由,大多是「資訊不完整」「需要進一步確認」。例如 EV07,客人沒給訂單編號、信箱也查不到訂單,主管標了需要人工——但這種情況標準的處理方式是回信請客人補編號,不需要勞動真人。
過度轉人工不像幻覺那樣危險,但它會讓整套系統失去意義:如果六成的信最後都丟給人,那自動化就沒有發生。這是 v1 prompt 最明顯的問題,明天專門修它。
同樣這 15 封信,跟第一週的單兵 Agent 比:
| tokens 中位數 | 時間中位數 | |
|---|---|---|
| 單兵 Agent | 2046 | 2.2 秒 |
| 主管加 W1 | 6008 | 5.3 秒 |
token 變成 2.9 倍,時間 2.4 倍。拆開來看,主管花 2887、專員花 3087,大致對半。
這個倍數要有心理準備:多一層 Agent,等於多一次完整的 prompt 加對話往返。Day 28 會用完整的 50 封信算總帳,看這筆錢換到多少正確率。
我原本以為工具參數的描述寫得清不清楚,會影響主管會不會編造訂單編號。所以做了兩個版本:一個描述只寫「訂單編號」,另一個寫「客戶在信件中明確提到的訂單編號,格式為 A 加 5 位數字。若客戶沒有提到訂單編號,必須填入空字串,不可以推測或編造」。
拿 5 封沒有訂單編號的信各跑一次,結果兩個版本都一樣:order_id 全部填空字串,沒有任何一次編造。
Day 04 試單兵 Agent 的工具描述長短時,結論也是沒有差別。兩次都沒看到差異,我的結論是:在這個模型和這種規模下,工具描述的細節影響沒有想像中大。真正擋得住錯誤的還是架構層的檢查——像上面那兩筆被守門員丟掉的事實,不管描述怎麼寫都會發生。
當然這不代表描述可以亂寫。描述是寫給讀程式的人看的,也是換模型之後唯一能先調的東西。只是不要指望它能解決正確性問題。
最小派工用 Call n8n Workflow Tool 把 W1 掛上去,參數用 $fromAI 交給模型填。AI Agent 的 Return Intermediate Steps 一定要打開,守門員才有辦法比對主管的說法和專員的回報。15 封信實測,意圖 14/15,守門員擋下 2 筆:一筆是主管把自己的推論寫成事實還附上合法來源,一筆是把「客戶來信」當成資料來源。分類唯一的錯誤被路由規則接住了,但主管太愛轉人工,14 封不需要人工的信有 6 封被標上去。
明天就修這件事,重寫主管的 System Prompt。


 iThome鐵人賽
 看影片追技術