
摘要
過去十幾天,我一直在擴張單一 Agent 的能力:讓它讀專案、使用工具、保存規則、執行任務,再用 Git 管理修改。但工作一旦同時牽涉事實查核、內容判斷與搜尋策略,繼續把所有責任塞進同一條 Context,注意力也會開始互相競爭。這篇用兩輪文章 Review 測試 Subagent。第一輪讓三個 Reviewer 接受相同任務,觀察獨立 Context 如何產生互補結果;第二輪再把它們拆成 Fact、Writing 與 SEO/GEO 三種角色,看責任邊界如何改變判斷。沿著兩次實驗往下,我把 Subagent 收斂成三種工作拆法,最後再把反覆出現的角色保存成 Custom Agent。到了這一步,「一人 AI 團隊」才第一次從功能集合變成一套工作組織。
我原本只想讓三個 AI Reviewer 多抓幾個錯誤,結果它們卻把同一篇文章看成了三種不同問題。當工作同時牽涉事實查核、內容判斷與 SEO,繼續把所有要求塞進同一個 Prompt,只會讓 Context 越來越長;把責任拆開之後,我第一次看見「一人 AI 團隊」真正開始運作的樣子。
如果你已經會讓 Agent 查資料、改文章、使用工具,這篇會把下一步直接做給你看:我用兩輪 Review 實測 Codex Subagent,從三個獨立 Reviewer、Fact/Writing/SEO 專職分工,一路走到可重複使用的 Custom Agent,最後整理出三種可以直接套用的 Multi-Agent 拆工方法。
寫完 Day17 之後,我照慣例把文章交給 AI Review。這件事已經成為寫作流程的一部分:檢查論證是否跳躍、技術描述有沒有缺口、段落是否拖慢節奏,再找出作者讀久之後逐漸失去敏感度的問題。過去我的解法通常是繼續往 提示詞裡加條件,要求同一個 AI 代理同時理解內容、查核事實、檢查文字,必要時再照顧搜尋意圖。工作越複雜,提示詞越長,同一條上下文承擔的角色也越多。
這次我反過來做。我沒有增加要求,只把同一篇文章同時交給三個 Reviewer。如果它們使用相近能力、閱讀同一份 Day17,也接到完全相同的任務,直覺上應該只會產生三份相似的修改清單,差別頂多落在措辭與排序。於是我讓 Main Agent 建立三個彼此獨立的 Subagent,三者都只負責一件事:找出正式發布前最值得修正的問題;工作期間不得交換結果,等所有人完成後才回到 Main Agent 整合。
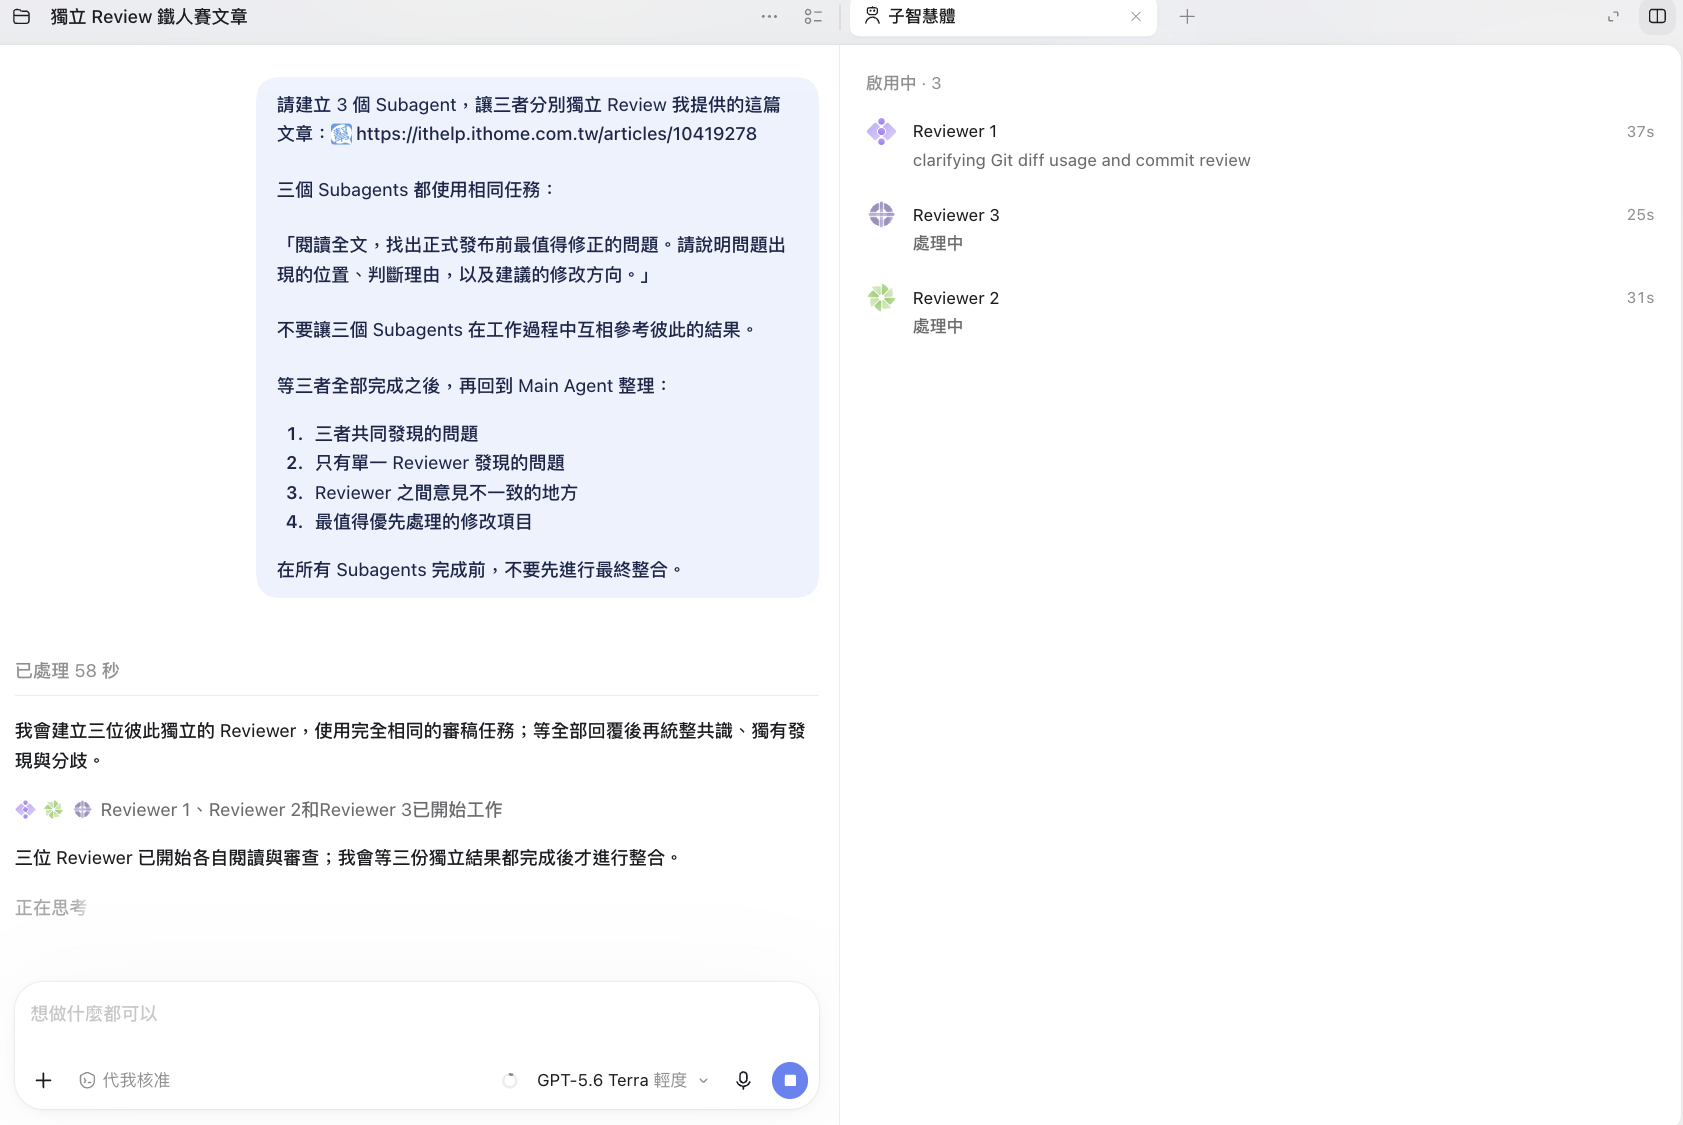
畫面中,三個獨立 Reviewer 同時執行
實作 Prompt|三個獨立 Reviewer
建立 3 個彼此獨立的 Subagents,讓三者以相同標準 Review 這篇文章。工作期間不得互相參考結果。全部完成後,再整理共同發現、只有單一 Reviewer 找到的問題,以及修改優先順序。
結果沒有收斂成三份相同答案。三個 Reviewer 都注意到 Git 教學對新手留下了一些安全邊界,例如首次 Commit 前缺少 .gitignore 與敏感檔案檢查,圖 5 的編號與文字也同時被抓出來;但離開交集之後,注意力很快分岔。Reviewer A 沿著操作流程往下追,認為大改版 Commit 前應先 Preview、看 Diff,而且切換 Branch 之後預覽環境未必立即同步;Reviewer B 更在意概念精確度,指出本機 Commit 不等於備份,Git Graph 的指令也可以寫得更完整;Reviewer C 則沿著文章承諾反推讀者風險——全文一直強調「退得回去」,真正出錯時卻沒有提供最小回復路徑。
這個結果值得看的地方,不在於三個 Agent 合計找出了多少錯誤,而是它們形成了不同的問題敏感區。相同文章、相同任務,三條彼此分離的工作脈絡留下了一部分共識,也留下互相補位的觀察。這時「多跑三次」已經不足以解釋整個現象;我真正需要理解的是,當 Main Agent 把工作交出去時,究竟有哪些東西也跟著被切開。
長時間使用 ChatGPT 時,一次工作的實際輸入從來不只眼前那句 Prompt。需求、搜尋結果、修改紀錄、工具輸出、已完成的決策與前一次失敗,都會逐步進入 Context。Agent 每往下一步,都必須重新判斷哪些資訊仍然值得保留,哪些已經只是工作過程留下的殘渣。當同一條 Context 同時容納研究、改稿、查核與大量中間輸出,資訊量增加的同時,也提高了注意力分配的難度。
Subagent 改變了這個結構。Main Agent 可以把一部分工作委派到新的 Agent Thread,讓搜尋、分析與中間推理停留在另一個 Context,最後只把收斂後的結果帶回主線。OpenAI 在 Subagent 文件中把這類問題描述為 context pollution:當探索紀錄與工具輸出持續佔據主工作脈絡,真正影響決策的訊息可能逐漸被淹沒。Subagent 因此提供的不只是更多執行單位,也是一種 Context isolation。
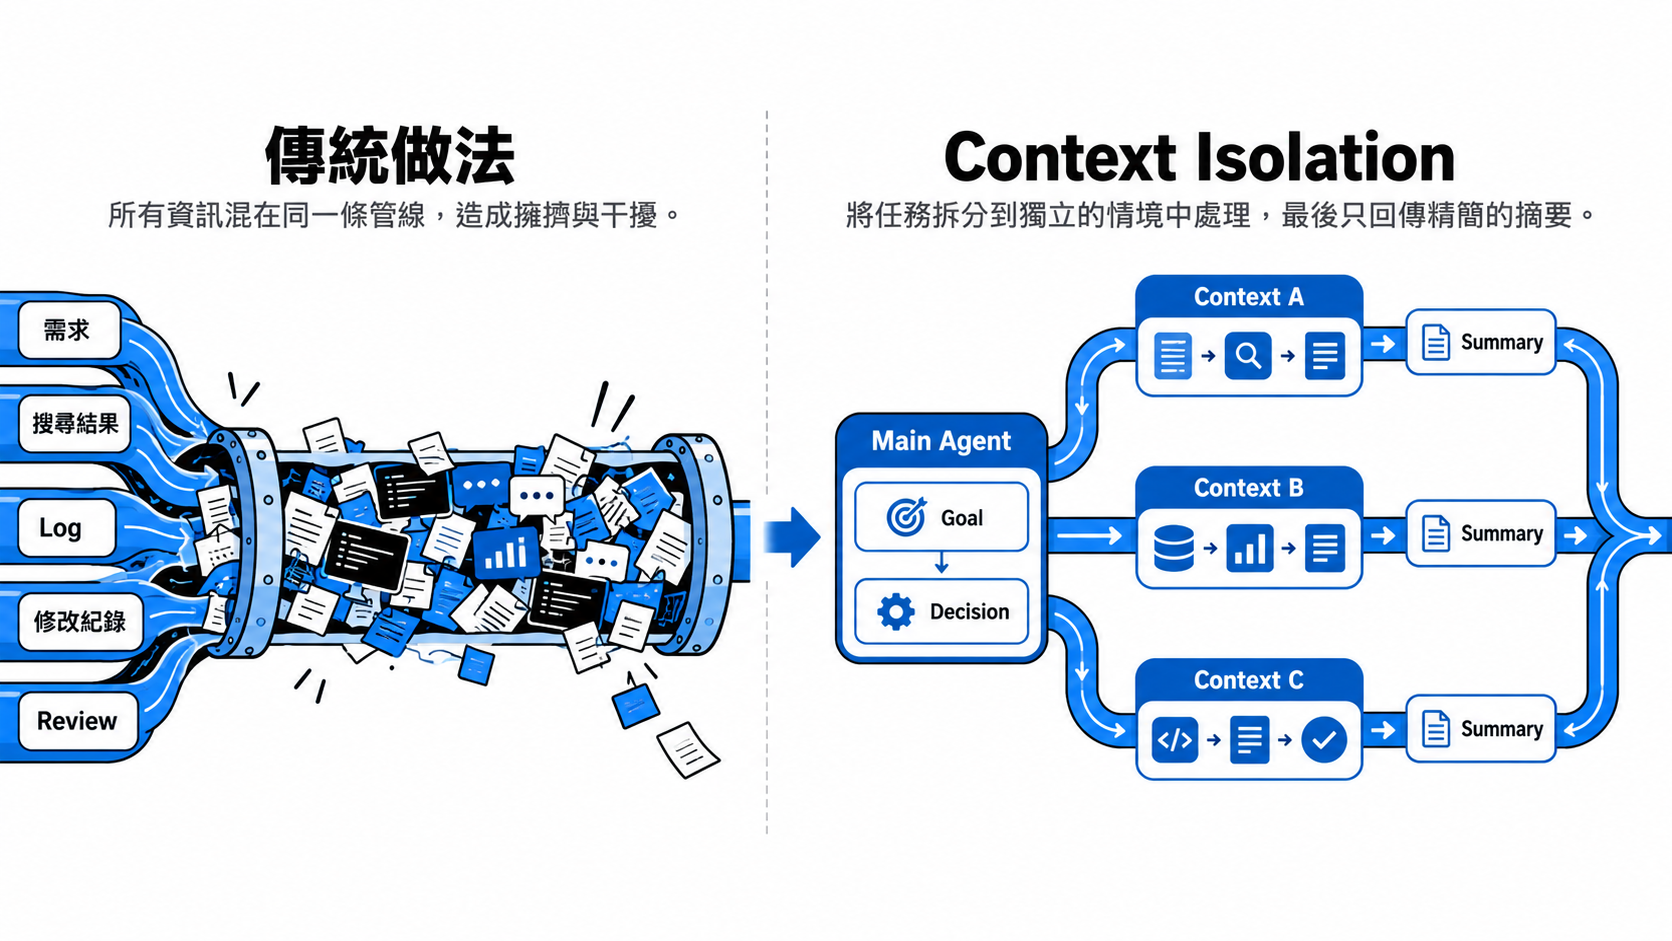
左側是一條被需求、搜尋結果、Log、修改紀錄與 Review 塞滿的長管線;右側 Main Agent 只保留 Goal 與 Decision,再分出三條乾淨支流,各自在獨立 Context 工作,最後只有 Summary 回流。
第一輪實驗因此可以換一種方式理解:三個 Reviewer 並沒有突然獲得三套完全不同的專業知識,它們只是獲得三個彼此分離的觀察空間。大型語言模型的生成也不保證每次沿著完全相同的路徑展開,相同材料在不同 Context 裡重新處理,注意力可能落在不同細節,問題排序也可能改變。這會提高 Review 的覆蓋範圍,卻還不足以構成穩定的團隊分工,因為三個 Agent 到目前為止仍在競爭同一份責任:大家都負責「找問題」。
📌 補充|獨立 Reviewer 並不等於獨立專家
三個 Agent 可以產生不同觀察,但它們仍可能共享相似的模型傾向、知識來源與盲點。增加 Agent 數量能增加觀察路徑,無法保證錯誤會互相抵銷。要把 Multi-Agent 從「多跑幾次」推進到可控的分工,下一步必須處理責任邊界。
第一輪到這裡留下了一個很自然的缺口:如果獨立 Context 可以讓三個 Reviewer 看見不同問題,那麼與其讓三個人繼續競爭同一份工作,能不能直接規定每個人要看什麼?
第二輪我沒有增加 Agent,仍然只開三個。改變的是工作定義。第一個 Fact Reviewer 專門處理事實、產品能力、技術敘述與引用;第二個 Writing Reviewer 只讀文章結構、段落功能、概念跳躍與閱讀節奏;第三個 SEO/GEO Reviewer 則追搜尋意圖、關鍵實體、問題式查詢,以及標題與正文是否對齊。三者仍然閱讀同一篇文章,但每一條 Context 都被賦予一套明確判準,也同時被劃出不要跨越的責任邊界。
實作 Prompt|替三個 Reviewer 劃出責任
建立 3 個 Subagents:
Fact Reviewer 檢查事實、產品能力、技術敘述、引用與論證依據;
Writing Reviewer 檢查文章結構、段落功能、資訊密度與閱讀節奏;
SEO / GEO Reviewer 檢查搜尋意圖、關鍵實體、問題式查詢與標題正文對齊。三者獨立完成後,再比較共同問題、專屬發現與彼此不同的修改方向。
證明第二輪改變的是責任設計,而非 Agent 數量。
這一次,結果呈現出比第一輪更清晰的分化。
| 角色 | 持續追問的問題 | 實際抓到的代表性缺口 |
|---|---|---|
| Fact Reviewer | 這項敘述是否成立? | 發現文章混用了桌面 App 本機工作區與 ChatGPT Work 雲端環境;部分產品能力缺乏足夠官方依據 |
| Writing Reviewer | 讀者能否沿著主線讀完? | 標題把 Side Chat 放在主角位置,正文卻到後段才真正讓它進場;前段提示詞與限制說明也出現重複鋪陳 |
| SEO / GEO Reviewer | 這篇文章究竟在回答哪個搜尋問題? | 文章同時競逐瀏覽數整理、Browser 工作流與 Side Chat 三種搜尋意圖,主查詢沒有收斂 |
三者仍然會在某些問題上交會,例如它們都察覺標題承諾與正文篇幅存在失衡,但抵達結論的路徑已經不同。Fact Reviewer 幾乎不討論文章好不好讀,而是一路追產品邊界:這項能力能不能這樣描述,證據是否足夠;Writing Reviewer 不重新驗證功能,而是沿著閱讀順序追問 Side Chat 何時第一次產生價值、哪些段落正在重複前面的工作;SEO/GEO Reviewer 則把文章重新視為一個搜尋答案,判斷讀者搜尋「ChatGPT Side Chat 怎麼用」時,這篇文章究竟有沒有對準那個問題。
責任邊界甚至讓它們對同一個缺口提出不同解法。Writing Reviewer 傾向讓 Side Chat 更早進場,把它重新拉回全文主線;SEO/GEO Reviewer 接受另一條路:完整工作流可以保留,但標題承諾也必須擴大,讓 Browser、CSV、資料核對與 Side Chat 都進入題目。兩個建議沒有互相否定,它們只是分別遵守「閱讀敘事」與「搜尋意圖」兩套判準,因此把同一個失衡推向不同修正方向。
第二輪比第一輪多出的,正是這種可控的注意力分配。第一輪把同一問題送進三個獨立 Context,增加觀察路徑;第二輪再替每條 Context 指定判準,讓它們集中處理不同責任。過去我經常把 Prompt 越寫越長,實際上是在要求同一個 Agent 不斷切換角色:研究完換成查核者,查核完再換成編輯,最後還要重新站到搜尋引擎與讀者的位置。Subagent 把這些角色拆開之後,Main Agent 的工作也跟著改變,它不再親自完成所有判斷,而開始分派、等待、比較與整合。
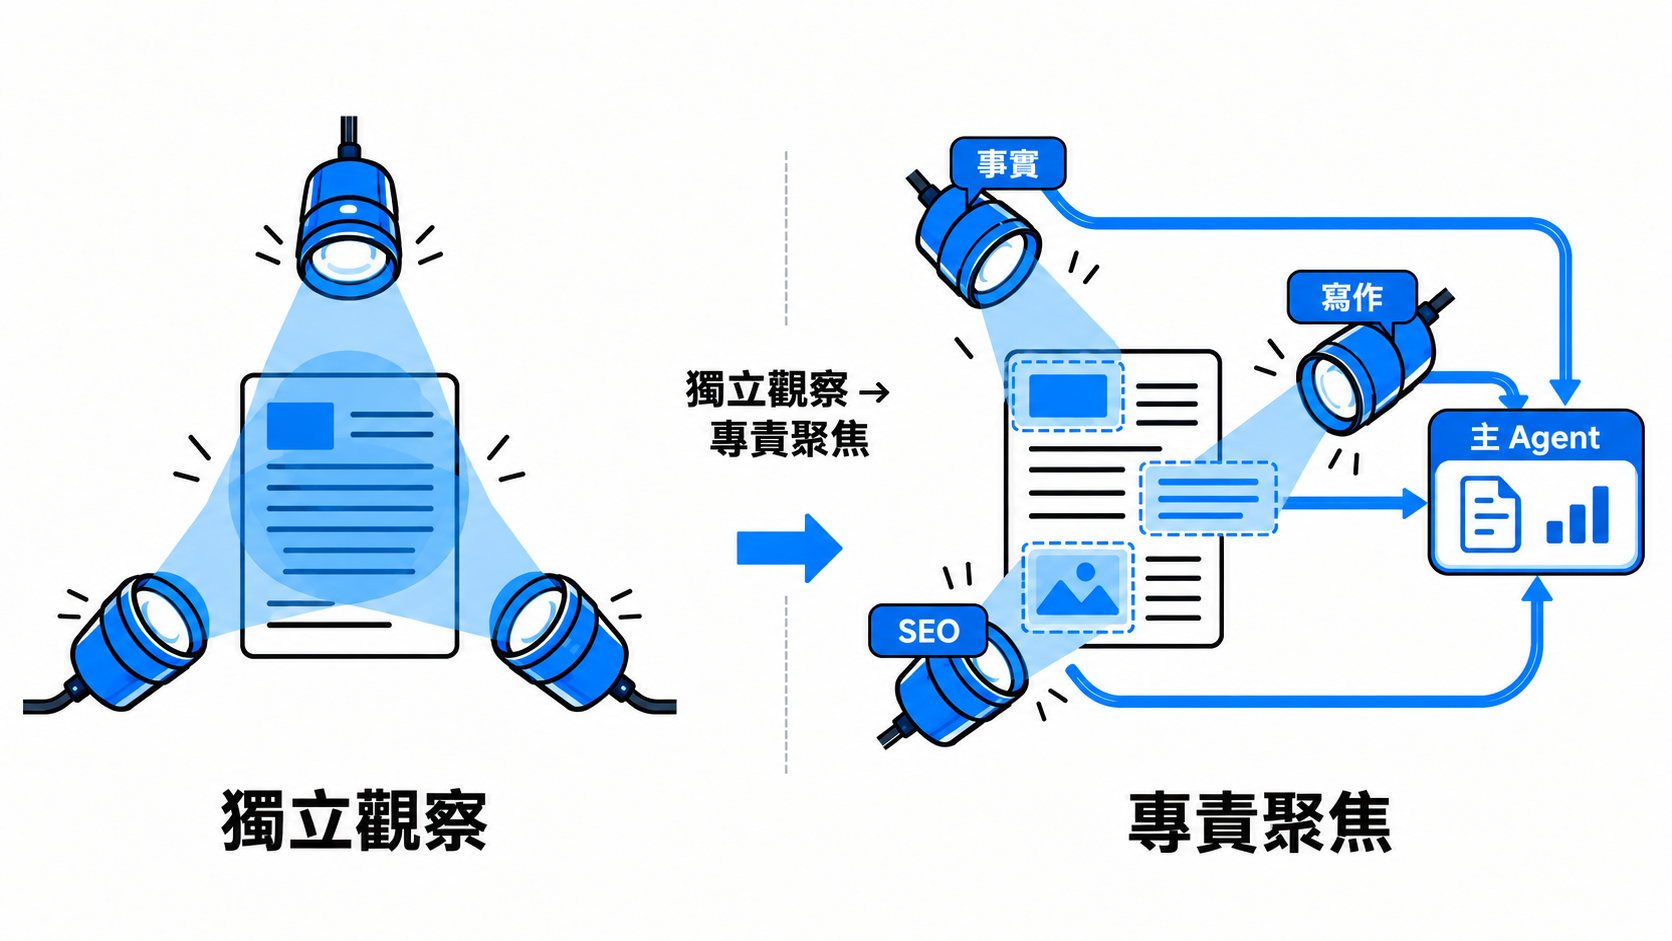
圖 2:左側同一份文件被三道相同聚光燈照射,光束大量重疊;右側改成 Fact、Writing、SEO 三種不同鏡頭,各自聚焦文件不同區域,再把結果匯回 Main Agent。
這也是「AI Team」第一次開始具備組織含義。團隊不靠 Agent 數量成立,而靠責任切割成立。當不同 Context 開始守住不同判準,同一件工作的品質也被拆成幾個可以分別檢查、最後重新整合的部分。
回頭看兩輪實驗,Subagent 至少出現了兩種截然不同的拆法。第一輪屬於 Independent perspectives:把同一個問題交給多個獨立觀察者,適合 Review、找漏洞、提出假設,以及任何「我不知道自己漏掉什麼」的任務;第二輪則屬於 Specialized roles:同一份成果交給不同判準,各自處理一個品質維度,文章、履歷、簡報、企劃與研究報告都可以用同樣方式拆。
再往外一步,還有一種在一般工作中很常見的 Partitioned workload。假設我要整理十二篇彼此獨立的論文,一個 Agent 可以從第一篇一路讀到第十二篇,也可以切成三批,由三個 Subagent 同時處理,再讓 Main Agent 統一比較研究問題、方法與結果。職缺、飯店、商品、競爭者、會議逐字稿與大量使用者回饋,本質上都能沿用這種切法。
三種模式最後都會看到多個 Agent,但 Agent 數量只是表象,真正決定架構的是工作如何被切開。
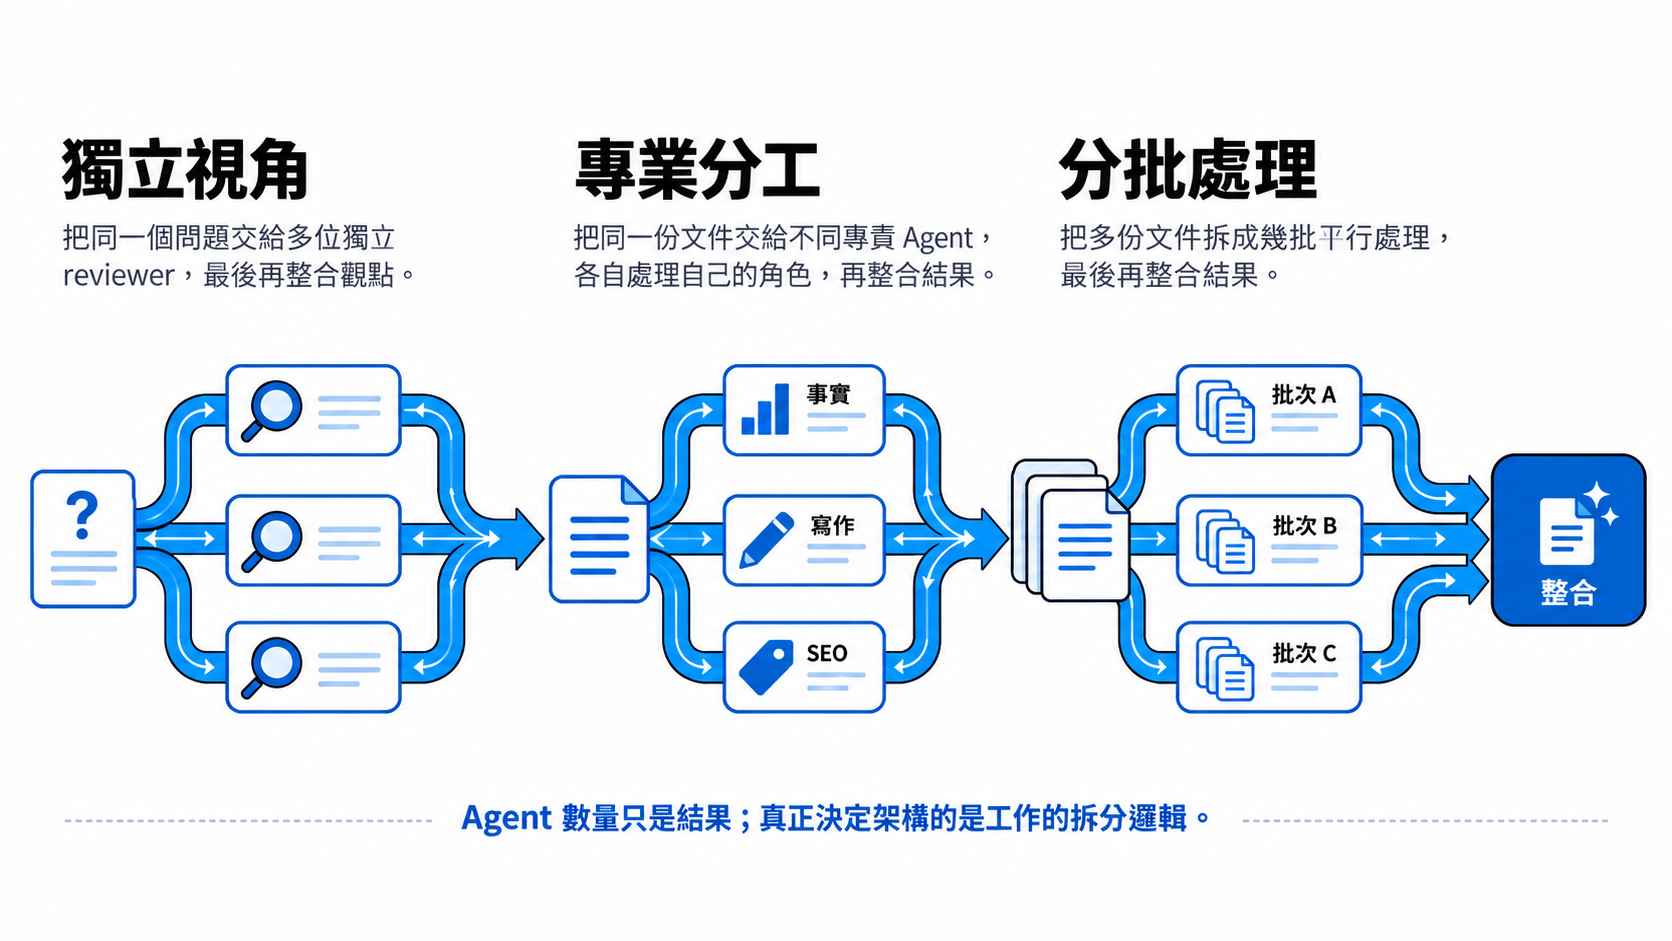
圖 3:Agent 數量是結果,拆工作的依據才決定架構。
判斷某件事適不適合平行拆出去,可以先問一個簡單問題:每一份工作能不能在不知道其他結果的情況下開始? 三篇文件可以分開 Review,三家公司可以獨立研究,Fact、Writing 與 SEO 也能同時讀同一篇文章,因為它們不必等待彼此先做出決定;如果 Analyze 必須接收 Research 的結果,Draft 又必須建立在 Analyze 之上,再多 Agent 也無法消除這條依賴鏈。到了那裡,問題已經從「誰來做」轉成「成果做完之後要流向哪裡」,那會是 Agentic Workflow 要處理的另一層結構。
Parallel 之外,Subagent 還留下另一個很實際的問題。第二輪裡的 Fact、Writing 與 SEO/GEO Reviewer 如果只使用一次,用自然語言臨時建立就夠了;但如果每一篇文章都要重新叫回同樣三個角色,那些角色定義就已經從「這次 Prompt 的要求」變成長期存在的工作規則。
這時 Custom Agent 才開始有價值。
目前 Codex 可以把反覆使用的角色保存下來,每個角色至少定義 name、description 與 developer_instructions。前兩項處理身份與適用情境,最後一項則真正決定責任邊界。以 Fact Reviewer 為例:
name = "fact_reviewer"

description = """
Reviews long-form articles for factual accuracy,
unsupported claims, and source quality.
"""

developer_instructions = """
Focus on factual claims, technical descriptions,
product capabilities, dates, and citations.

For every issue:
- identify the claim
- explain why it needs attention
- provide supporting evidence when possible

Do not rewrite prose for style.
Do not perform SEO optimization.
Prioritize high-confidence factual issues.
"""
📌 補充|TOML 不必自己寫
fact_reviewer不是 Codex 內建角色,而是依工作需求建立的 Custom Agent。基本設定至少包含name、description與developer_instructions,分別描述角色名稱、用途與行為邊界。
不熟悉 TOML 也沒關係,可以直接把範例交給 ChatGPT 或 Codex,再用自然語言描述新角色:請依照上述 Codex Custom Agent TOML 格式,建立一個
writing_reviewer。負責檢查技術文章的結構、段落功能、概念跳躍、資訊密度與閱讀節奏;不處理事實查核與 SEO。請直接輸出可儲存為.toml的完整內容。
真正需要設計的是角色責任、判斷準則與工作邊界;設定檔語法可以交給 AI。
這份設定裡最有價值的內容,反而是最後兩條限制。Do not rewrite prose for style. 與 Do not perform SEO optimization. 把角色從「什麼都可以幫忙」重新拉回一個清楚的責任域。角色要能重複使用,除了知道自己應該做什麼,也必須知道哪些判斷應該交給別人。模型、reasoning effort、MCP、Skills、sandbox 或同時開多少 Thread,都可以等角色本身穩定之後再調;如果責任設計仍然模糊,先優化這些參數只會得到更快、更昂貴的模糊分工。
兩輪 Review 跑完之後,我回頭看三個 Subagent 的工作紀錄,差異其實很明顯。第一輪裡,它們拿著同一份文章、同一套任務,卻各自停在不同問題上;第二輪加入 Fact、Writing 與 SEO/GEO 的責任後,這些差異又從偶然的觀察,變成可以預期的分工。到了 Custom Agent,原本寫在單次 Prompt 裡的要求,也開始被保存成長期角色。一路走下來,「多開幾個 Agent」反而只是表面現象,真正發生變化的,是原本塞在同一條 Context 裡的資訊與判斷,開始被重新分配。
Main Agent 的位置也因此慢慢改變。它不再需要親自完成每一項檢查,而是負責決定工作交給誰、哪些結果值得帶回主線,以及不同意見最後如何整合。做到這裡,前面累積的工具、Skills、專案知識、Git 與 Agent,才第一次像一套真正運作中的工作組織。不過這次實驗仍停在「誰負責什麼」;當 Research 必須先交給 Fact Review,確認之後才能進入 Writing,Agent 之間就不只剩下分工,還開始出現順序與依賴。下一個問題也因此浮了出來:角色已經分好了,工作接下來要怎麼在它們之間流動?


 iThome鐵人賽
 看影片追技術