
摘要
當一項工作開始交給多個 Agent,最直覺的做法通常是先分角色:有人查資料、有人寫作、有人審查。但角色只回答「誰負責」,還沒有回答工作如何流動。會改變 Workflow 形狀的,是三種關係:哪些工作可以同時進行、哪些需要等待上一棒的產物、哪些結果完成後仍要接受驗收並退回修改。這篇暫時把角色名稱放到一旁,改從節點之間的箭頭觀察工作流,讓讀者先看見「分流、接棒、回程」三種形狀,再替它們命名。理解這些關係之後,再回頭看 Coding Agent 的修改、測試與修正循環,就多了一張可以反覆使用的心智地圖。
把一項工作從一個 Agent 拆成三個,看起來通常更完整:Research 查資料、Writer 寫作、Reviewer 驗收。但真正讓 Workflow 開始出問題的,往往也在這裡。這三個 Agent 究竟要同時開工、排隊接棒,還是完成後接受檢查再退回修改?如果這些關係沒有先畫清楚,多一個 Agent,可能只是多一段等待、多一次重工,甚至讓整條流程卡在沒有人知道下一步該往哪裡走。
這篇我會用三種工作形狀——分流、接棒、回程——拆開 Parallel、Sequential 與 Loop,再把這張心智地圖放回 Codex 的 Edit → Run → Observe → Fix。讀完之後,你應該能先判斷哪些工作可以一起跑、哪些必須等待上一棒、哪些成果需要驗收與退回;也會看到 Coding Agent 真正拉開差距的地方,往往發生在第一版成果產生之後。
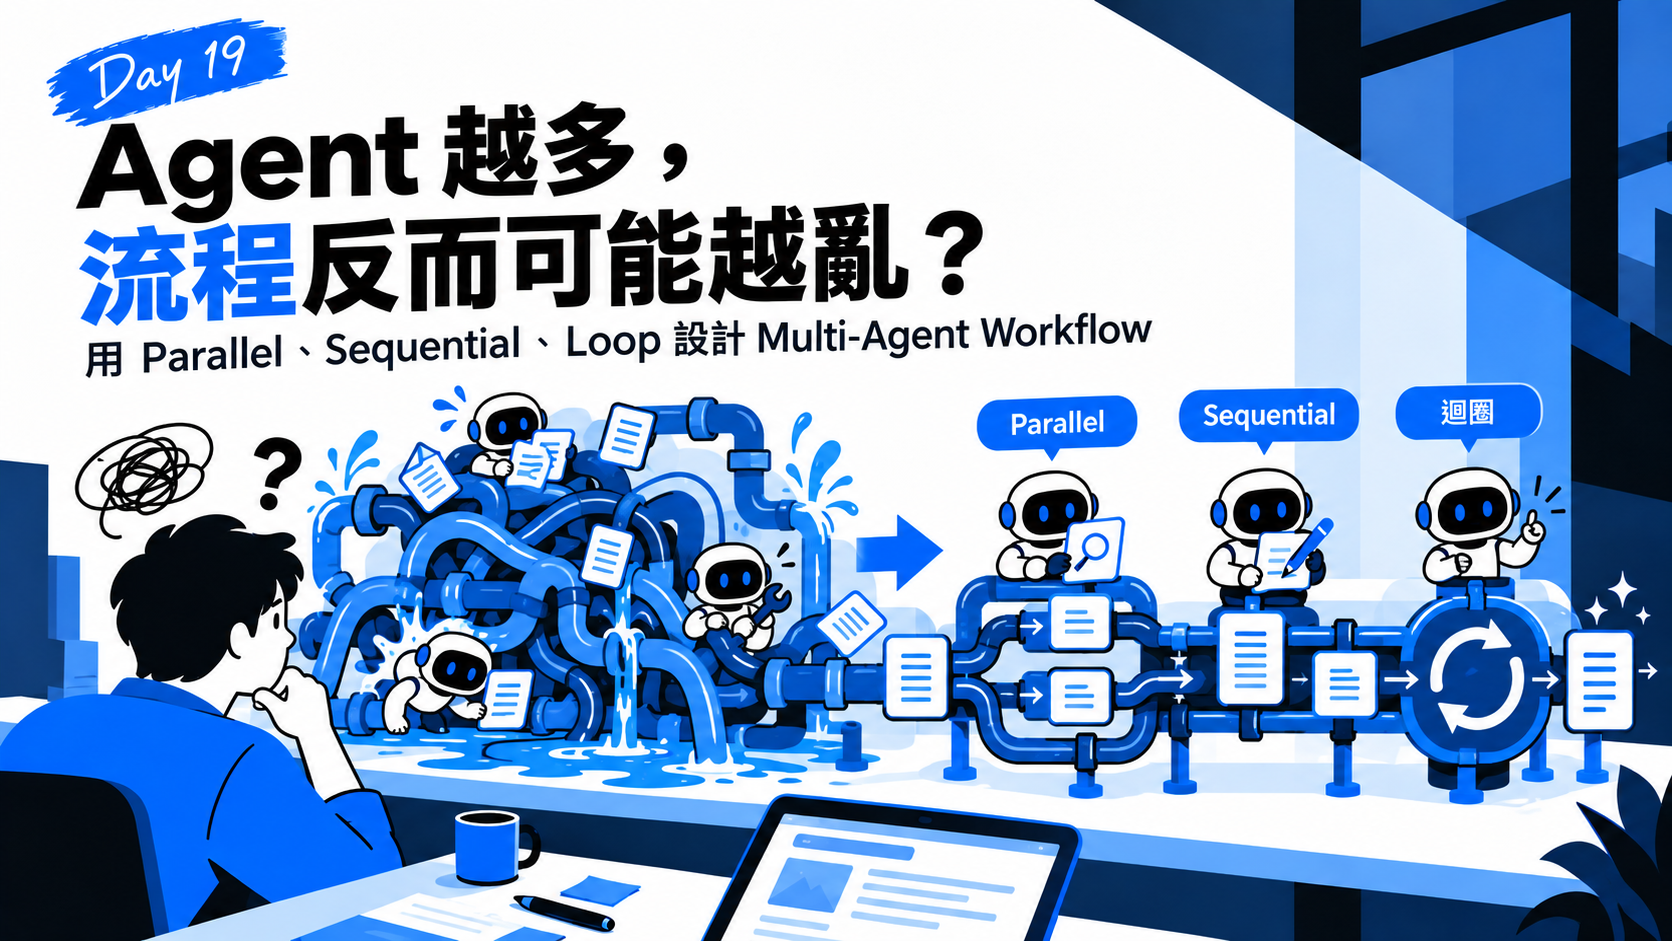
把一份工作拆給幾個 Agent 之後,畫面上最醒目的通常是角色。Research Agent 查資料、Writer Agent 寫內容、Reviewer Agent 負責檢查;角色切得越細,整套系統看起來越像一支分工完整的團隊。但角色名稱只處理了責任邊界,它沒有告訴我們 Research 做完以前 Writer 能不能開始,也沒有說 Reviewer 找到問題之後,結果應該流向哪裡。
Workflow 的差異,開始出現在節點之間的連線。同樣三個 Agent,可以同時拿到一份輸入,各自完成後再把結果收回;也可以排成前後順序,前一棒交出產物,下一棒才取得工作的材料。最後一個 Agent 完成之後,流程還可能多一道驗收,不合格就沿著另一條路退回修改。Agent 沒有換人,光是改變連線,工作方式已經完全不同。
因此我現在看 Multi-Agent Workflow 時,會先把角色名稱拿掉,只留下工作本身。哪些事情可以同時發生?哪些事情必須等待上一個結果?什麼情況下完成的工作還要被送回去?這三個問題,已經足以畫出接下來會反覆出現的三種基本關係。
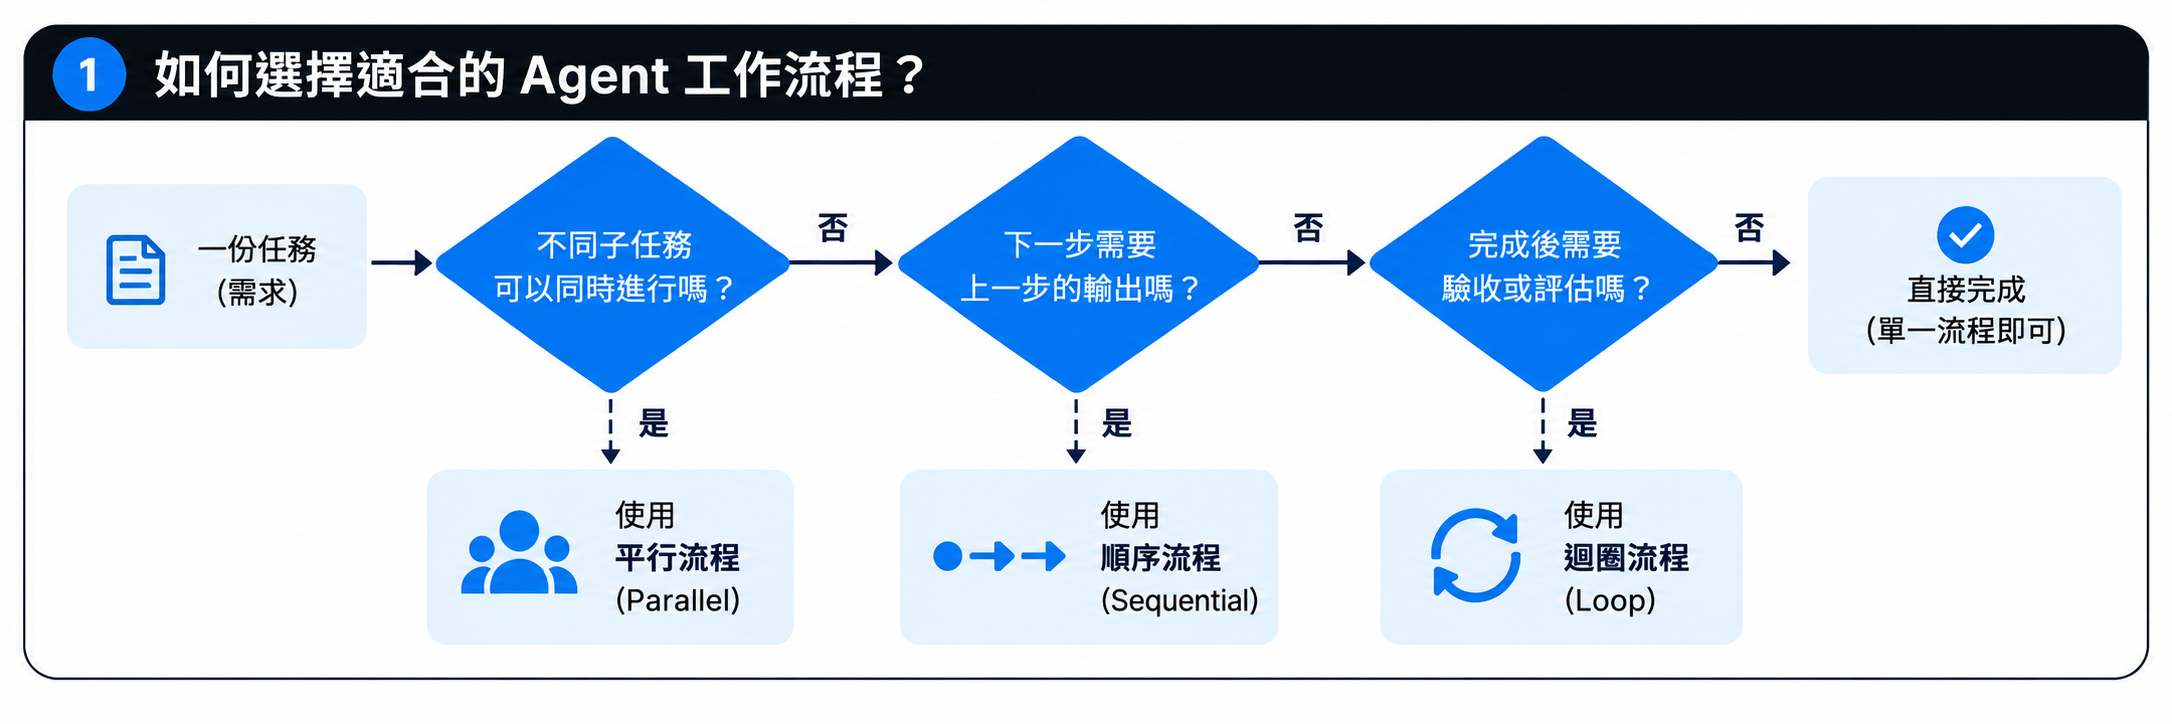
圖 1|Agent Workflow 的三個判斷:任務之間是否互相依賴 → 可以平行或需要依序;產出是否需要驗收 → 決定工作是否形成迴圈。
先想一篇已經完成的技術文章。我想確認事實是否正確,也想檢查文章結構,同時看看搜尋意圖與關鍵字是否完整。三件工作拿到相同輸入,但事實查核不需要等待編輯先看完,編輯也不需要知道 SEO Reviewer 已經提出哪些建議。既然彼此沒有交換中間產物,把它們硬排成 Fact Check → Writing Review → SEO Review,沒有增加資訊,只是讓後面的工作站在原地等待。
把工作向外展開,一份文章同時進入三條工作線,各自處理不同範圍,等結果完成後再收回同一個節點。這就是 Parallel 最基本的形狀;從資料流來看,也常稱為 Fan-out / Fan-in。它壓縮的是等待時間,工作量並沒有因此消失。不同來源的研究、同一份內容的多角度 Review,或任何能切成獨立區塊的工作,都適合用這種方式展開。現有的 Agent Workflow 架構也把「可同時執行的獨立工作」與「蒐集多種觀點」列為 Parallel 的典型情境。
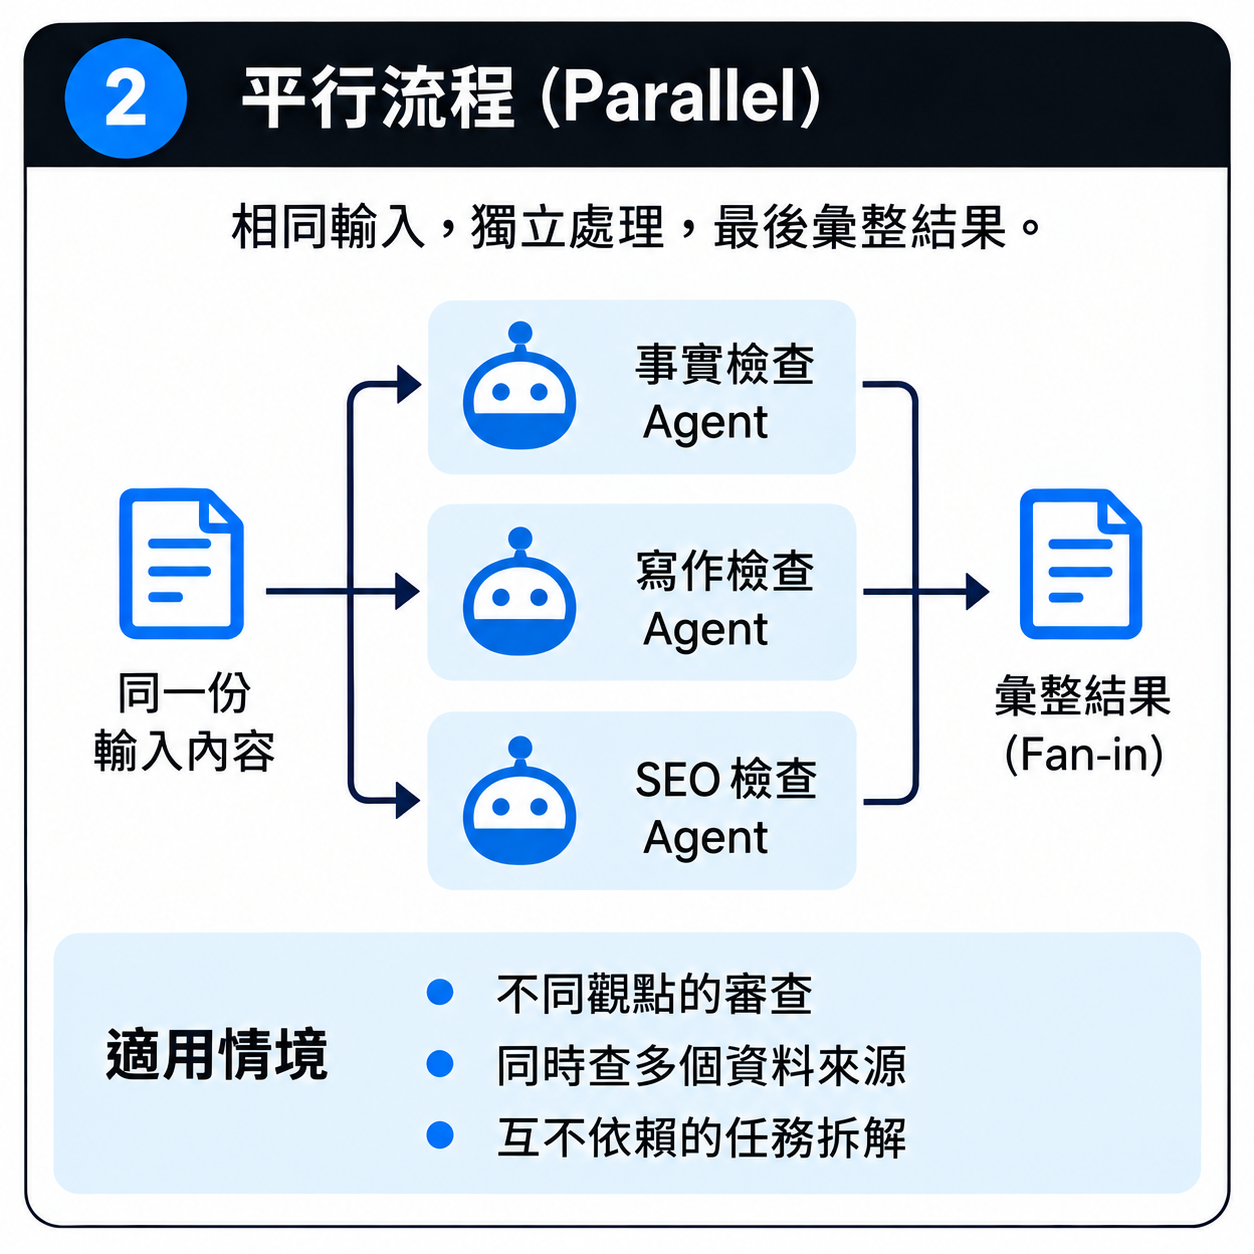
圖 2:一份輸入向外分流 → 多個獨立工作同時推進 → 結果重新收斂。
分流把一部分成本推到最後。三個 Reviewer 可能重複指出同一個問題,也可能做出互相衝突的判斷;最後的 Fan-in 節點因此還要去重、比較與收斂結果。平行執行也會提高即時資源與 Token 使用量,換來較短的整體等待時間。 只要其中一條工作開始需要另一條的產物,這種平行關係就維持不下去,工作也會自然進入另一種形狀。
從零完成一篇文章就會出現這種改變。Research 找到的資料要先接受 Fact Check,確認後留下的內容再成為 Writer 的材料,初稿完成才能交給 Reviewer。Writer 就算提早半小時出現,也沒有多少事情可以做,因為它還拿不到真正的輸入。
這條「拿不到上一棒的產物,就無法往下做」的關係,就是 Dependency。當 Dependency 出現,原本並排的節點開始沿著同一個方向排列:Research → Fact Check → Writing → Review。前一步的 Output 成為下一步的 Input,工作也第一次有了明確順序。這種結構通常稱為 Sequential;放進工程語境裡,也可以把它理解成一條 Pipeline。正式的 Agent 架構定義同樣把 Sequential 描述為預先定義的線性流程,由前一個 Agent 的輸出直接供給下一個 Agent。
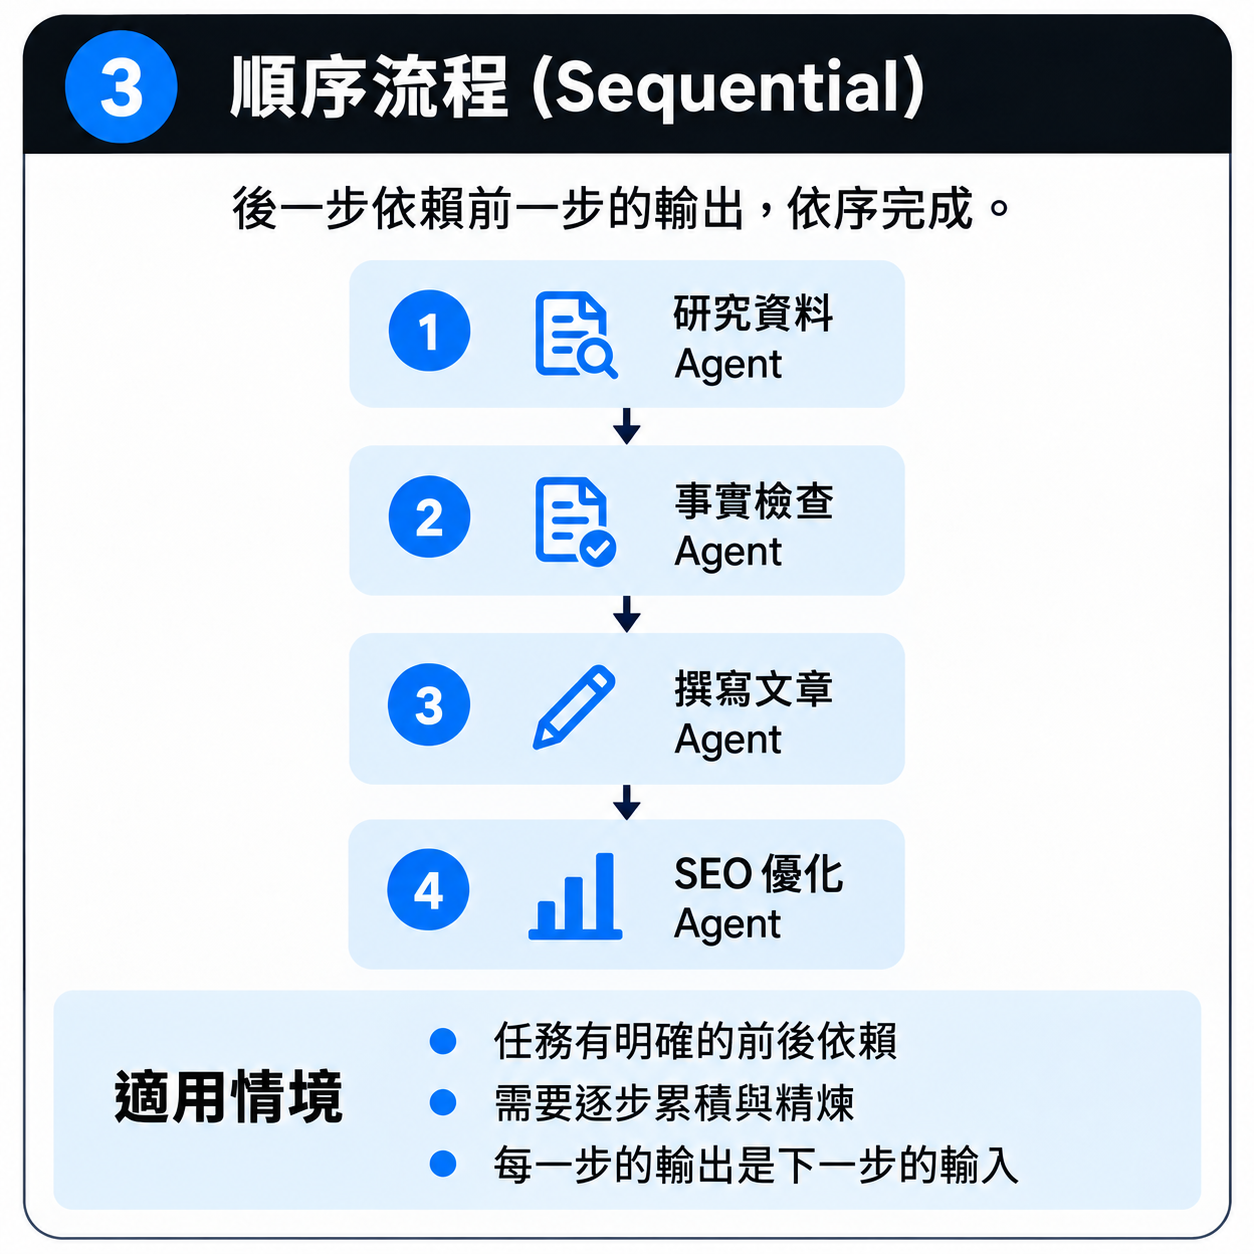
圖 3:每一棒的產物沿著同一個方向交給下一棒。
Pipeline 描述的是工作的先後約束,不是 Agent 數量。Research 與 Fact Check 可以交給兩個 Agent,也可以由同一個 Agent 依序完成;四個步驟同樣不代表一定要準備四個角色。角色只是站在節點上的執行者;Dependency 決定上游產物如何流向下游工作。
順序穩定、可以預先描述的流程,很適合這種結構。資料可以依序經過擷取、清洗與寫入;內容也可以沿著研究、撰寫、編輯一路往前。這份秩序同時形成限制:上游一旦阻塞,下游工作一起等待;早期產物帶著錯誤往下傳,後面的 Agent 還可能繼續在錯誤基礎上加工。Sequential 解決了「誰需要等待誰」,卻還沒有回答最後一個問題:最後一棒跑完,工作就真的算完成了嗎?
程式碼很容易暴露這個缺口。檔案已經修改完成,仍然可能編譯失敗、測試沒過、破壞既有功能,或者在手機畫面產生超出預期的水平捲動。文章也一樣,Writer 停筆只代表初稿存在,裡面的數字可能沒有來源、段落可能偏離題目、格式也可能沒有符合發布要求。Pipeline 可以把工作一路送到終點,卻無法單靠流程位置判斷結果是否合格。
只要在 Output 後面加上一個驗收節點,工作線就多出一條回程路徑。結果先送去檢查,符合條件就離開流程;沒有跨過門檻,具體 Feedback 送回修改端,完成修正後再次接受驗收。負責判斷結果是否達標的角色,可以稱為 Evaluator;根據 Feedback 修改結果的角色則扮演 Optimizer,兩者之間形成 Evaluator–Optimizer Loop。
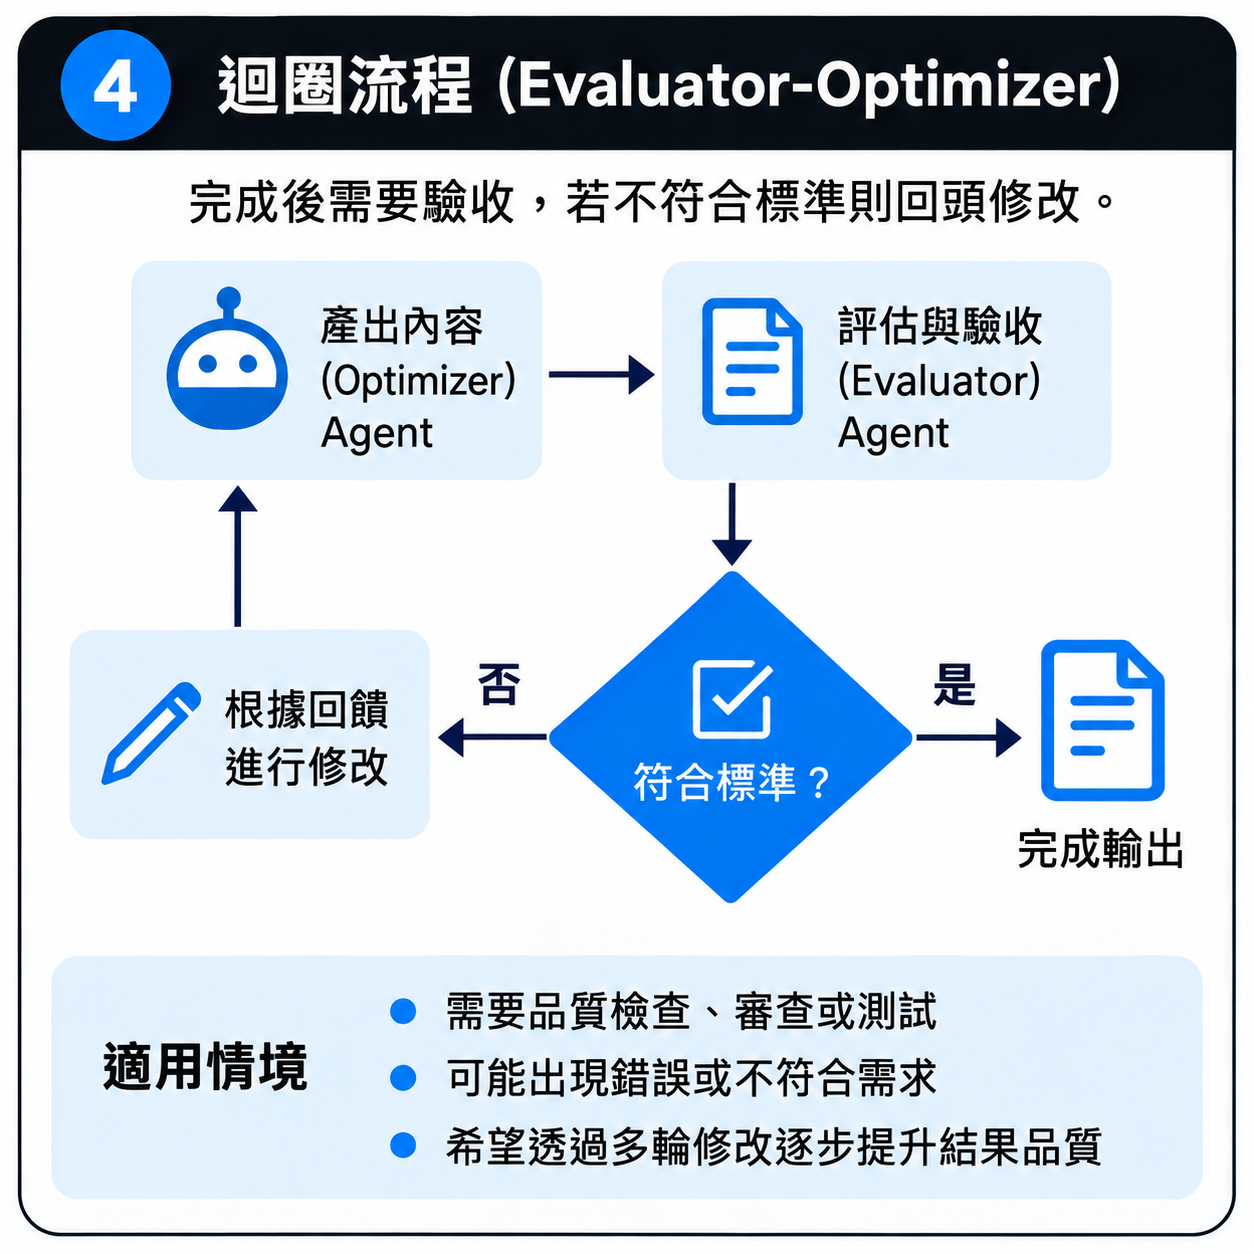
圖 4:未通過 → Feedback → Optimize → 再次 Evaluate
這張圖的關鍵落在中間那個 Pass?。如果要求只是「再幫我檢查一次」或「讓文章更好」,Evaluator 幾乎永遠可以提出新的意見,工作也沒有明確停止的位置。Loop 要能收斂,必須把抽象的「好」轉成驗收門檻與終止條件:重要數字必須附來源、所有自動化測試必須通過、375px 寬度下不能出現水平捲動、輸出必須包含規格指定的欄位。沒有跨過門檻,Feedback 沿著回程路徑送回修改端;跨過之後,流程才取得離開 Loop 的條件。
現有的 Agent Workflow 設計也把 Review and Critique、Iterative Refinement 視為 Loop 的具體形式,並要求定義品質門檻、最大迭代次數或其他 termination condition,避免流程無限循環。 Parallel 管理哪些工作不用等待,Sequential 管理誰必須接上一棒,Loop 則開始管理 Feedback 與收斂。
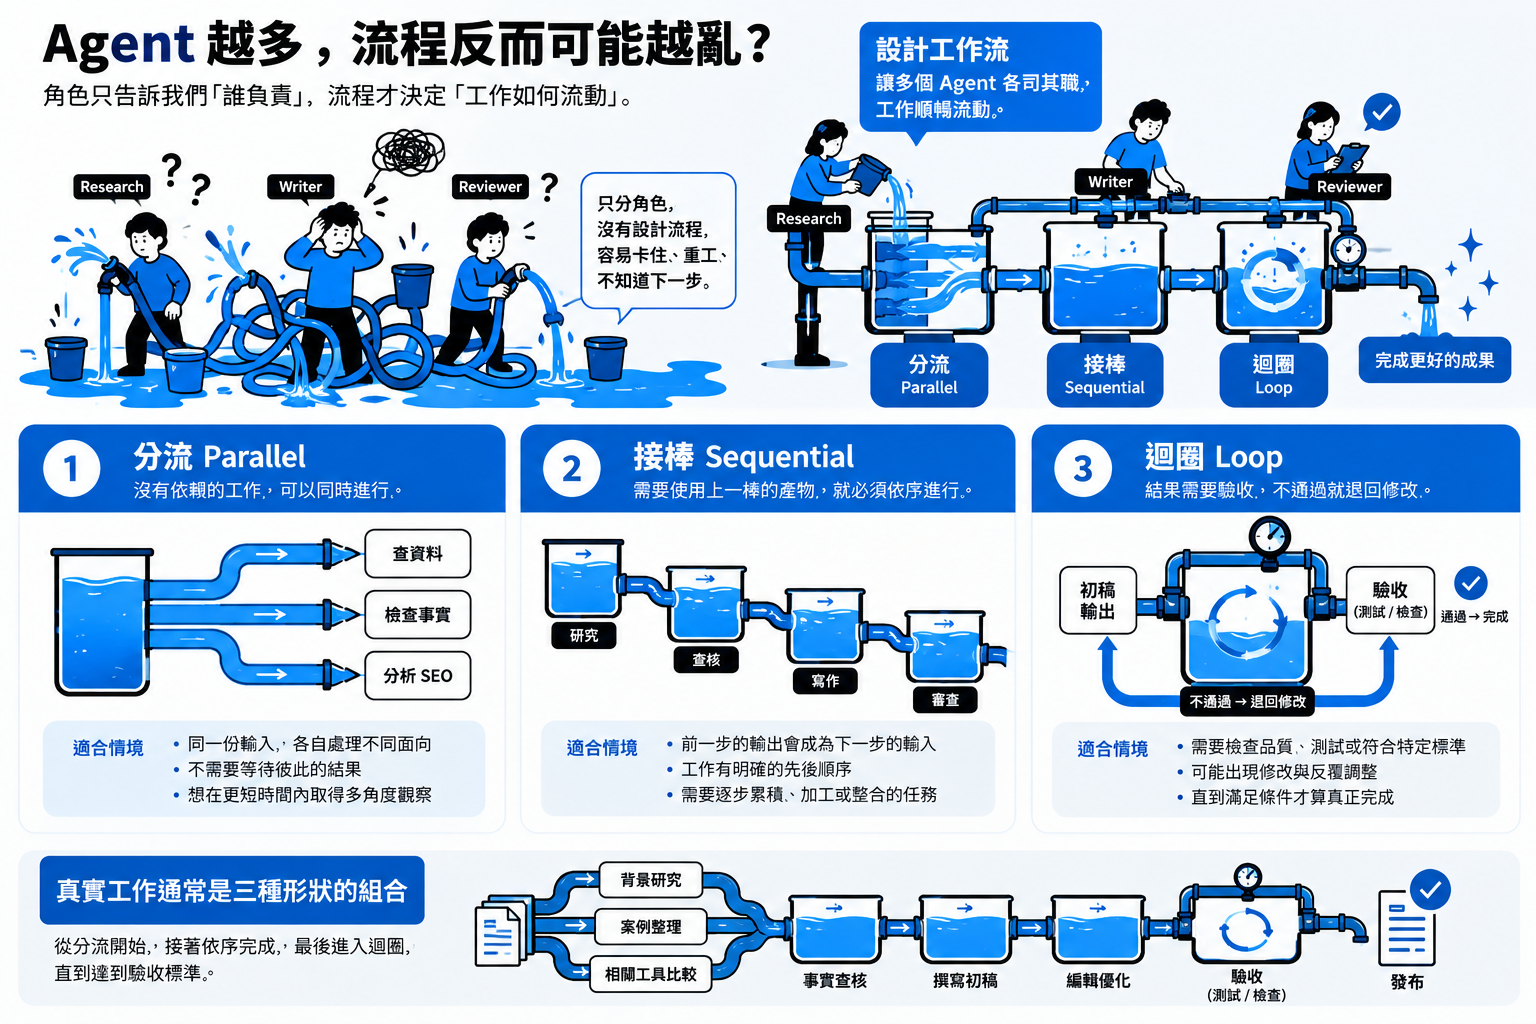
真實工作很少只使用一種形狀。準備一篇深度技術文章時,可以先讓幾條 Research 線平行查找不同來源,結果收斂後進入 Fact Check,再沿著 Writing、Editing 的 Pipeline 往下走;文章完成後交給 Evaluator 驗收,不符合條件,就沿著回程路徑送回修改。整條線最後可能長成:Parallel → Merge → Sequential → Evaluate → Optimize → Evaluate。複雜的 Agent Workflow 本來就可以混合不同 Pattern,而不是強迫整個系統只選其中一種。
三種 Pattern 處理的是不同關係:Parallel 處理獨立性,Sequential 處理 Dependency,Loop 處理 Feedback 與停止條件。因此設計 Workflow 時,我不會先問需要幾個 Agent,而是先問:哪些工作可以一起跑?哪些需要接棒?哪些結果必須驗收? 這三個答案畫完,Workflow 的骨架通常已經浮出來,Agent 才開始有位置。
節點決定誰來工作,箭頭決定工作如何發生。
這套模型放進軟體開發後,Loop 會變得更具體。程式碼除了被 Agent 閱讀,還能直接執行;修改完成可以跑 tests,測試失敗留下 error,修正後再跑一次。Build、Lint、Diff、瀏覽器狀態都可能產生新的證據,原本的一次修改因此展開成 Edit → Run → Observe → Fix → Run again。目前較新的 Codex Workflow 指南,也把 planning、implementation、verification evidence、tests 與 acceptance criteria 放在同一套工程流程裡,讓執行結果能繼續約束後續工作。
更值得注意的是,Evaluator 不一定是另一個 Agent。 在內容工作裡,「這段是否清楚」往往還要交給模型或人判斷;到了軟體工程,test runner、compiler、terminal output、browser state 都能直接參與驗收。Agent 改變環境,環境回傳狀態,這些狀態再進入 Context,推動下一輪行動。Evaluator 從一個角色,擴張成整個可回饋的執行環境。
這讓 Coding Agent 多出一個很重要的條件:它不只產生成果,也能從成果被執行後留下的證據繼續工作。 後面再看 Codex 時,比「它能寫多少程式碼」更值得追的是這條 Feedback Loop——測試、錯誤、Diff 與畫面狀態,究竟能把下一步行動推到什麼程度。
當環境開始回話,Prompt 就只是工作流的入口。
後面的行動,開始由回饋推動。
Multi-Agent Workflow 的核心不在 Agent 數量,而在節點之間的關係。沒有依賴的工作可以 Parallel 展開;上一步產物會成為下一步輸入,就形成 Sequential;成果需要驗收與退回修改,則進入 Loop。角色決定誰執行,箭頭決定資訊如何流動、誰等待誰,以及工作何時完成。
Coding Agent 又讓這套結構多了一層環境回饋。程式碼經過 Edit → Run → Observe → Fix,tests、error、Diff 與 browser state 都能成為下一輪行動的證據。因此衡量 Codex 的重點不只在第一版生成得多快,而在它能否取得 Feedback、修正結果並反覆驗證,直到跨過驗收門檻。Prompt 決定起點,Workflow 決定路徑,Feedback 決定成果能否真正收斂。


 iThome鐵人賽
 看影片追技術