
在 Day 18,我已經完成 Google Maps 評論的取得,也把評論整理成 Prompt,準備交給 Gemini 分析。
原本以為接下來只要呼叫 API,就可以讓 AI 自動產生避雷報告,沒想到真正開始測試後,才發現還有不少問題要處理。
像是明明只取得 5 則評論,報告卻顯示有 17 次評論提到餐點;Gemini 也一直出現 503、404 等錯誤,好不容易有回傳資料,最後卻又卡在 JSON 解析失敗。
這些問題讓我花了不少時間反覆修改程式碼、查看 Console 和測試不同的寫法。
今天就來記錄一下,我是怎麼一步步找出問題,最後讓 Gemini 成功產生 AI 避雷報告的!
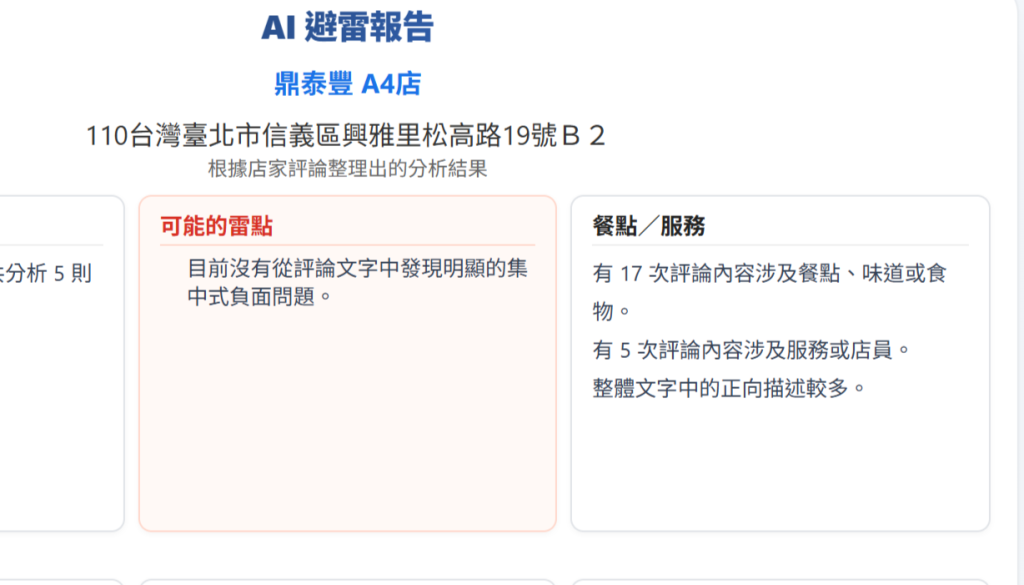
遇到的是本地降級分析的問題。
因為 Gemini API 當時一直呼叫失敗,所以昨天網站會使用原本的關鍵字分析邏輯產生報告。
但我發現,明明只有取得 5 則評論,報告卻顯示:
有 17 次評論內容涉及餐點、味道或食物。
看到這個結果時,我就覺得有點奇怪。評論總共才 5 則,怎麼會出現 17 次?
後來重新檢查,才發現問題出在關鍵字的計算方式。
原本的程式會逐篇檢查評論,再逐一比對每個關鍵字。只要符合條件,就會將計數加一。
例如,一篇評論同時提到小籠包、炒飯、酸辣湯和好吃,程式就可能將它計算成 4 次。
但我真正想知道的,是「有幾篇評論提到餐點」,而不是「總共命中了幾個關鍵字」。
我將原本的計算方式改成 filter() 搭配 some()。
function countMatchingReviews(keywordList) {
return texts.filter(text =>
keywordList.some(kw => text.includes(kw))
).length;
}
這樣只要一篇評論符合其中一個關鍵字,就只會計算一次,不會因為同一篇評論提到多種食物而重複累加。
修改後,評論數量的計算就比較符合原本預期的結果了。
這次也讓我發現,程式沒有報錯,不代表計算結果一定正確。有時候還是得回頭檢查邏輯,才能找到真正的問題。
修改後
有正確分析評論,這是雲端分析的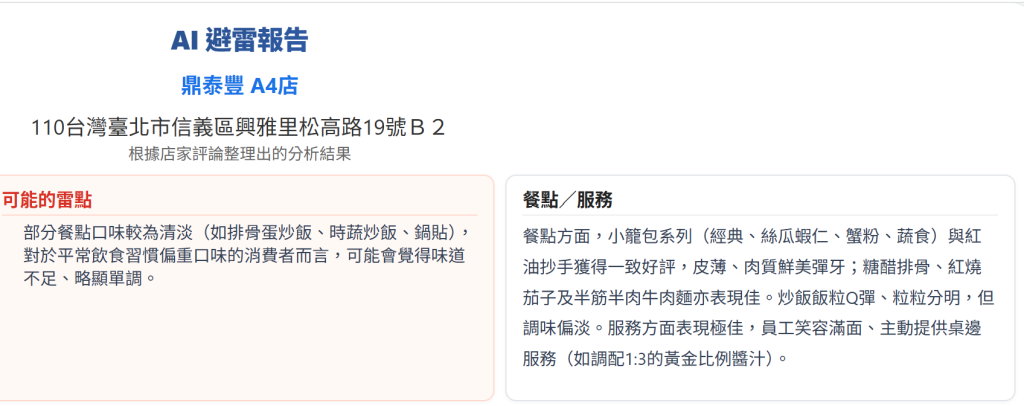
解決評論計數的問題後,接下來就是處理 Gemini API。
這部分真的讓我花了不少時間。
原本遇到 API 呼叫失敗的問題,後來好不容易取得回應,卻又出現另一個錯誤:
SyntaxError: Unexpected end of JSON input
Error: Gemini 回傳不是有效 JSON
一開始我以為是 Gemini 沒有按照要求回傳 JSON,所以重新檢查 Prompt,但後來印出回傳物件進行檢查,才發現問題不一定出在 Gemini 產生的內容,而是我在程式中取得回傳文字的方式有問題。
原來是取錯回傳欄位!
當時使用的 Interactions API 回傳物件中,文字內容可以透過 output_text 取得。
但我原本的程式使用了錯誤的屬性路徑,導致最後取得的字串是空的。
當程式拿空字串執行 JSON.parse() 時,自然就會發生解析錯誤。
除了修正文字取得方式,我也增加了 JSON 格式的處理流程,避免模型回傳 Markdown 程式碼區塊或其他多餘文字時,直接影響解析。
這次讓我學到,當 API 出現問題時,不能只一直修改 Prompt,也要確認自己有沒有正確讀取 API 回傳的資料。
除了程式邏輯和 JSON 解析問題,API 本身的錯誤也讓我很頭痛。
測試期間,我遇到了 503 和 404 等錯誤。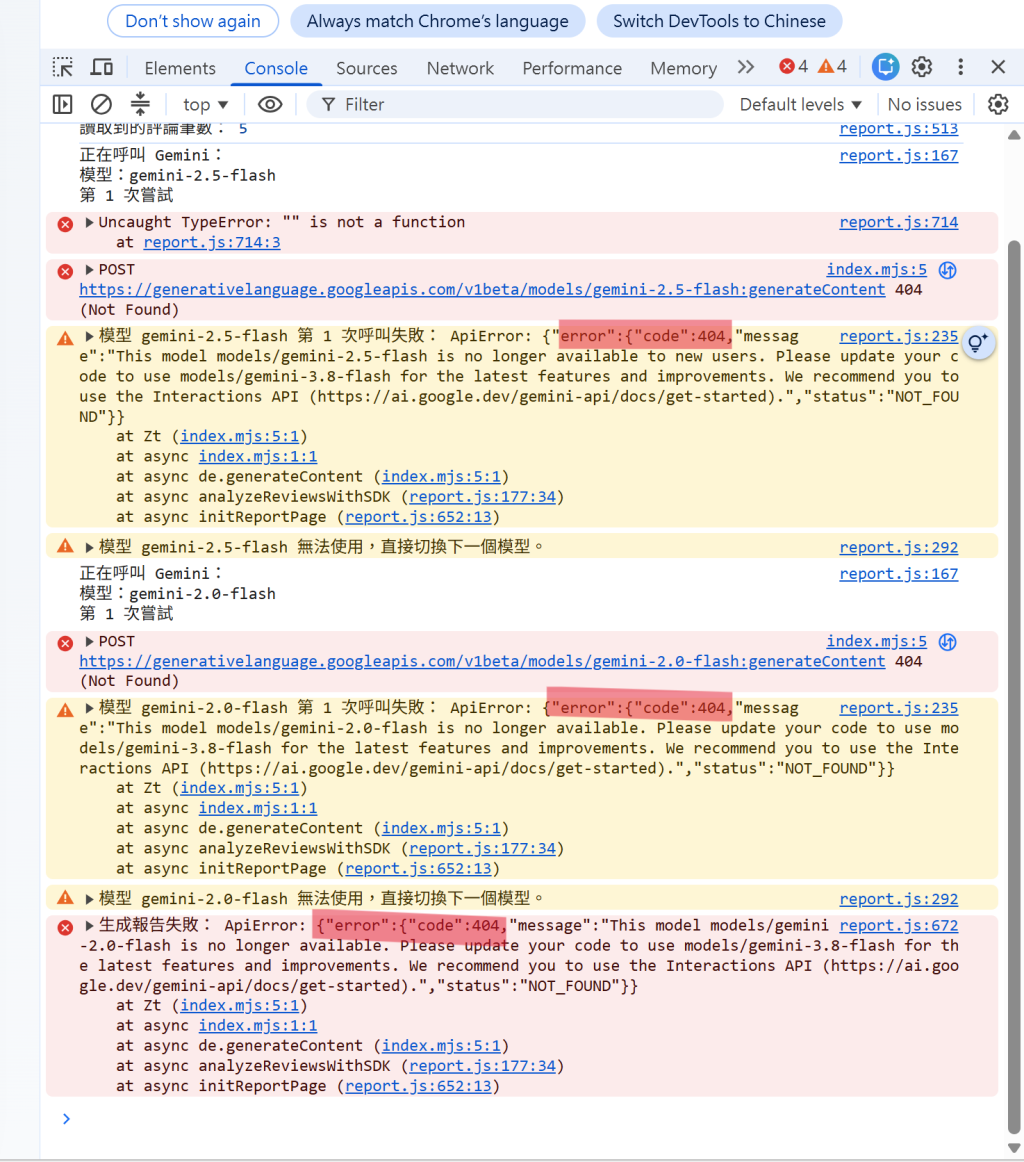
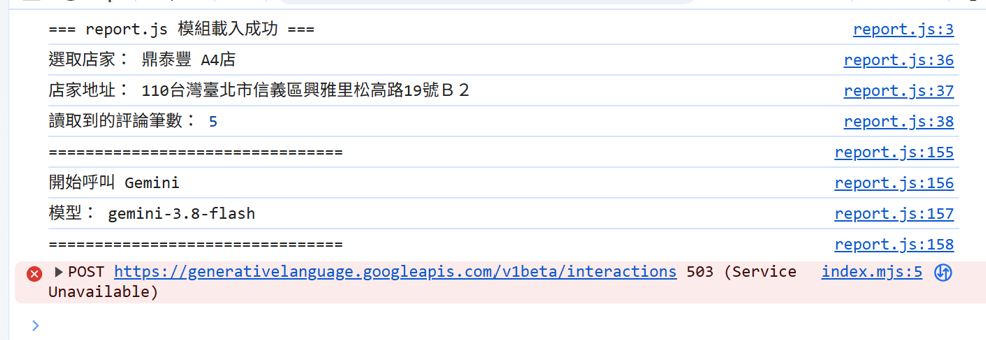
503 通常代表服務暫時無法處理請求,例如遇到流量過大或服務端問題;404 則可能與指定的模型名稱或資源不存在有關。
這也代表,就算程式碼寫得沒有問題,也不一定每次都能成功呼叫模型。
首先,我重新檢查模型名稱與 API 的使用方式,確認指定的模型是否可用,以及目前的 API 是否支援相關設定。
接著,我也調整了模型呼叫流程,嘗試建立備援機制。
概念上,就是先呼叫主要模型,如果遇到可重試的錯誤,再依序嘗試其他可用的模型。
例如:
const CANDIDATE_MODELS = [
"可用的模型名稱 A",
"可用的模型名稱 B",
"可用的模型名稱 C"
];
這裡的名稱需要依照當下 API 支援的模型清單設定,不能直接假設所有模型名稱都有效。
另外,我也檢查了不必要的模型設定,避免使用目前串接流程不需要的參數。
不過,模型輪詢並不能保證每次都成功。如果所有模型都遇到服務限制、額度不足或其他錯誤,仍然需要妥善處理失敗情況。
這次最大的體會是,串接 AI 不只是把 API 呼叫成功,還要考慮當 API 無法使用時,網站該怎麼繼續運作。
經過多次測試
最後成功呼叫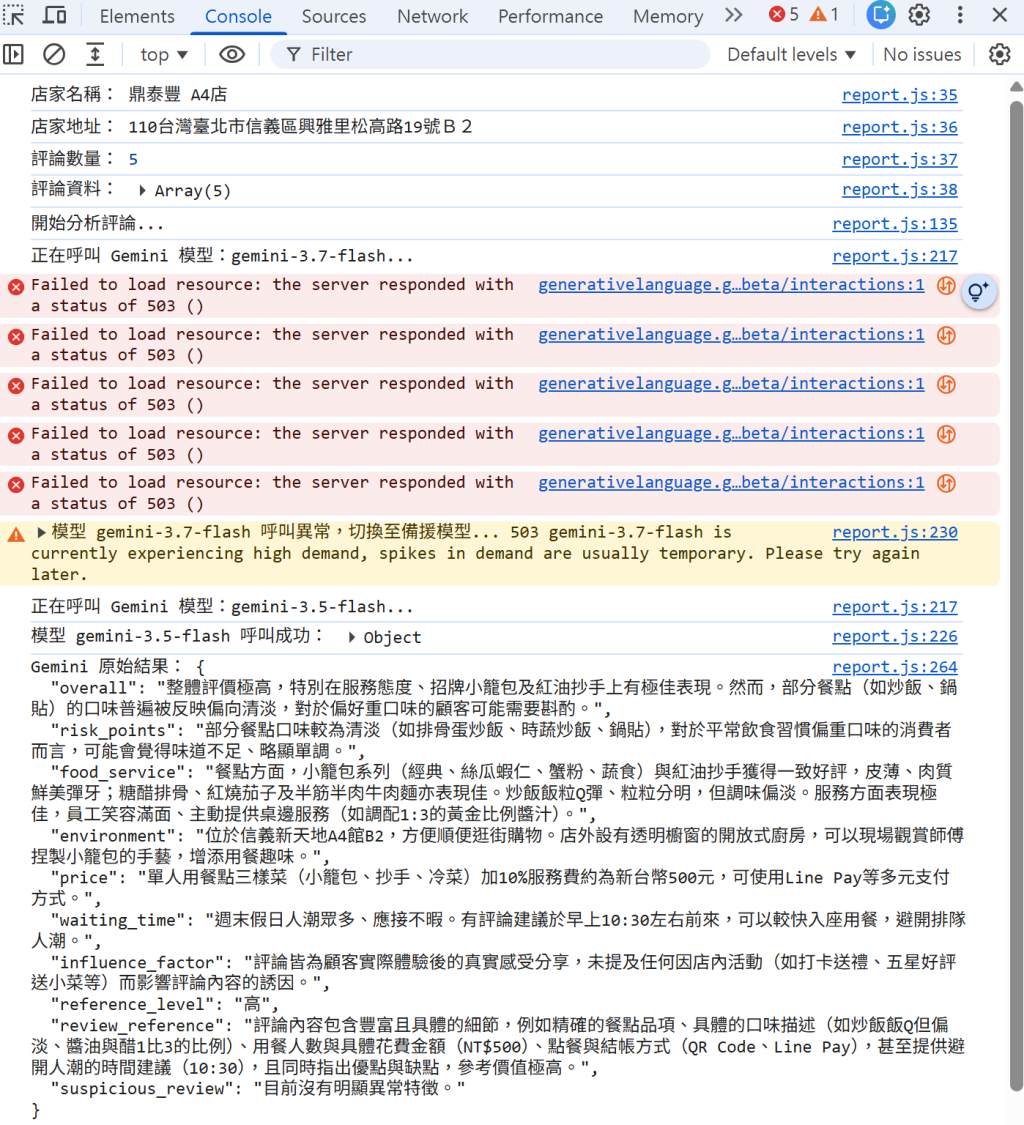
解決 API 問題的同時,我也開始注意到網站的操作體驗。
因為** AI 分析需要等待一段時間**,如果使用者按下分析按鈕後,畫面完全沒有變化,很容易讓人以為網站卡住了。
因此,我替分析流程加入了 Loading 載入畫面。
當使用者開始分析評論時,畫面會顯示半透明遮罩,並提示目前正在進行的工作。
例如:
正在整理店家評論……
正在連線至 AI 模型……
AI 正在分析評論內容……
分析完成,正在產生報告……
等到分析成功,或程式確認需要使用備援分析方式時,再依照實際狀態更新畫面。
這樣使用者在等待的過程中,至少能知道網站還在處理資料,而不是完全沒有反應。
雖然這只是網站上的一個小功能,但實際操作起來,整個流程就會更完整。
實際執行畫面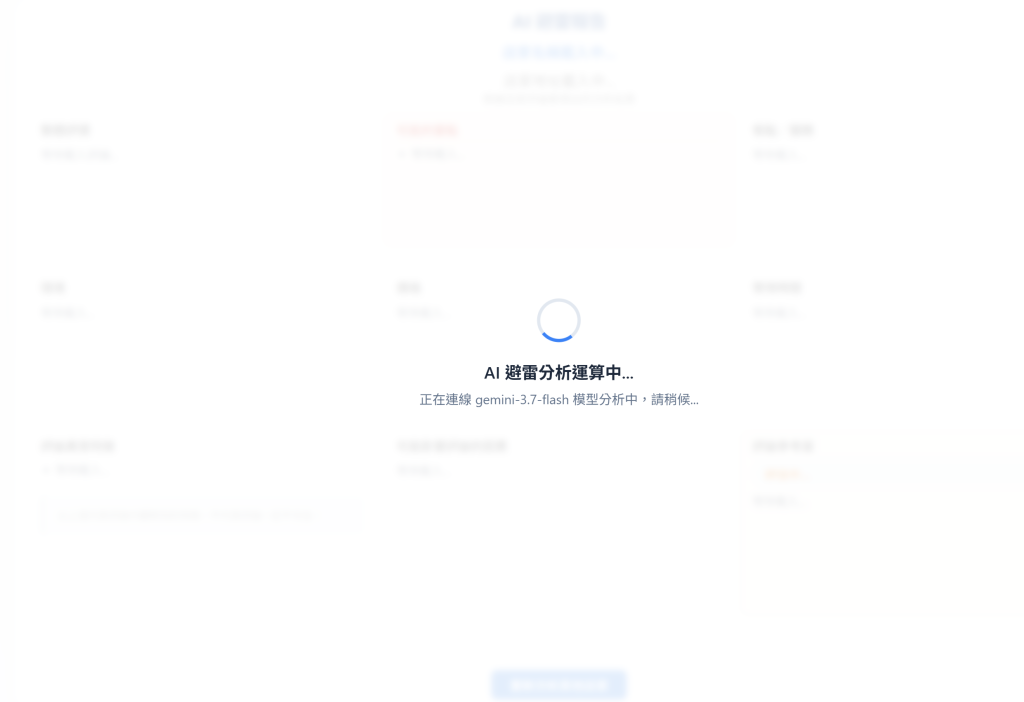
經過前面幾輪的修改與測試,終於看到 Gemini 成功回傳分析結果,並且將資料顯示在網站上。
Console 也能看到模型呼叫成功,以及後續處理報告的紀錄。
這次最開心的地方,是網站終於不再只是使用關鍵字計算評論,而是能將實際取得的評論交給 Gemini,讓 AI 根據內容進行整理與歸納。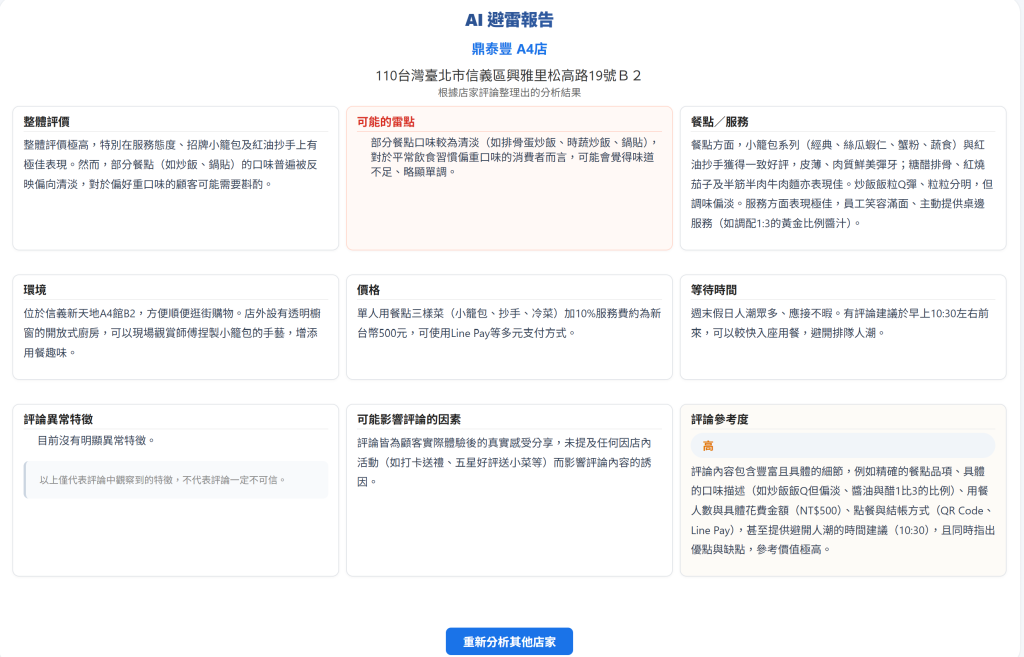
這些內容是讓 Gemini 根據輸入的評論進行整理,不代表 AI 的判斷一定正確。因此,後續還需要持續檢查分析結果是否符合原始評論,避免產生沒有根據的結論。
今天主要都在除錯,實際進度看起來好像沒有新增很多功能,但我覺得這些問題都很值得記錄。
原本以為串接 Gemini 只需要呼叫 API,再把回傳結果顯示在網頁上就好了。真正動手做之後,才發現中間還有很多細節需要處理。
像是評論計數的邏輯、API 回傳欄位、JSON 格式、模型服務錯誤,以及等待分析時的畫面狀態,每個地方都有可能影響最後的結果。
尤其是遇到錯誤時,如果沒有先檢查回傳內容和 Console 訊息,只是不斷修改程式碼,反而可能花更多時間。
今天也終於讓我看到,從取得 Google Maps 評論、整理 Prompt、呼叫 Gemini,到最後產生避雷報告,整個流程開始串接起來了。
接下來,我希望能繼續改善報告的呈現方式,看能不能跑快一點,今天跑了很久,也會測試不同店家和不同數量的評論,看看 AI 能不能穩定產生有參考價值的分析結果。
距離完成這個專案又前進了一步,明天繼續努力!

 iThome鐵人賽
 看影片追技術
看更多

