
現在的 AI 模型往往都具備有多模態的能力,不只可以讀取及回傳文字,通常也都可以接受照片、聲音等資訊。
而對於一個 Agent 來說,這項能力尤為重要,當我們想請它幫忙修改程式 bug 時,可能會需要附上幾張照片讓它理解情況,接下來三篇,我們就來加上照片讀取的功能吧!
先說一下我想達成的效果,我拖入了一張照片到終端,介面在底下顯示出我導入的照片檔名。
在這裡,我們不是真正把照片給 ollama API 看,而是給它路徑,讓它自己找。
難點在哪呢?你可以先試試看拖入一張照片到終端,會看到一段又臭又長的路徑,而這就是這個圖檔的路徑,我們需要過濾出這個路徑做清除並移到終端底部。
先提醒一下,本篇的內容是針對 macOS、Linux,
也就是說,你按照我這個做法在 Windows 上的特定檔名(檔名中出現空格或路徑被引號包住)是無法偵測到檔名做清除以及導入模型的。這裡稍微說一下如果你想在 Windows 上做適配大致上怎麼搞:
核心原因是 Windows 檔名遇到空格時不是像 macOS 用\做跳脫(晚點會說到是怎麼一回事),而是用引號包起,導致了目前的正則無法搜尋到。
所以最主要的就是要把正則對有引號的樣式做適配,且搜出來的內容要把引號給剝除。
先建立一個放提取出圖片路徑的串列,然後建立過濾用的函數,傳入的是使用者輸入:
這個函數的核心目的是「把圖片路徑部分提取出來並清除做回傳」。
# src/meowgent/cli/input_prompt.py
from ...

_attached_images: List[str] = [] # 圖片路徑暫存

...

def _extract_image_path(input: str) -> str:
    """
    過濾文字中是否有圖片
    """
使用者傳入了一堆的文字,像 請幫我看 /var/folders/wn/zd9cl3cx0jg0mf9pr_1wz9780000gn/T/TemporaryItems/NSIRD_screencaptureui_3msyGC/截圖 2026-09-29 下午5.25.27.png 這張圖...... 這樣,要如何有效率且準確的過濾出路徑呢?還記得在 Day 7 做過的**正則(Regex)**嗎?
先來看一下語法的部分:
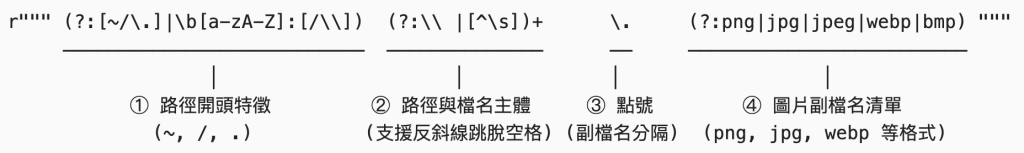
詳細語法部分這裡就不說了,順帶一提正則這種東西我通常直接叫 AI 幫我做生成,所以其實我也不是特別懂,哈哈!
由於要做非常多次搜尋,所以先做「預編譯」:
# src/meowgent/cli/input_prompt.py
from ...
import re
...
_attached_images = ...

RX_IMAGE_PATH = re.compile(
    r"""(?:[~/\.]|\b[a-zA-Z]:[/\\])(?:\\ |[^\s])+\.(?:png|jpg|jpeg|webp|bmp)""",
    flags=re.IGNORECASE # 忽略大小寫差異
) # 正則預編譯
...
有些時候副檔名可能會是大寫的,所以這裡設定
re.IGNORECASE來忽略大小寫。
用 re.findall() 去找出「所有匹配的項目」放入串列,而如果沒有匹配就回傳原始輸入。
# src/meowgent/cli/input_prompt.py
...
def _extract_image_path(...) -> ...:
	""" ... """

	matches: List[str] = RX_IMAGE_PATH.findall(input)

	if not matches: # 無任何匹配
        return input
如果找到路徑了,首先我們要把它轉為 Path 物件(因為等等要用 is_file()),而在轉物件前,我們先在字串的狀態下解決 macOS 的跳脫字元狀況。
假設我有一張路徑如下的截圖:
/var/folders/wn/zd9cl3cx0jg0mf9pr_1wz9780000gn/T/TemporaryItems/NSIRD_screencaptureui_3msyGC/截圖 2026-09-29 下午5.25.27.png看到最後
截圖 2026-09-29 下午5.25.27.png的部分,有兩個地方有「空格」。而被讀取後會變為
請幫我看 /.../截圖\ 2026-09-29\ 下午5.25.27.png 這張圖有注意到嗎?空格的地方前面都加上了「反斜線\」,這是 macOS / Linux 終端機拖曳檔案時的特殊產物。
會自動做這樣的處理是因為輸入 shell 指令時,通常會把空格當作「分開不同的指令或參數」的訊號,而終端機為了怕把檔名切斷,在幫你自動貼上路徑時,會偷偷在那個空格前面塞一個反斜線\作為跳脫字元。而要處理是因為跳脫字元會使得檔名不正確,也就讓
is_file()沒辦法辨識到。
接著轉 Path 物件,並用 .expanduser()、resolve() 把路徑做整理:
# src/meowgent/cli/input_prompt.py
...
def _extract_image_path(...) -> ...:
	...

	for row_path in matches:

        path = Path(row_path.replace(r"\ ", " ")).expanduser().resolve()
然後判斷「檔案是否存在」,檔案不存在時就當作使用者只是打了一個「像圖檔的文字」,不去做處理,
而如果存在,要把原始路徑 row_path 替換成空字串,也就是把這個路徑刪掉。
# src/meowgent/cli/input_prompt.py
...
def _extract_image_path(...) -> ...:
	...
	for ...:
		...

		if path.is_file():

            input = input.replace(row_path, "") # 把路徑在文字中刪除
而因為傳入的 input 會是整段的(不會因為剛剛有搜尋過前面的就不重複搜尋),所以要確定在暫存中此圖檔沒有被存過,來防止重複導入相同圖片,
最後就可以把處理完的文字回傳了。
# src/meowgent/cli/input_prompt.py
...
def _extract_image_path(...) -> ...:
	...
	for ...:
		...

		if ...:
			...

			if str(path) not in _attached_images:

                _attached_images.append(str(path)) # 加入暫存

    return input.strip() # 清掉殘留的空格
get_input()這裡,我們在
get_input()中新增了很多內容,而且還是穿插在舊程式之中的,所以我這裡直接當作寫一個新的get_input()來整個重講。
前面有說過,我們會在終端底下提供一個欄位來顯示已加入的照片,首先,我們就先做一個函數來「拼接」輸入的照片提示:
要注意的是,這個函數的作用僅是「拼接出要顯示的字串」而已,不是做輸出。
# src/meowgent/cli/input_prompt.py
from ...
from typing import ..., Tuple
...
def get_input() -> Tuple[str, List[str]]:
	""" 獲取用戶輸入 """

	def _get_image_toolbar_text():
        """ 獲得加入照片的文字提示 """
        if not _attached_images:
            return None

        text = ",".join([f"{Path(p).name}" for p in _attached_images])

        return f"已附加圖片:{text}"
開始下面內容前,我們先大致了解一下到底是要如何把文字更新上畫面,這裡要說到兩個概念,**buffer(文字緩衝區)**以及 on_text_changed(文字變更事件):
當我們用 prompt toolkit 的 prompt() 收集用戶輸入時,函數會回傳 buffer.text 的內容(用戶輸入),
而前面做的 _extract_image_path() 就是拿來得到要變更的內容,所以我們要把 buffer.text 傳入 _extract_image_path() 檢查看看是否需要更改,最後再放回 buffer.text,
可以理解為「在輸入運算的途中,先把這段文字劫走,拿去做了修改,最後再放回去」。
那要怎麼判斷什麼時候要觸發來檢查是否要修改文字呢?這時就要用到 on_text_changed 的概念了,可以簡單理解為一個「偵測使用者輸入的機制」,
只要先把它和清理用函數(晚點要做的 _on_text_change)掛載上去,當緩衝區 buffer.text 出現「任何變動」,就可以觸發這個清理函數做清理(裡面包含了 _extract_image_path() 以及其他部分邏輯)。
它要做的事有:
_extract_image_path()。_extract_image_path() 被重複呼叫。buffer.text。這邊看不懂什麼意思沒關係,等等馬上講。
首先,我們先新增兩個全域變數,函數內用 global 宣告修改:
# src/meowgent/cli/input_prompt.py
from ...
from prompt_toolkit.buffer import Buffer
...
RX_IMAGE_PATH = ...

is_updating_input = False

just_extracted = False

...

def get_input() -> ...:
	...

	def _on_text_change(buffer: Buffer):
        """ 清理輸入顯示圖片路徑 """
        global is_updating_input, just_extracted
Buffer 物件裡面有
buffer.text以及 on_text_changed 機制的設定。
那為什麼會被「重複呼叫」呢?
有兩種狀況,分別對應到 is_updating_input 及 just_extracted:
_extract_image_path() 修改完送回 buffer.text 時又會再次觸發 on_text_changed 機制(因為輸入變了),這樣會導致只要做一次修改都會再有一次無意義的檢查。_extract_image_path() 做修改,而「改完後終端才把空格補上」,導致又觸發一次 on_text_changed。無意義的檢查只是在效能上會有些許差距,但空格的部分確實在使用者體驗上造成了困擾。
所以,當要開始修改時,要把這兩個全域變數改為 True,並在函數進到修改邏輯前做出攔截。
這就是第一點的攔截部分(直接結束函數),一進到函數先檢查,如果 is_updating_input 為 True(表示這個修改是程式碼造成的不需要檢查):
# src/meowgent/cli/input_prompt.py
def get_input() -> ...:
	...
	def _on_text_change(...):
		...

		if is_updating_input:
            return
然後,就可以調用 _extract_image_path() 了:
# src/meowgent/cli/input_prompt.py
def get_input() -> ...:
	...
	def _on_text_change(...):
		...

		clean_text = _extract_image_path(buffer.text)
這邊就是第二點的攔截,偵測到剛改完補空格時,把「右方」空格清掉,接著狀態改回 False:
# src/meowgent/cli/input_prompt.py
def get_input() -> ...:
	...
	def _on_text_change(...):
		...

		if just_extracted:

            clean_text = clean_text.rstrip()

            just_extracted = False
進入到修改的邏輯,首先先檢查 _extract_image_path() 的內容有沒有變動(跟原始 buffer.text 相同就沒必要改了),然後把兩個全域變數改為 True,
這邊用 try...finally 是因為要防止 buffer.text = clean_text 出錯沒有把 is_updating_input 恢復。
# src/meowgent/cli/input_prompt.py
def get_input() -> ...:
	...
	def _on_text_change(...):
		...

		if clean_text != buffer.text: # 防止內容一樣(白改了)

            is_updating_input = True # 開始修改了,不要再觸發自己

            just_extracted = True # 不要觸發空格

            try:
                buffer.text = clean_text

            finally:
                is_updating_input = False
這邊跟之前不同的地方有以下幾點:
completer 的部分之前是在 prompt 才傳入,現在改到 PromptSession 物件建立時傳入(效果其實都一樣)。PromptSession() 加入 bottom_toolbar 參數,把前面做的 _get_image_toolbar_text() 傳入。_prompt_session.default_buffer.on_text_changed += _on_text_change 掛載 _on_text_change()(不是用 = 而是用 +=,想像把清理函數**「附加上去」不是「賦值」**)。# src/meowgent/cli/input_prompt.py
def get_input() -> ...:
...
global _prompt_session
if _prompt_session is None:
completer = WordCompleter(words=COMMANDS, ignore_case=True, WORD=True)
# 建立補全器
_prompt_session = PromptSession(
style=Style.from_dict({
"": "ansiblue"
}),
completer=completer,
bottom_toolbar=_get_image_toolbar_text
) # 歷史輸入管理,如果已經建立過,不再建立
_prompt_session.default_buffer.on_text_changed += _on_text_change
# 掛載清理函數
user_input = _prompt_session.prompt("> ").strip()
用淺拷貝的方式複製一份暫存圖串列(因為我們要把 _attached_images 做清除,不能讓記憶體空間和 images 有連結),
然後我們在沒有使用者輸入(只有圖片)的狀態下,寫入 prompt,最後就可以回傳了:
# src/meowgent/cli/input_prompt.py
def get_input() -> ...:
	...

	images = list(_attached_images) # 淺拷貝複製
	_attached_images.clear()

    if not user_input and images: # 只有圖片,沒文字
        user_input = "根據上下文內容處理圖片"

    return user_input, images
這樣一來基本的傳入圖片就搞定啦!
明天,我們正式讓圖片可以傳入模型,然後加上幾個小功能吧!


 iThome鐵人賽
 看影片追技術