
昨天有提到 Merge Sort 和 Quick Sort 的取捨,結論是兩個各有好壞。其實 Bubble、Selection、Insertion、Merge、Quick 這五個演算法都是如此,沒有一個適用所有情況。
那實際拿到一批資料時,要怎麼決定用哪一個呢?昨天最後那張表把五個排序的 Best、Average、Worst Case 和額外空間都列了出來,但單純依據那張表格判斷似乎不太夠。它能告訴我們 Merge Sort 的最壞情況比 Quick Sort 好,卻分不出兩者在平均情況下的差別,也看不出「同分的資料會不會被打亂」這種不在複雜度裡的性質。今天要介紹的就是那些表格沒有列到的特質~
複習一下,昨天那張表長這樣:
| 演算法 | Best Case | Average Case | Worst Case | 額外空間 |
|---|---|---|---|---|
| Selection Sort | N²/2 |
N²/2 |
N²/2 |
O(1) |
| Bubble Sort(加 early exit) | N |
3N²/4 |
N² |
O(1) |
| Insertion Sort | N |
N²/2 |
N² |
O(1) |
| Merge Sort | N log₂N |
N log₂N |
N log₂N |
O(N) |
| Quick Sort | N log₂N |
N log₂N |
N²/2 |
O(log N)~O(N) |
先從表格中容易被誤解的地方開始看。Merge Sort 和 Quick Sort 的 Average Case 都是 N log₂N,但實際跑起來通常不會一樣快。因為 Big O 只描述成長趨勢,但被省略的常數沒有真的消失,實際的執行時間比較接近這個形狀:
T(N) = C × N log N
N log N 是兩者共有的部分,差別在 C。這個 C 是每一步真正要做的事:要比較幾次、要搬動幾次資料、要不要另外配置記憶體。以昨天講過的差別來說,Quick Sort 全程在同一個陣列上交換,沒有配置新陣列,也沒有把資料搬進搬出;Merge Sort 每一層合併都要建一個新的 result,再把兩段的元素逐一推進去,合併完再回傳。同樣是 N log N 這麼多次比較,後者每一次都附帶更多工作。
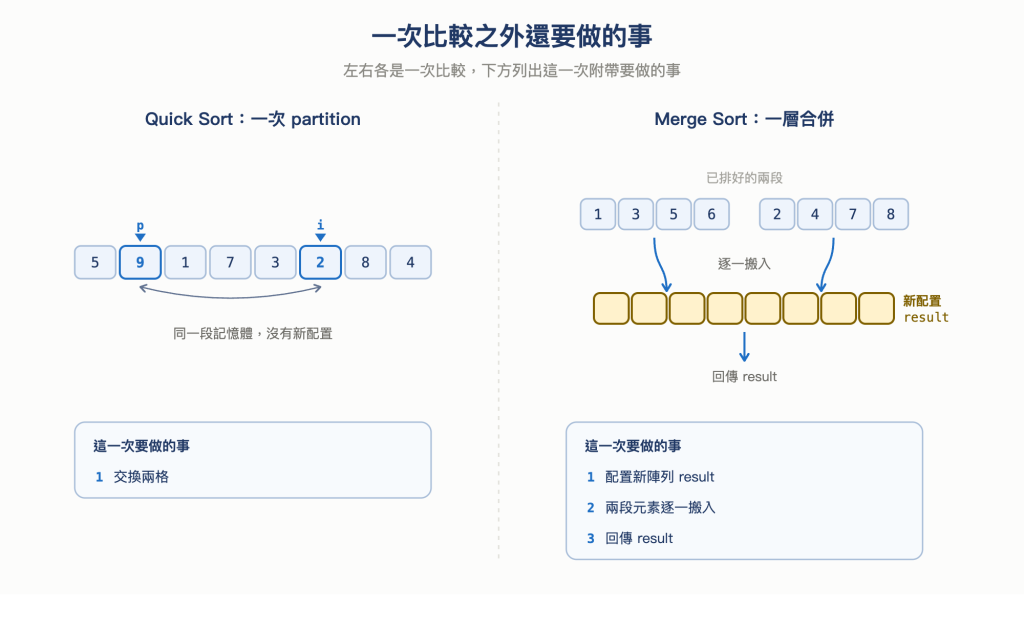
圖 1 一次比較之外還要做的事
C 還有一個來源不在程式碼裡。Day 05 量過一張 4096 × 4096 的表格,逐列相加和逐行相加的加法次數完全一樣,時間卻差了好幾倍,原因是連續存取的成本比跳著存取低。排序也會有類似狀況,一個從頭掃到尾的線性掃描,和一個在陣列裡跳來跳去的存取模式,就算比較次數相同,實際花掉的時間可能也有差。
因此複雜度相同只代表成長趨勢相同,想在同一格裡分出細部差異,得看別的東西。
那要看什麼呢?其實前面已經陸續提過 stable、in-place、adaptive 這三個,只是散在各篇裡,今天把它們並排起來看~
第一個是 Day 16 講過的穩定性 (Stability),指的是排序之後鍵值相同的元素之間,仍然維持它們在原本輸入裡的相對順序。它之所以重要,是因為它決定了「先按時間排,再按分數排」這種兩段式的做法能不能成立。
Day 16 已經確認 Merge Sort 是穩定的,昨天也說明了 Quick Sort 不是,原因在收尾那次交換會把元素整段丟過去。那前面三個 O(N²) 的排序呢?
Bubble Sort 和 Insertion Sort 都是穩定的。Bubble Sort 只在 arr[i] > arr[i + 1] 的時候交換相鄰兩格,兩個相等的元素不會滿足這個條件,所以永遠不會互換位置;Insertion Sort 的 while 條件是 arr[j] > current,往左遇到相等就停下來,current 會插在那個相等元素的右邊,順序也保住了。兩者的共同點是每一次移動都只跨過一格,而且跨過去的一定是嚴格比較大的元素。Selection Sort 就不是這樣了。
用 Day 16 那份評論清單來看。清單本來照時間排好,A 最早、H 最新:
const comments = [
  { score: 90, id: 'A' },
  { score: 70, id: 'B' },
  { score: 90, id: 'C' },
  { score: 70, id: 'D' },
  { score: 80, id: 'E' },
  { score: 90, id: 'F' },
  { score: 70, id: 'G' },
  { score: 80, id: 'H' },
];
把 Day 14 那支 selectionSort 的比較條件換成 arr[j].score < arr[minIndex].score,排完之後是這樣:
70B 70D 70G 80E 80H 90F 90C 90A
同一份清單交給 Bubble Sort 或 Insertion Sort,得到的則是 70B 70D 70G 80E 80H 90A 90C 90F,三組同分都維持了原本的時間順序。Selection Sort 卻把 90 那組從 A C F 變成了 F C A。
Selection Sort 問題出在哪呢?出在每一輪結束時的那次交換,它先在剩下的範圍裡找到最小值,再把它和目前這一格對調,而這兩格中間可能隔了大半個陣列。以第二輪為例,這時候陣列是 70B 90A 90C 70D 80E 90F 70G 80H,i 停在 index 1,最小值 70D 在 index 3,交換之後 90A 被丟到 index 3,等於整段跨過了 90C:
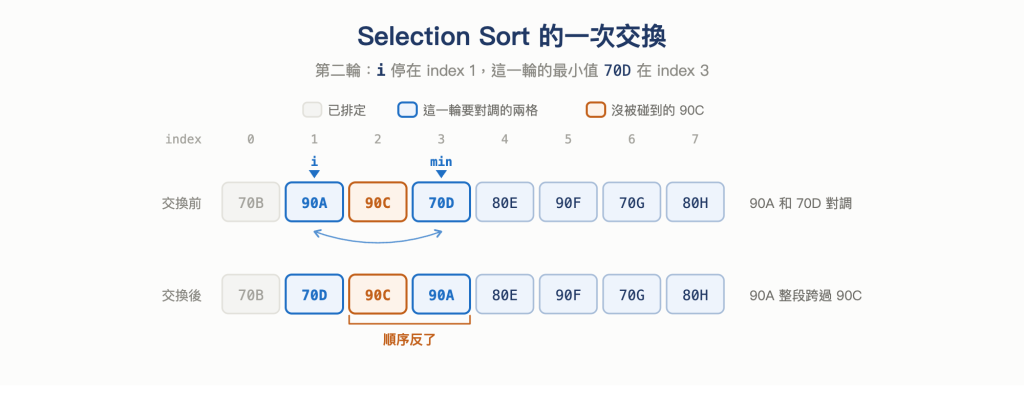
圖 2 Selection Sort 的一次交換跨越多格
被換走的那一格原本站著誰、中途跨過了誰,完全由資料長什麼樣決定,因此相同鍵值之間的相對順序沒有任何保證。這和昨天 Quick Sort 收尾那次交換是相同狀況,只要一次交換跨過的距離不只一格,穩定性就無法保證。
原地排序 (in-place sort) 是 Day 14 就出現的說法,指排序直接在原本的陣列上進行,不必另外開一個和輸入等比例的空間。這裡沿用昨天提過的那句話:原地不等於額外空間 O(1),Quick Sort 是原地排序,但遞迴的 call stack 從 O(log N) 到 O(N) 都是真實的記憶體成本。五個排序裡只有 Merge Sort 不是原地的,它的 O(N) 來自每次合併都要一個新陣列裝結果。
adaptive 是 Day 15 認識的性質,指成本會隨著輸入本身的凌亂程度而改變。放進選擇框架的時候,它要問的是:如果拿到的資料已經接近排好了,這個排序演算法認得出來嗎?
Insertion Sort 認得出來,資料越接近排好它要做的工作就越少;Selection Sort 認不出來,三種情況都要從頭到尾掃描;Bubble Sort 加了 early exit 之後認得出「完全排好」,卻認不出「幾乎排好」;Merge Sort 和 Quick Sort 也都不是 adaptive 的,資料再整齊也一樣拆到底。
上面三個性質是演算法本身的特性,但選擇演算法時,還有另外一半的因素來自資料本身。
Big O 描述的是 N 變大時的成長趨勢,這句話反過來說就是,N 很小的時候它幾乎沒有參考價值,而 O(N²) 之所以會比 O(N log N) 慢,前提是 N 大到讓成長率的差距蓋過常數的差距;而在 N 只有十幾二十的時候,一個沒有遞迴、沒有配置新陣列、只有一層 while 迴圈的 Insertion Sort,通常反而比要一路拆到底再合併回來的 Merge Sort 快。
同一個排序演算法拿到不同形狀的輸入,成本可以差一個級距。資料接近排好的時候,adaptive 特質就變得關鍵,Insertion Sort 在這種輸入下接近 O(N);Quick Sort 剛好相反,昨天看過在固定挑最後一格當 pivot 的寫法下,已經排好的輸入正好是它的 Worst Case。
另外,大量重複的鍵值也要留意。這種資料本身不難排,難的是排完之後同鍵值的那幾筆會落成什麼順序,而這正是穩定性在管的事。重複的元素少,不穩定的排序最多打亂零星幾筆;重複的元素多,被牽動的範圍就跟著放大。以前面那份評論清單為例,8 筆資料分成 3 組同分、沒有任何一筆是落單的,這種形狀下只要換成不穩定的排序,整份清單就沒有哪一筆的相對順序是有保證的。
前面五個排序都靠兩兩比較來決定順序,所以只要定義得出比較規則,字串、日期、物件都可以排序。但如果要排的剛好是範圍有限的整數,例如一批 0 到 100 的分數,那還有另一個選擇:Counting Sort 和 Radix Sort,這兩種方法不靠元素兩兩相比,而是直接利用鍵值本身的結構,像是「值是多少就記在第幾格」或「先看個位數、再看十位數」。因為省掉了比較這一步,它們的成本不再是 O(N log N) 這個樣子:Counting Sort 的最壞情況是 O(N + k),k 是鍵值的範圍;Radix Sort 是 O(d × N),d 是鍵值有幾位數。兩者對 N 都是線性的,換來的條件是多了一個和資料內容有關的參數,只限於鍵值結構夠規則的時候才能使用。
把 Stable 和 Adaptive 兩欄一起放進前面那張表如下:
| 演算法 | Best Case | Average Case | Worst Case | 額外空間 | Stable | Adaptive |
|---|---|---|---|---|---|---|
| Selection Sort | N²/2 |
N²/2 |
N²/2 |
O(1) |
否 | 否 |
| Bubble Sort(加 early exit) | N |
3N²/4 |
N² |
O(1) |
是 | 部分 |
| Insertion Sort | N |
N²/2 |
N² |
O(1) |
是 | 是 |
| Merge Sort | N log₂N |
N log₂N |
N log₂N |
O(N) |
是 | 否 |
| Quick Sort | N log₂N |
N log₂N |
N²/2 |
O(log N)~O(N) |
否 | 否 |
有了這張表,選擇排序法時,我們可以問幾個問題:
O(1)
O(N log N)
O(N) 會是問題,要改用原地排序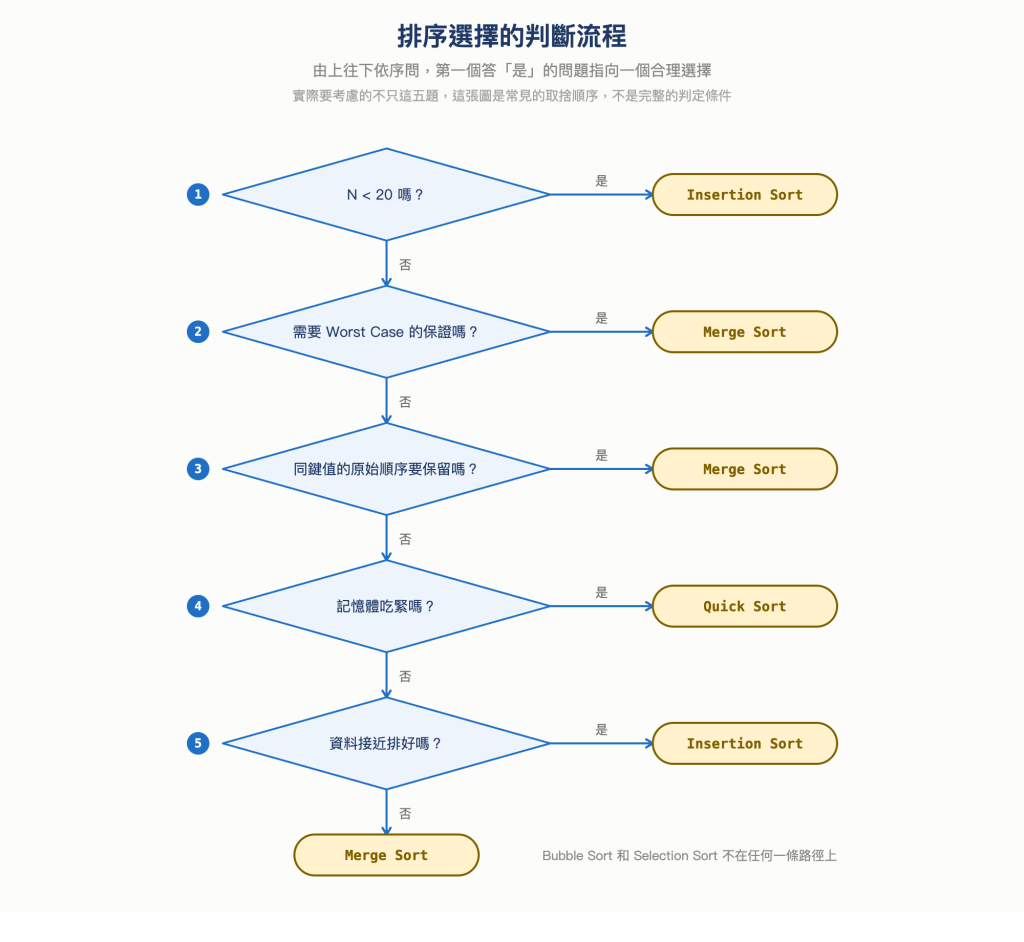
圖 3 排序選擇的判斷流程(參考用,不是唯一解)
從問題中可發現,Bubble Sort 和 Selection Sort 從頭到尾都沒有被選中,因為它們在這五題關心的欄位上都拿不出優勢。Bubble Sort 每一欄都沒有比 Insertion Sort 好,兩者的額外空間同樣是 O(1),但它的 Average Case 是 3N²/4,比 Insertion Sort 的 N²/2 多了一半,而且只認得出完全排好的輸入;Selection Sort 則只有最壞情況那一欄的步數比較少,可是它既不穩定也不 adaptive,而這兩項在前面五個問題裡都被問到了。
不過這五個問題其實還少考量一點,它們問的都是時間、空間和順序,沒有問「搬動一筆資料要付多少成本」。Day 14 數過交換次數,Selection Sort 掃完一整輪只在最後動手一次,上限鎖在 N - 1;Bubble Sort 靠交換推進,一個元素離目標多遠就得換上幾次。排幾個整數看不出這個差別,但如果每一筆是很大的物件、或資料放在寫入成本高的地方,搬移次數就會變成決定性的要素,而 Selection Sort 那個鎖在 N - 1 的上限,就成了它少數會被選中的理由。
接下來看一些情境題,以下只是建議的可能選法,不代表完全正確的標準答案><
資料量只有 10 筆,第 1 題就決定了答案,選 Insertion Sort。這裡真正的判準是 N 小到讓常數的差距蓋過成長率的差距,因此一個迴圈就寫完、額外空間 O(1) 的做法反而最有利,後面幾題都不必問了。
使用者帳號是依照註冊時間存下來的,名稱本身沒有任何既有順序可以利用,而名冊又要一次產生完整的輸出。資料量這麼大、也沒有順序可利用,這時第 2 題變成關鍵。Quick Sort 的平均表現不錯,可是資料一大,萬一踩到 Worst Case,O(N²) 的代價也跟著被放大。想要一個不管拿到什麼輸入都不會超過 O(N log N) 的保證,就選 Merge Sort,代價是那份 O(N) 的額外空間,前提是記憶體放得下。而如果 2,000 萬筆再往上翻幾倍、一次放不進記憶體,那就不是在這五個排序之間選了。做法會變成先把資料切成好幾批、每一批都小到放得進記憶體,各自排好之後寫回硬碟,最後再用 Day 16 那個 merge 的方式,把這些已經排好的批次合成一份完整的結果。這種排序叫做 external sort,它要解的問題已經不是「挑哪一個排序演算法」,而是「資料放不進記憶體的時候怎麼排」。
前面那份評論清單已經照時間排好,A 最早、H 最新,現在要改成照分數由低到高排,而且希望同分的那幾筆維持原本的時間順序。這時候前兩題都不是重點,第 3 題直接把 Selection Sort 和 Quick Sort 刷掉,剩下的三個都可以,再依資料量和記憶體條件決定。
不過這有個前提,兩段式排序並不是唯一的解法,也可以寫一個一次比兩個欄位的比較函式,分數不同時比分數,分數相同時再比時間,這樣就不依賴穩定性了。兩種做法實務上都有人用,選前者的前提就是排序必須穩定。
比分是數字,所以第一個念頭可能是用 Counting Sort 或 Radix Sort,但比分的範圍其實不好界定,籃球和棒球差一個級距,加時賽還能再往上疊,鍵值的上下界不確定的話,這條路就無法走了。
那回到五個排序來看呢?資料量大、分布也隨機,看起來和情境二一樣,差別在第 4 題:同一天有大量球賽在跑,每一場的比分又一直在變,所以這份排行不是排一次就結束,而是每次更新都要重排一遍。如果每排一次都要多要一份和資料等長的空間,這筆開銷就會一再重複付出。因此這裡會選 Quick Sort 而不是 Merge Sort,並且搭配隨機或三數取中的 pivot 來壓低踩到 Worst Case 的機率。
前面談的都是自己寫排序時的選擇,但實際在寫 JavaScript 時,多數情況會直接用 Array.prototype.sort。那它到底用了哪個排序演算法呢?
先看一個可能讓人困惑的範例:
[10, 9, 100].sort(); // [10, 100, 9]
[1, 5, 25, 40, 100, 9].sort(); // [1, 100, 25, 40, 5, 9]
一批數字排完之後順序看起來是亂的。原因在規格裡有寫,沒有傳比較函式的時候,兩個元素會先各自轉成字串,再用字串的大小關係決定順序:
Let xString be ? ToString(x).
Let yString be ? ToString(y).
Let xSmaller be ! IsLessThan(xString, yString, true).
也就是說,10 會變成 "10"、9 會變成 "9",而字串是一個字元一個字元比的,"1" 排在 "9" 前面,因此 10 就跑到 9 前面去了。
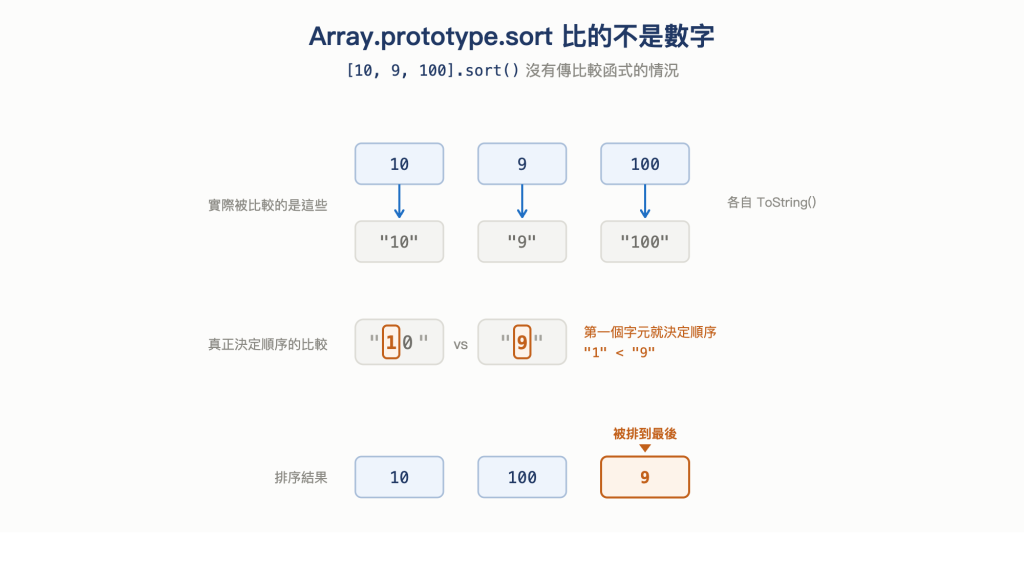
圖 4 Array.prototype.sort 比的不是數字
解法是自己傳入比較規則:
[10, 9, 100].sort((a, b) => a - b); // [9, 10, 100]
比較函式回傳負數代表 a 排在前面,正數代表 b 排在前面,回傳 0 代表兩者等價。對照前面談的維度,這個函式負責的是「鍵值怎麼定義」,至於實際用哪個排序演算法,取決於引擎實作。
規格另外還定義了兩件容易被忽略的事,Array.prototype.sort 底下有一段 note 直接寫著:
Because non-existent property values always compare greater than undefined property values ⋯ undefined property values always sort to the end of the result, followed by non-existent property values.
也就是 undefined 永遠比其他值大,不管比較函式怎麼寫都會被排到最後面,而陣列裡的空洞又排在 undefined 後面。至於比較函式會不會拿到 undefined,答案是不會,因為那三個判斷(兩邊都是 undefined、只有 x 是、只有 y 是)都寫在呼叫比較函式那一步的前面,所以寫比較函式時不必多做判斷。
ECMAScript 對 sort 的要求分成兩層。第一層是結果必須滿足的條件,其中一條就是穩定性,規格用一個排列函式 π 把它寫成:若 j < k 而且兩者的比較結果為 0,則排完之後 π(j) < π(k),並在後面直接註明 i.e., the sort is stable。所以在 JavaScript 裡,sort 是穩定排序這件事由規格保證,不是引擎自己的實作細節。
第二層是怎麼做到。規格在這裡只寫了一句 Sort items using an implementation-defined sequence of calls to sortCompare,也就是用哪個排序演算法完全交給實作決定。這代表同一段程式在不同引擎、甚至同一個引擎的不同版本裡,走的可能是不一樣的演算法,只要結果符合第一層的條件就合法。
不過第一層那些保證有個前提,就是比較函式本身必須是一致的 (consistent comparator):同一組 a 和 b 每次呼叫都要回傳同樣的結果、不能回傳 NaN,而且要滿足自反性(a 和自己比要算相等)、對稱性(a 和 b 誰在前面,反過來問要得到一致的答案)與傳遞性(a 排在 b 前面、b 排在 c 前面,就要有 a 排在 c 前面)。這幾條對我來說有點眼熟,因為之前讀 Functional Programming 時見過,Eq 的三大法則列的就是自反、對稱、傳遞,而Ord再往上一層,管的是「排得出先後」。規格要的其實就是這兩件事合起來:比較函式真的把資料切成一組一組彼此相等的類別,而且這些類別之間排得出唯一的先後,排序這件事才有意義。一旦比較函式不一致,例如寫成 () => Math.random() - 0.5 想拿來洗牌,規格就直接把排序結果交還給實作決定,連穩定性的保證也一起失效。
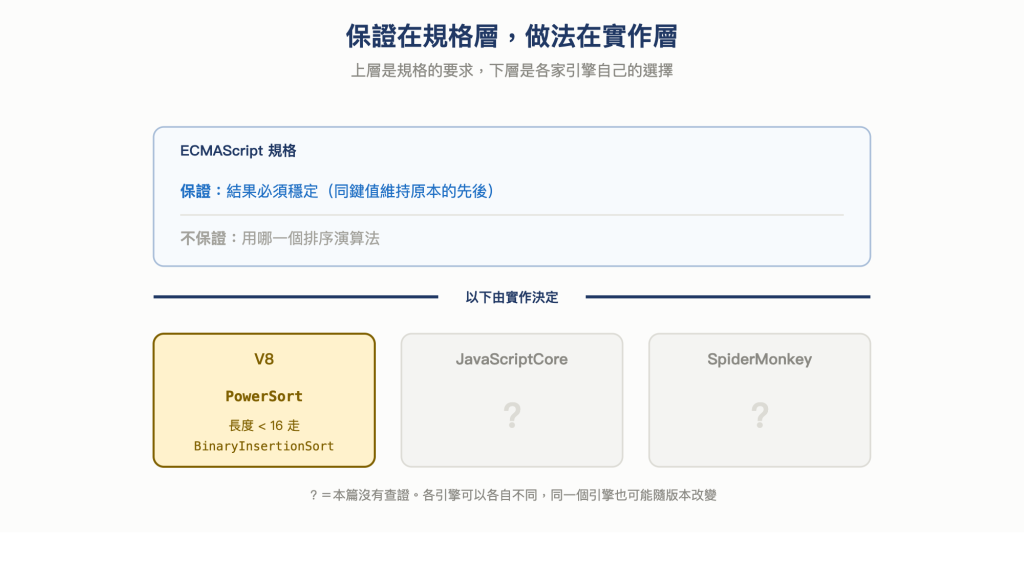
圖 5 規格只保證結果穩定,用哪個演算法屬於實作層,各引擎可以不同
那實作長什麼樣子呢?以 V8 為例,截至 2026-10-02 的 main 分支,排序的主體寫在 third_party/v8/builtins/array-sort.tq,用的是 PowerSort,原始碼的註解自己描述成 a stable, adaptive merge sort variant,實作是從 CPython 移植過來的。用一句話說,它做的事情是:先把陣列裡本來就已經排好的段落找出來,再決定要用什麼順序把這些段落合併起來。
為什麼要先找已經排好的段落呢?因為真實的資料很少是完全隨機的,一份剛匯進來的資料可能有一整段本來就照時間排好,一份更新過的清單也多半只有幾筆的位置不對。Merge Sort 固定對半切,等於完全不看資料長什麼樣,再整齊的輸入也照樣拆到底。PowerSort 則是反過來,先看資料本身給了多少現成的順序。
拿這個 10 格的陣列走一次(這裡只是用來說明概念,實際上這麼短的陣列在 V8 不會走這條路,後面會提到):
[3, 5, 9, 8, 6, 2, 4, 7, 10, 11]
第一步是用 CountAndMakeRun 從左往右掃,把天然就排好的段落切出來,原始碼把這種段落叫做 run:
3 開始,3 <= 5 <= 9,到 9 遇上 8 就停,第一個 run 是 [3, 5, 9]
8 開始,8 > 6 > 2,到 2 遇上 4 就停,第二個 run 是 [8, 6, 2]
4 開始,4 <= 7 <= 10 <= 11 一路到底,第三個 run 是 [4, 7, 10, 11]
第二個 run 是由大到小的。這種段落同樣帶著「已經排好」的資訊,當成沒排過重來很浪費,但合併那一步只吃由小到大的段落,所以它會先被整段反轉成 [2, 6, 8] 再交給合併。反轉的成本就是這個 run 自己的長度,把它的頭尾兩格對調、再往中間收一格繼續對調,走一遍就換完了。
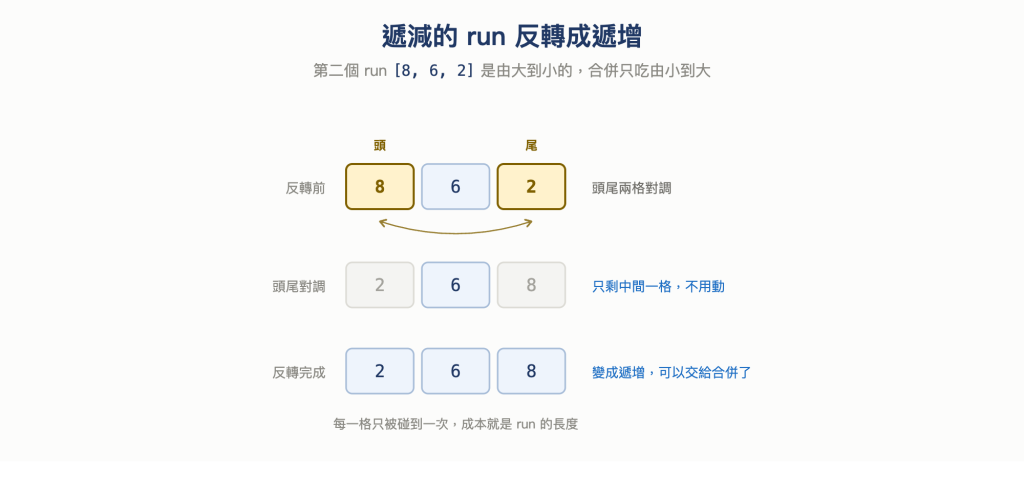
圖 6 遞減的 run 反轉成遞增,頭尾對調再往中間收,走一遍就換完
反轉會把段落裡所有元素的先後全部顛倒,這時穩定性就有風險了:萬一段落裡有兩筆相等的元素,反轉之後它們的先後會跟原本相反。V8 的解法藏在兩種 run 的認定標準裡,遞增只要相鄰兩格是 a[i] <= a[i + 1] 就算、允許相等;遞減卻要求嚴格的 a[i] > a[i + 1]、不允許相等。嚴格遞減等於保證這一段裡根本沒有相等的元素可以被顛倒,反轉就安全了。所以前面那個 run 切在 [8, 6, 2] 而不是更長,也是同一個規則的結果。
三個 run 都變成遞增後,接下來的問題是先合併哪兩個。Merge Sort 沒有這個困擾,它每次合併的對象一定是同一段對半切出來的左右兩半,沒有第三個候選可以挑。PowerSort 切出來的則是長度不一的 run,同一時間可能有好幾段排隊等著合併,才需要決定順序,而它決定的依據是每個 run 在陣列裡的位置和長度(原始碼裡的 NodePower),目標是讓合併的總成本盡量低。
以這個例子來說,三個 run 合併兩次就結束:先把 [3, 5, 9] 和 [2, 6, 8] 合成 [2, 3, 5, 6, 8, 9],再和 [4, 7, 10, 11] 合成 [2, 3, 4, 5, 6, 7, 8, 9, 10, 11]。同樣是這 10 格資料,Merge Sort 沒有 run 可以利用,得一路拆到單一元素再合回來,要走 4 層。PowerSort 要合併幾層、每一層合併哪幾段,是跟著資料本身的 run 走的;Merge Sort 則不管拿到什麼資料,都是固定對半切。
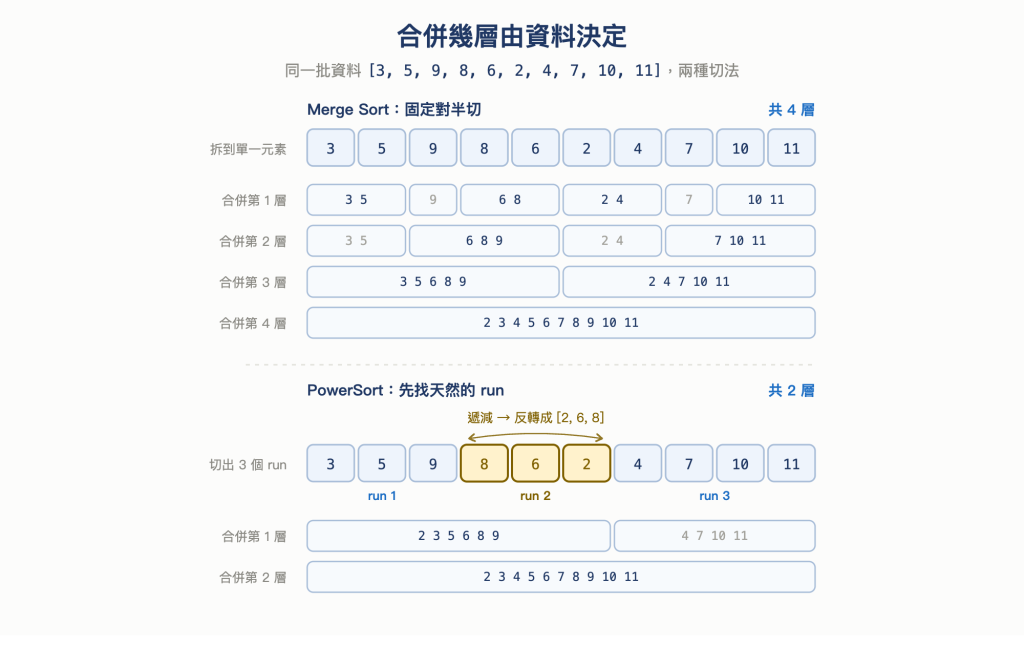
圖 7 同一批資料,兩種切法的合併層數
小陣列走的則是另一條路。V8 有一個常數 kMaxInlineSortLength,定義在 src/objects/js-array.h,值是 16,長度小於 16 的陣列直接用 binary insertion sort 排完,不進 PowerSort 的主流程。這正好是前面「N 小的時候常數才是重點」那件事的實例,而且這裡是一個具體的數字。
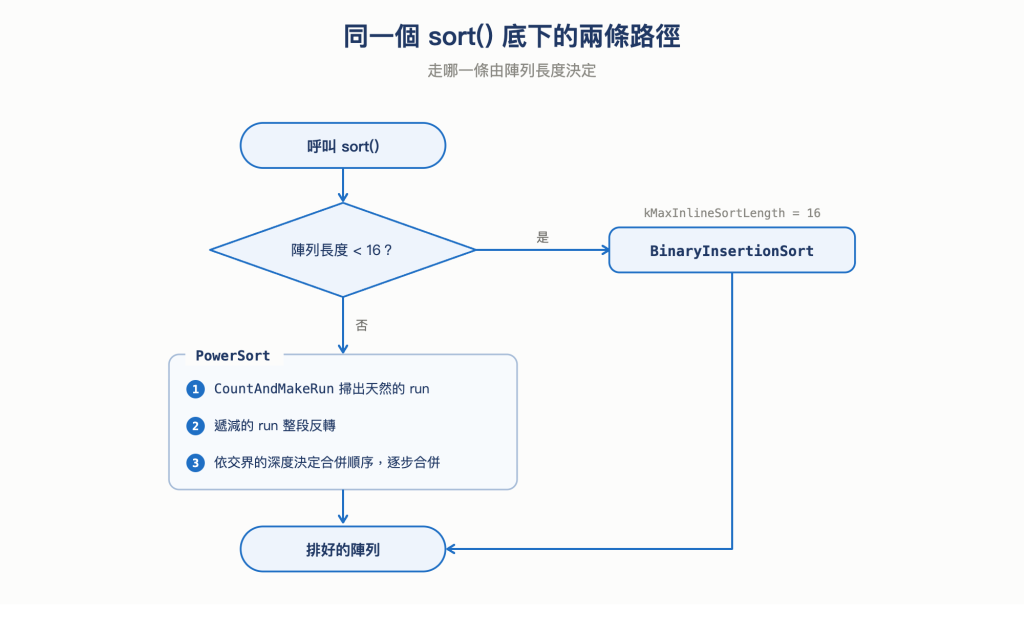
圖 8 V8 依陣列長度分成兩條路徑
這裡簡單解釋大致流程,實際上的邏輯複雜許多,有興趣可以再看看原始碼~(我也沒有完全理解全部細節><)
另外,上述這段隨時可能因為版本而改變,其他引擎也不保證用同一套實作方式。
小小總結一下今天對排序演算法選擇的認識~
O(N) 的額外空間;Quick Sort 省下那份空間,就失去了保證;Insertion Sort 在少量和接近排好的資料上很強,資料一大就不行了。sort 差在哪? 教科書講的是一個演算法本身的性質,內建實作除此之外還要處理規格上的保證、沒有比較函式時的型別轉換、以及各種輸入形狀下的工程細節,因此它通常不會只是單一一個演算法,而是好幾條路徑組合起來的。實際使用時,還可以記住幾件事~
sort() 不傳比較函式時是把元素轉成字串比較,排數字一定要自己傳比較函式圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。
third_party/v8/builtins/array-sort.tq
src/objects/js-array.h


 iThome鐵人賽
 看影片追技術