
今天要介紹的是 Tree~
排序的部分告一段落,目前為止介紹的資料結構有個共同點:不管是 Array、Linked List,還是後來的 Stack 與 Queue,資料都排成一條線,每個元素最多只有一個「下一個」。這種一條線的結構很好理解、也好實作,一個迴圈從頭跑到尾就走完了,但真實世界的資料不是全部都是線性的,以電腦的檔案系統來說,一個資料夾裡可以放好幾個子資料夾,每個子資料夾底下又可以再放好幾個資料夾;又或者是臉書貼文,一則貼文下面有好幾則留言,每則留言底下還可以繼續有留言。這些關係很難只用「下一個」講清楚,因為一個東西底下可以同時有好幾個東西。
Day 13 有大概提過,當時介紹遞迴有舉一個巢狀資料夾走訪的範例,這個巢狀資料夾的結構就是今天的主題,Tree。
那一棵 Tree 要怎麼走訪呢?今天就從 Tree 的名詞開始看起,再看看走過一棵 Tree 有哪些走法~
先給一句話的定義:
Tree 是一種階層式 (hierarchical) 的資料結構,每個節點底下可以有多個子節點,而每個子節點只屬於一個上層節點。
階層式的相對是線性 (linear),Array 與 Linked List 就是線性的代表。以 Linked List 來説,它的每個 node 都有一個 next,最多指向一個 node,整串資料只有一條路可以走;而 Tree 的 node 可以同時指向好幾個 node,路就從一條變成好幾條。因此,Linked List 其實可以看成一種特殊的 Tree,一種每個 node 都只有一個下層 node 的 Tree,兩者用的元素相同,都是 node 加上指向別人的參照,差別只在一個 node 能連出去幾條。
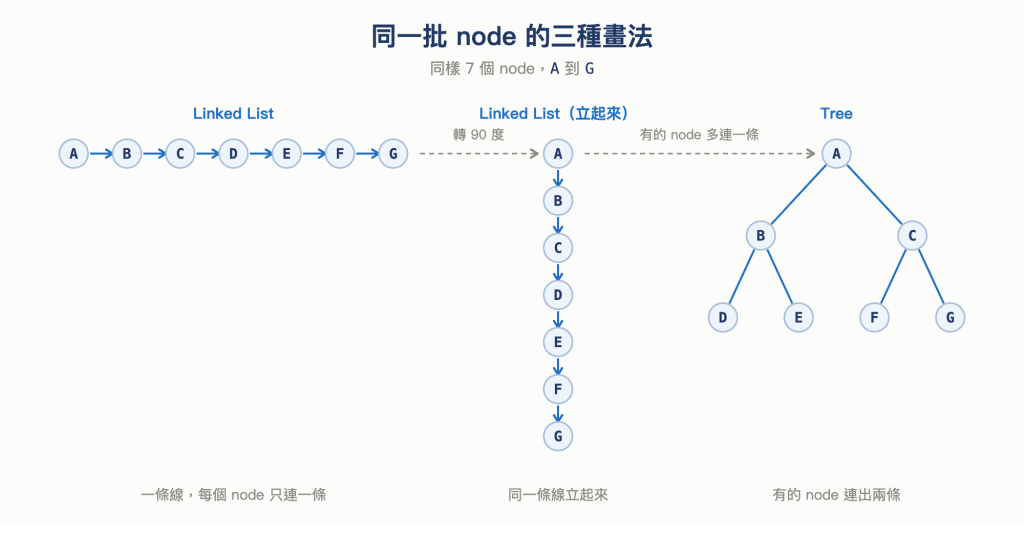
圖 1 同一批 node 的三種畫法
Tree 其實在實務應用很常見。網頁的 HTML 被瀏覽器讀取後會變成 DOM,而 DOM 就是一棵 Tree,<html> 底下有 <head> 與 <body>,各自底下又還有別的元素;程式碼也是,JavaScript 交給引擎執行之前會先被解析成一棵 Abstract Syntax Tree (AST),V8 就是先解析出 AST,再由它編譯成 bytecode,而 ESLint 檢查程式碼時走訪的也是這棵 AST,每條規則都是在上面的 node 做判斷;檔案系統、留言串、家族族譜,也都是 Tree 這種結構。這些資料的共同點是它們天生就有上下層的關係,用線性表示反而會遺失資料間的關係。
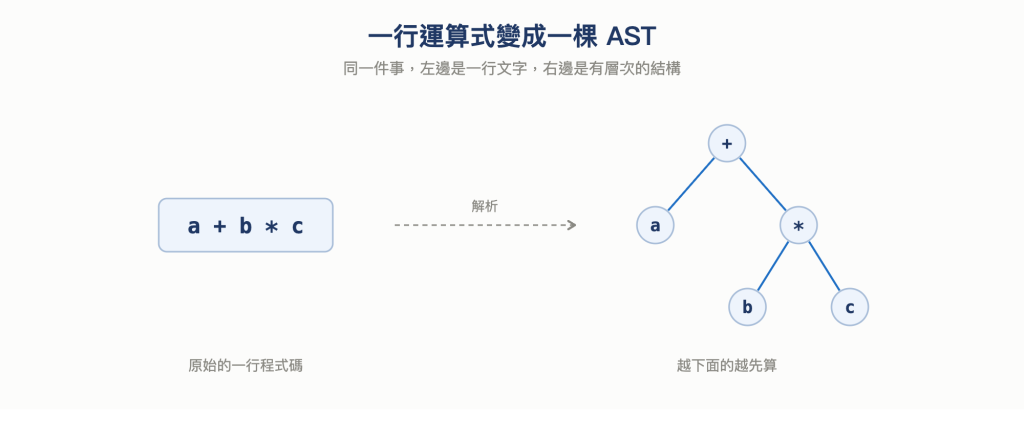
圖 2 運算式 a + b * c 對應的 AST,先算的 b * c 落在下面一層(資料來源:Wikipedia:Abstract syntax tree,Claude Code 重繪)
接下來介紹一些 Tree 的相關名詞~底下用同一棵 Tree 當作今天的例子,它有 7 個 node,值分別是 9、4、20、1、6、15、170:
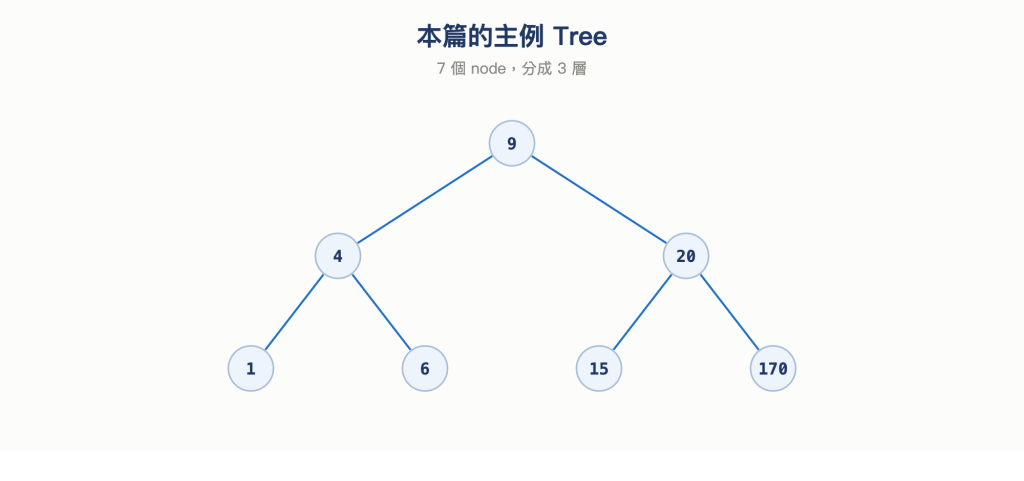
圖 3 本篇的主例 Tree,7 個 node、3 層
最上面那個沒有任何上層的 node 叫做根節點 (root),也就是這棵 Tree 的入口,例子裡是 9。一棵 Tree 只會有一個 root,這和 Linked List 只有一個 head 是相同道理,都是為了讓資料有明確的起點。
從 root 往下連出去的關係有兩個名字:連出去的那一端是子節點 (child),被連的那一方是父節點 (parent)。9 是 4 與 20 的 parent,4 與 20 則是 9 的 child。這個關係是單向的,一個 parent 可以有好幾個 child,但一個 child 只能有一個 parent,也因為這限制,從 root 走到任何一個 node 都只有一條路。同一個 parent 底下的 node 互相稱為兄弟節點 (sibling),4 與 20 就是一對 sibling。
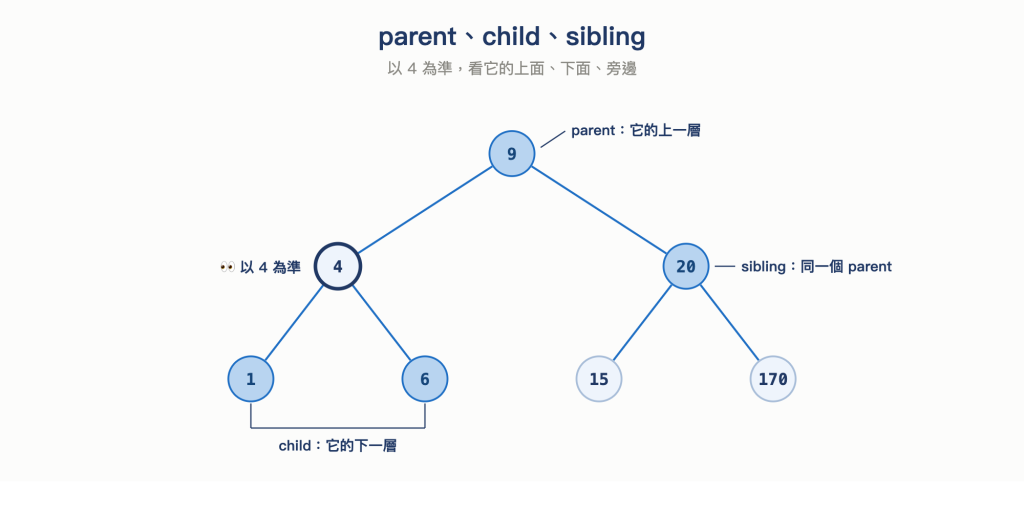
圖 4 parent、child、sibling 都要先選一個 node 才成立,這裡以 4 為準
而從一個 node 沿著 parent 一路往上,經過的所有 node 都是它的祖先 (ancestor),1 的 ancestor 就是 4 與 9;反過來由上往下看,4 底下的所有 node 都是它的子孫 (descendant)。
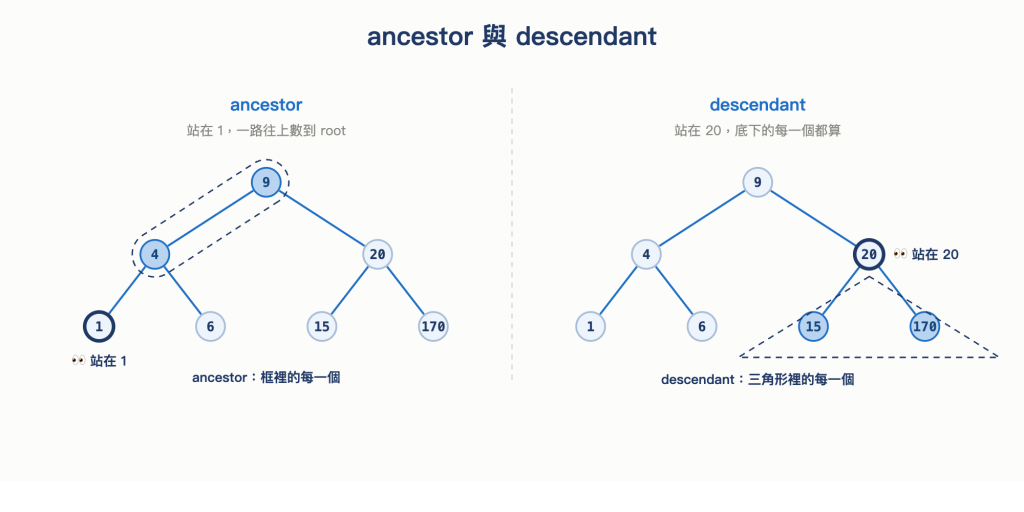
圖 5 ancestor 與 descendant 是一路數到底
底下沒有任何 child 的 node 叫做葉節點 (leaf),例子裡的 1、6、15、170 都是 leaf,它們是這棵 Tree 的末端。而任何一個 node 連同它底下的所有 node,合起來又是一棵完整的 Tree,這叫做 subtree,例如 4、1、6 三個 node 就構成了 9 的 left subtree。
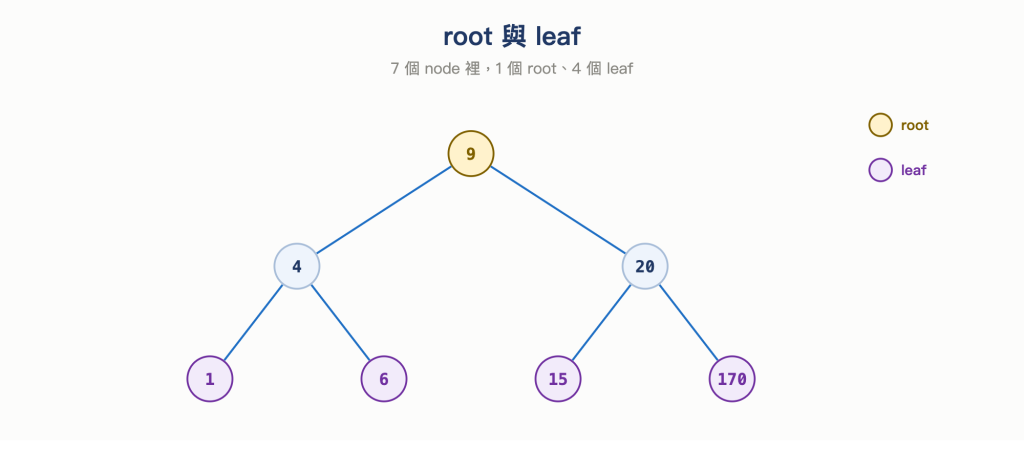
圖 6 root 與 leaf
subtree 其實就是 Day 13 說的那種子問題,遞迴要找的是一個「規模更小、形狀完全一樣」的子問題,而 subtree 就是這種東西:9 的 left subtree 自己也是一棵合法的 Tree,它一樣有 root、有 child、有 leaf,處理一棵 Tree 的函式可以原封不動地拿去處理它。因此 Tree 的操作幾乎都寫成遞迴,因為這種類型的結構就是由更小的自己組成的。
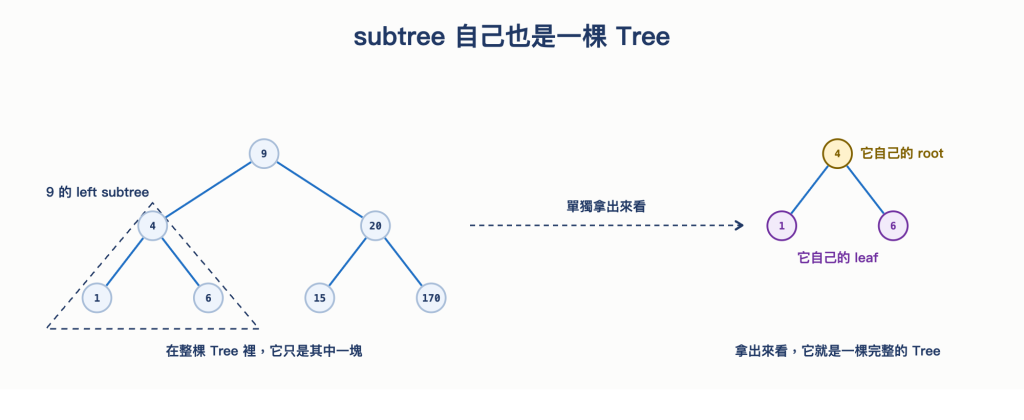
圖 7 subtree 單獨拿出來看,本身就是一棵完整的 Tree
要描述一個 node 在 Tree 裡的位置,需要兩個數字。第一個是深度 (depth),指的是從 root 走到這個 node 要經過幾條邊,root 自己的 depth 是 0,4 與 20 的 depth 是 1,1、6、15、170 的 depth 都是 2。第二個是高度 (height),指的是從這個 node 往下走到最遠的那個 leaf 要經過幾條邊,所以 leaf 的 height 都是 0,4 的 height 是 1,而 root 9 的 height 是 2。很常聽到說「這棵 Tree 的 height」,指的就是 root 的 height。
為什麼同一件事要有兩個詞呢?因為它們數的方向相反,depth 是往上數到 root,用來回答「從入口走到這裡有多遠」;height 是往下數到最深的 leaf,用來回答「從這裡開始最多還要走幾步」。當我們要計算走訪的成本時,是用 height 來描述。
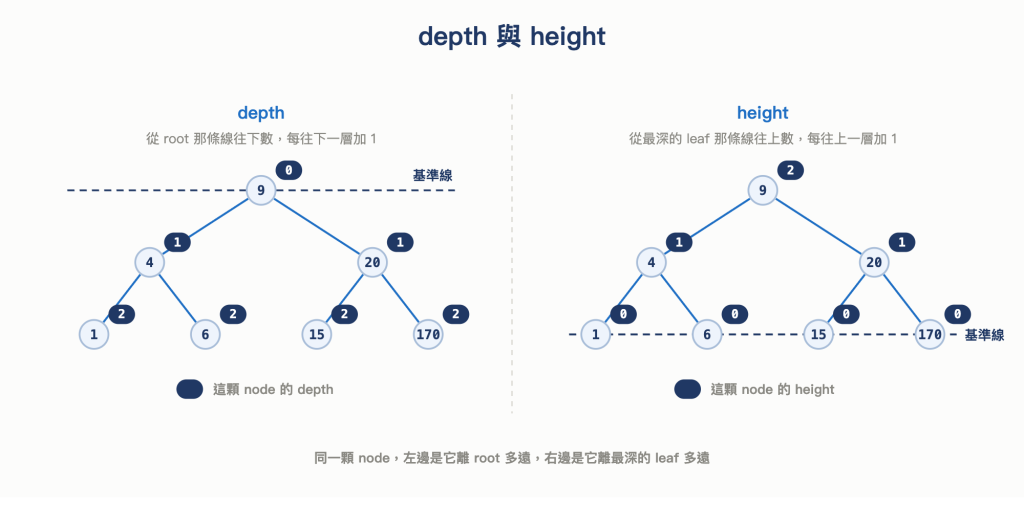
圖 8 depth 與 height
前面的定義只說 Tree 底下可以有多個子節點,沒有限制幾個,這種不限制 child 數量的 Tree 叫做 general tree,寫成程式碼的話,child 會放在一個陣列裡:
class TreeNode {
  constructor(value) {
    this.value = value;
    this.children = []; // 底下有幾個 child 不限制
  }
}
檔案系統就屬於這種,一個資料夾底下可以有 0 個或 100 個項目,事先不會知道。
不過接下來要介紹的 Tree 走訪,如果每個 node 的 child 數量都不一樣,光是描述「先走哪一個」就會變得很麻煩,因此通常會加上一條限制。這種 Tree 叫做 binary tree,它有幾個規則:
left 與 right,就算底下只有一個 child,也要說清楚它在左邊還是右邊寫成程式如下:
class Node {
  constructor(value) {
    this.value = value;
    this.left = null;
    this.right = null;
  }
}
有這限制後,每個 node 底下的情況只剩下三種:
除了 binary tree 以外,Tree 底下的種類還有很多,差別在於一些額外的規則:
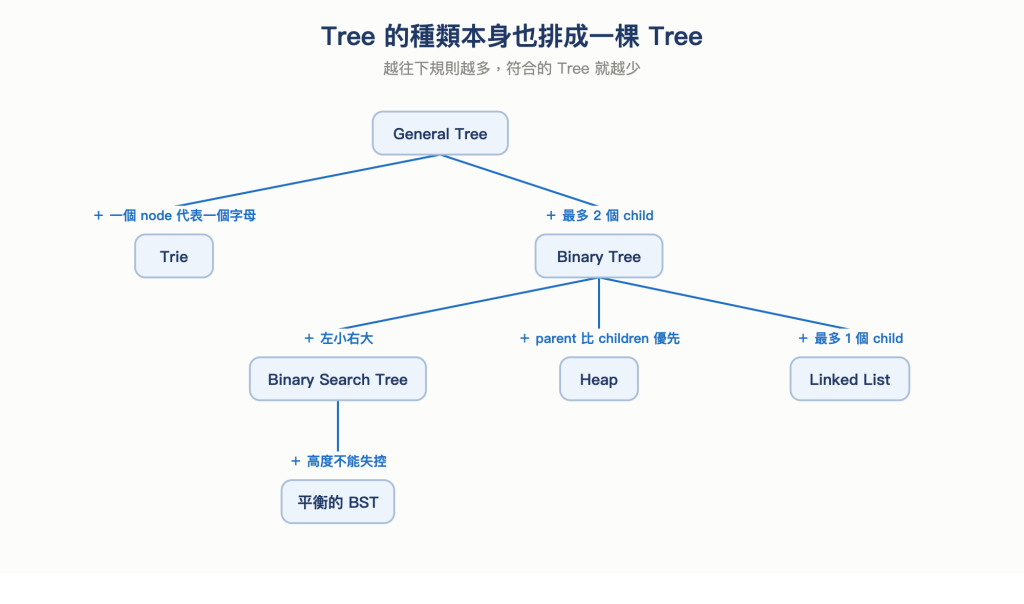
圖 9 Tree 的種類本身也排成一棵 Tree
有些規則在後面才會提到,這裡只是先給一個概覽~
今天會介紹的例子都是 binary tree,上面那例子的 Tree 寫起來如下:
const root = new Node(9);
root.left = new Node(4);
root.right = new Node(20);
root.left.left = new Node(1);
root.left.right = new Node(6);
root.right.left = new Node(15);
root.right.right = new Node(170);
這裡先手動接 7 個 node,沒有寫 insert。因為「新的值該放左邊還是右邊」需要另一條規則才能決定,這是之後的主題,今天只要有一棵接好的 Tree 可以走訪即可。
有了 Tree 後,來看看要怎麼走訪 (traversal) Tree 吧~
什麼時候會需要走訪呢?處理資料時,不一定每次都在找某個特定的值。有時候是要把每個 node 的值都乘 2,有時候是要幫每個 node 加上一個屬性,有時候是要檢查全部的 node 有沒有哪一個不符合某個條件。這些工作的共同點是沒有任何一個 node 可以跳過。既然每個都要碰到,要決定的就只剩一件事:用什麼順序把它們全部走完。
在 Array 裡沒什麼問題,index 從 0 排到最後一格走訪即可。但在 Tree 上,走到任何一個 node 時,手上都同時有三件可以做的事:處理自己、走進 left subtree、走進 right subtree。左右兩邊誰先走通常固定成先左後右,於是真正的變數只剩下一個:處理自己這件事,要排在哪個位置,三個位置就對應三種走訪方式。
前序走訪 (preorder) 的順序是:先處理自己,再走 left subtree,最後走 right subtree。
function traversePreOrder(node, list) {
  if (!node) return list; // base case:走到空的地方就回去

  list.push(node.value); // 先處理自己
  traversePreOrder(node.left, list);
  traversePreOrder(node.right, list);
  return list;
}

traversePreOrder(root, []); // [9, 4, 1, 6, 20, 15, 170]
拿例子那棵 Tree 跑一次,得到的順序是 9, 4, 1, 6, 20, 15, 170。這裡的 base case 是 node 為 null,也就是往下走到沒有 child 的地方,直接回去,這就是利用遞迴概念,每次呼叫都往下一層走,總會走到那個可以直接給答案的情況。
實際跑起來是這樣的,最外層的呼叫拿到 root 9,先把 9 記進 list,然後呼叫自己去處理 left subtree,這時候 9 這一層並沒有結束,它停在那一行等左邊回來。第二層拿到 4,同樣先記下 4 再往左走。第三層拿到 1,記下 1 後往左呼叫,但 1 沒有 left,下一層收到的是 null,碰到 base case 就直接回去了,往右也是一樣,於是 1 這一層做完自己的事就結束,控制權回到 4。4 這時候才接著處理右邊的 6,等 6 也走完,4 這一層才真的結束,9 也才開始處理 right subtree:
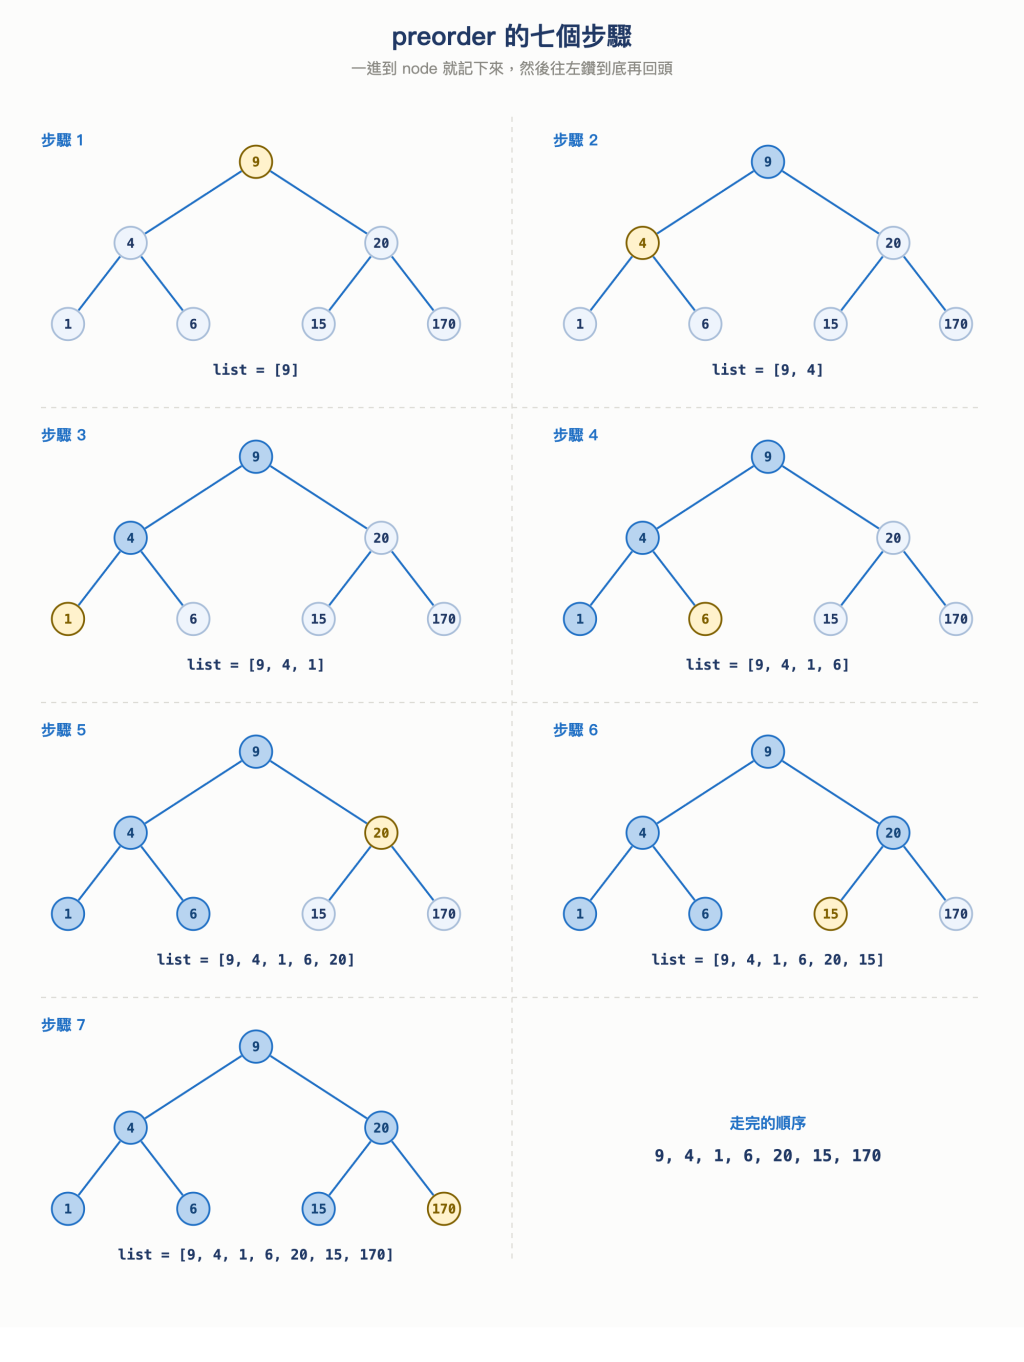
圖 10 preorder 的七個步驟,黃色是這一步正在處理的 node,深藍是已經記進 list 的
深藍的部分一路往左長到底再往回補,剛好就是遞迴往下鑽再退回來的路徑。而每一層做的事情都一樣:記下自己、交代左邊、交代右邊,差別只在拿到的是哪一棵 subtree。
中序走訪 (inorder) 的順序是:先走 left subtree,再處理自己,最後走 right subtree。程式碼只有 list.push 那行換了位置:
function traverseInOrder(node, list) {
  if (!node) return list;

  traverseInOrder(node.left, list);
  list.push(node.value); // 左邊走完才處理自己
  traverseInOrder(node.right, list);
  return list;
}
跑出來的順序是 1, 4, 6, 9, 15, 20, 170。root 9 這次跑到中間,因為要等它的 left subtree 整個走完才輪到它。而 9 的 left subtree 裡也是同一套規則,4 要等 1 走完才被記下來,所以最左下角的 1 才是第一個。
後序走訪 (postorder) 的順序是:先走 left subtree,再走 right subtree,最後才處理自己。
function traversePostOrder(node, list) {
  if (!node) return list;

  traversePostOrder(node.left, list);
  traversePostOrder(node.right, list);
  list.push(node.value); // 兩邊都走完才處理自己
  return list;
}
順序是 1, 6, 4, 15, 170, 20, 9。這次 root 9 跑到最後一個,因為它得等左右兩棵 subtree 都處理完。同樣的道理,4 也是等 1 和 6 都記下來之後才輪到自己。
三段程式碼中,遞迴的兩行完全沒變,動的只有 list.push(node.value) 這一行的位置:
| 走訪順序 | 處理自己的時機 | 例子那棵 Tree 的結果 |
|---|---|---|
| Preorder | 一進到這個 node 就處理 | 9, 4, 1, 6, 20, 15, 170 |
| Inorder | left subtree 走完後 | 1, 4, 6, 9, 15, 20, 170 |
| Postorder | 左右 subtree 都走完後 | 1, 6, 4, 15, 170, 20, 9 |
這三個方法的名字其實和這有關,pre、in、post 指的都是「處理自己」相對於 subtree 的位置,排在 subtree 之前是 preorder,夾在兩棵 subtree 中間是 inorder,排在 subtree 之後是 postorder。
換個角度看,走訪過程中,每個 node 其實都會被經過三次,一次是剛走到它、一次是 left subtree 走完回到它、一次是 right subtree 走完回到它。三種走訪只是在這三次裡挑一次把值記下來,其他兩次就只是路過。所以三種走訪走的路徑和碰到的 node 完全相同,差別只在輸出的順序。
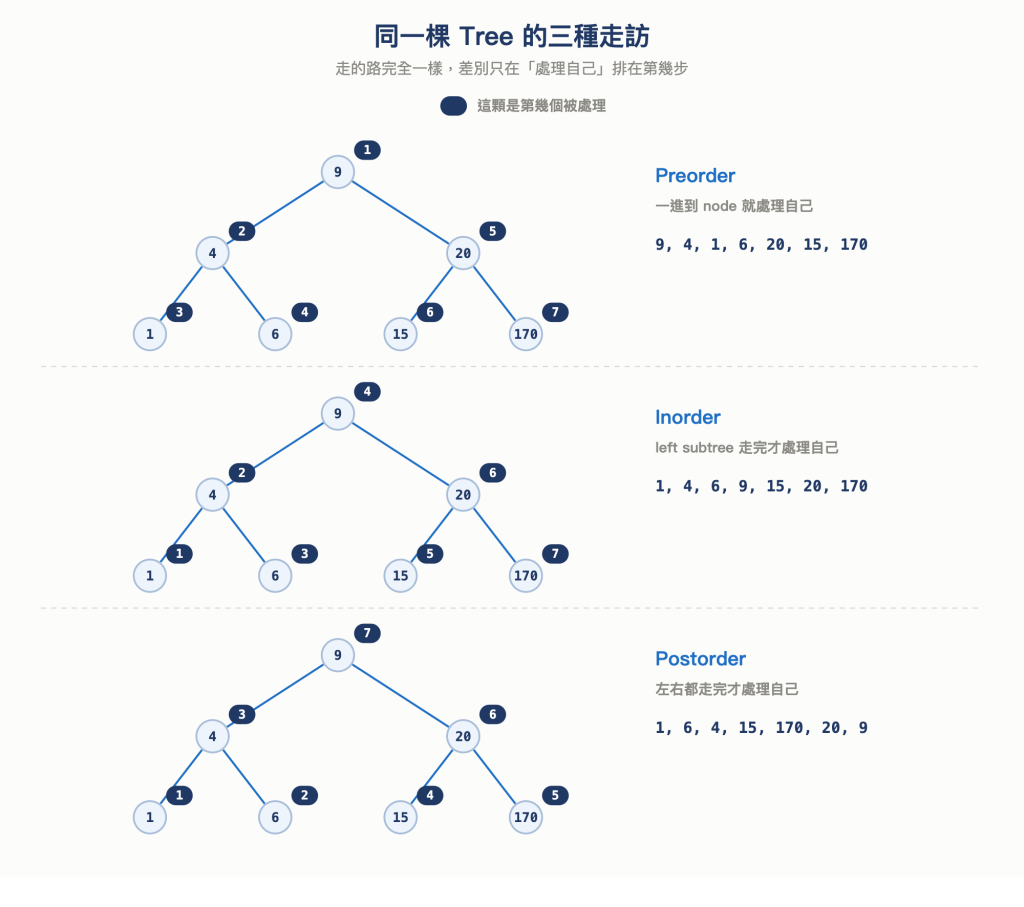
圖 11 同一棵 Tree 的三種走訪
前面三種走訪策略可稱之為深度優先走訪 (Depth-First Search,簡稱 DFS),它們都是先沿著一條路往下鑽到底,到底後才退回上一個岔路換另一邊。
但還有一種策略是橫著走,先把 root 這一層看完,再看下面一層,每一層都由左到右。用在例子那棵 Tree 上,順序會是 9, 4, 20, 1, 6, 15, 170。這種走法叫層序走訪 (level-order),它無法利用遞迴,因 call stack 記住的是「還沒走完的那條路」,而層序走訪要記住的是「這一層看到的所有 child,等下一層才輪到它們」,這剛好是先進先出 Queue 的概念。層序走訪還有一個更常見的名字叫廣度優先走訪 (Breadth-First Search),詳細介紹會在之後看到。
走訪的時間複雜度是 O(N),N 是 node 的總數,理由很好懂,走訪的定義就是每個 node 都要碰到,而每個 node 也只會被處理一次,加起來就是 N 次。三種走訪都一樣,因為換順序不會換掉次數。
空間的部分要看 call stack,遞迴的額外空間就是它最深的那一層有多深,而走訪一棵 Tree 時,同時疊在 call stack 上的呼叫,剛好就是從 root 走到目前這個 node 的那條路,最深的時候就是 Tree 的 height,額外空間是 O(h)。
可能有人會想說,前面那三段程式碼都還帶著一個 list,最後裝了全部的結果,這樣額外空間不是應該算 O(N) 嗎?Day 03 提過,空間複雜度看的是 Auxiliary Space,而這個 list 是這次要產出的結果本身,通常會和過程中暫時借用的空間分開看。另外,其實走訪不一定需要它,如果只是要把每個 node 的值乘 2,程式裡根本不會出現這個 list,這時候剩下的就只有 call stack。
那 h 和 N 差多少呢?這要看 Tree 長什麼樣子,如果每一層都盡量填滿,7 個 node 可以排成 3 層,h 大約是 log N;但如果每個 node 都只有一個 child,整棵 Tree 就縮成一條線,h 會等於 N - 1,這時額外空間就退成 O(N) 了。也就是說,Tree 的形狀會直接影響成本。
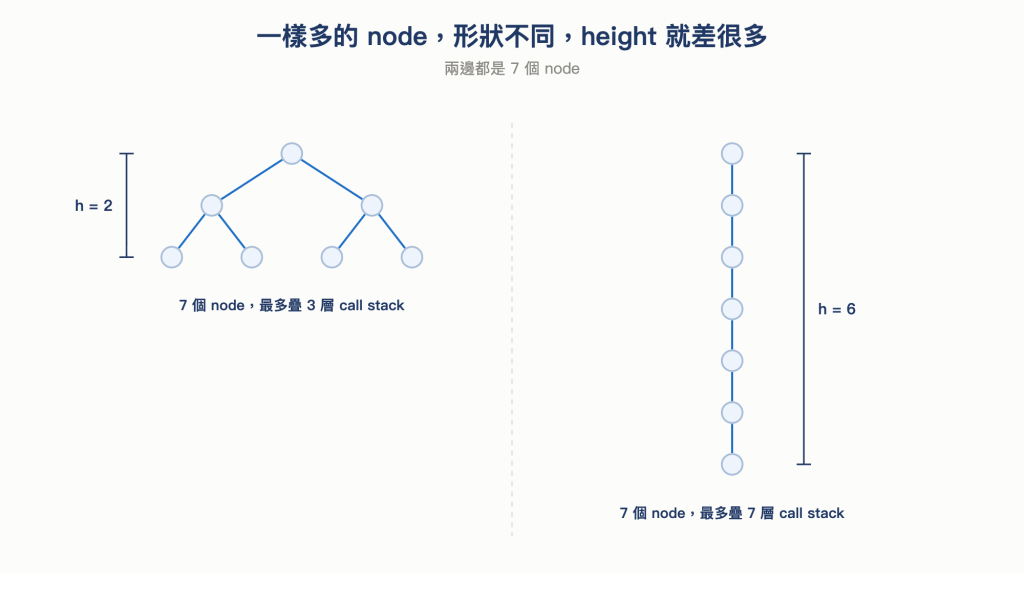
圖 12 7 個 node 排成兩種形狀,填滿的高度是 2,串成一條的高度是 6
三種走訪方式各自適合不同的工作。
preorder 的第一個一定是 root,接著才是 subtree 的內容,因此它輸出的順序可以和 Tree 的結構對得上,適合用來把一棵 Tree 的形狀原樣記下來,例如複製一棵 Tree,或把它輸出成文字。以複製來說,要把一個 child 接上去之前,得先有那個 parent 存在才接得住,順序只能由上往下,先做出自己再做出兩邊,這正好就是 preorder。
postorder 則相反,自己永遠排在最後,所以它適合那種「要先有 children 的結果,才算得出自己」的工作。刪除一整棵 subtree 是一個,得先把 children 都刪掉才輪得到自己,順序反過來的話,還沒刪的 children 就找不到了。算一個資料夾佔多少空間也是,4 這個 node 要算出自己這棵 subtree 佔多少,得先拿到 1 和 6 的結果才加得起來,而 1 和 6 又要等它們自己底下的結果,這樣一路等下去,最後第一個算得出答案的是最深的那些 leaf,答案再一層層加回來。這個「先有下面才有上面」的形狀,就是 postorder 的順序。
至於 inorder,剛才那棵 Tree 跑出來的是 1, 4, 6, 9, 15, 20, 170,剛好是由小到大。這不是巧合,那棵 Tree 的數字放的位置有一條規則,明天會再來介紹。
最後看一個真實的例子,是 Day 11 檢查括號時提過的 VS Code 括號上色功能。當時問的是「括號有沒有配對」,一個 Stack 就可以回答;而編輯器要把每一對括號依巢狀層數上色,還得再回答一件事:每一對括號各自在第幾層,而且要在你打字的當下就答出來。
一個括號在第幾層,取決於它前面的每一個字元,所以以前做法是每次編輯就重掃整份文件,結果在一份 4 萬多行的檔案開頭插入一個括號,要等大約 10 秒顏色才會更新完。後來 VS Code 改用一棵 Tree 來表示括號的巢狀關係,關鍵作法是每個 node 只存自己那一段有多長,不存它在檔案裡的絕對位置。
這裡的長度指的是那一段佔了幾個字元,括號本身也算進去,所以 (a) 的長度是 3。
舉例來說,(a)(b) 這六個字元裡有兩對括號,現在在第一對裡插入一個字元,讓它變成 (ax)(b)。如果存的是絕對位置,原本第一對在第 0 格和第 2 格、第二對在第 3 格和第 5 格,插入之後變成 0 和 3、4 和 6,四個數字裡有三個要改,連完全沒被動到的第二對也無法避免。改成存長度就不同了,被插入的第一對從 (a) 的 3 變成 (ax) 的 4,包住它的整行從 6 變成 7,而第二對雖然整個往後挪了一格,長度還是 3,一個字都不用改。
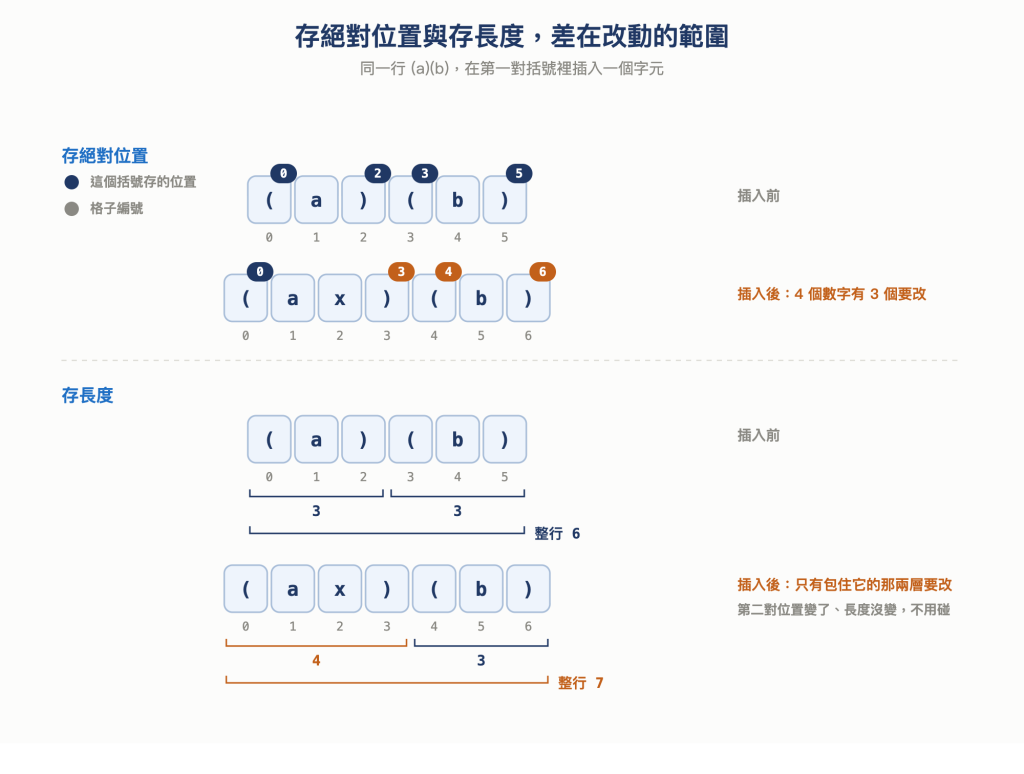
圖 13 同樣插入一個字元,存絕對位置連旁邊那對括號都要改,存長度只改到包住它的那兩層
而包住它的每一層,就是從那個 node 往上到 root 的那些 ancestor,也就是前面說過的,從 root 到任何一個 node 都只有一條路。因此一次編輯要更新的,就只有那一條路上的 node,時間因此從 10 秒降到不到 1 毫秒。原文還處理了許多細節,這裡只稍微簡介,有興趣可看看原文~
小小總結一下今天對 Tree 的認識~
實際使用時,還可以記住幾件事~
O(N),因為每個 node 都要碰到一次;能砍掉一半的前提是知道往哪邊找,走訪沒有這個前提O(h),也就是 Tree 的 height,而 h 會隨著 Tree 的形狀在 log N 和 N 之間變動圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術