
Day 12 介紹 Queue 時,最後有提到,如果連「照抵達的順序處理」這個原則都放棄了,那用的其實已經不是 Queue 了。今天要看的就是放棄之後的那個東西~
先來看一個情境~假設急診室裡同時有好幾位病患在等,而醫師一次只能看一位。這時如果照進急診室的順序叫號,先到的先看,那位剛被送進來、狀況最危急的病患就得排在所有人後面。因此實際上急診室會做檢傷分級(實務分級狀況可參考衛福部網站),可假設每位病患都會拿到一個嚴重程度,數字越大代表越需要優先處理,叫號時看的是這個數字,不是抵達時間。
把這件事寫成程式,直覺上可這樣寫:
const patients = [];

patients.push({ name: '病患 A', level: 8 });
patients.push({ name: '病患 B', level: 5 });
patients.push({ name: '病患 C', level: 9 });

while (patients.length > 0) {
  patients.sort((a, b) => b.level - a.level); // 每次都重排一次
  callNext(patients.shift());
}
這段程式沒什麼問題,每次叫號前重排一次,拿到的一定是目前最嚴重的那一位。但每來一位病患就要把整份名單重新排好,而叫號時真正用到的只有排在最前面的那一個,其他人排在第幾位其實沒有人在意。那有沒有一種存法,不必把所有人完整排好,卻仍然能隨時指出目前最該處理的是誰呢?這種存法就稱為 Heap,而它要滿足的需求叫做 Priority Queue,今天就從這個需求開始看~
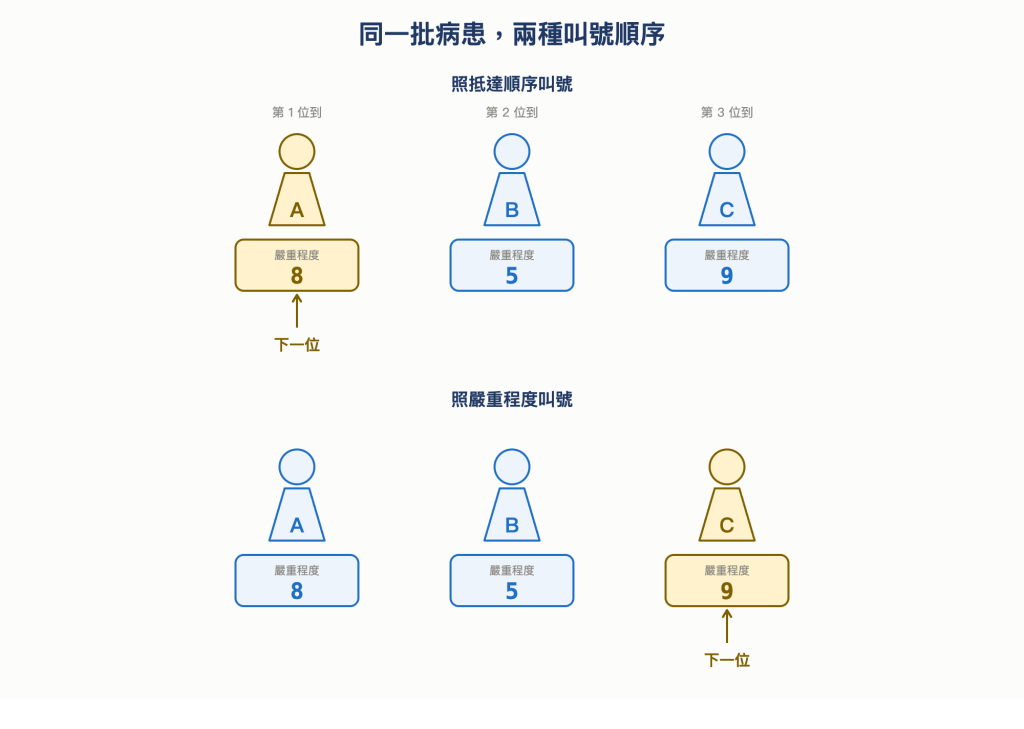
圖 1 同一批病患,照抵達順序與照嚴重程度,叫到的不是同一個人
先給 Priority Queue 一句話定義:
Priority Queue(優先佇列)是一排有順序的資料,只能從一端取出,而取出的順序由每一筆資料的優先程度決定,不是由放進去的時間決定。
和 Queue 相比,兩者都只從固定的一端取,差別在於決定順序的東西換了。Queue 用抵達時間,先進的先出;Priority Queue 用優先程度,最緊急、最優先的先出,就算它是最後才進來的也一樣。急診室給每位病患的那個嚴重程度,就是這裡說的優先程度,換一個情境它可能是任務的重要性,但扮演的角色都相同。
另外,Priority Queue 講的是「能做哪些操作、操作要滿足什麼規則」,它並沒有規定資料實際上要怎麼存,而它是一種抽象資料型別 (Abstract Data Type)(Day 11 提過),同一個 ADT 可以有好幾種底層實作,選哪一種是效率問題,不是正確性問題。
補充:名字裡有 queue,但它不是 FIFO
Day 12 提過,名字裡有 queue 的不一定遵守 FIFO,而 Priority Queue 就是另一個例子,它的名字裡有 queue,實際上卻放棄了 Queue 最核心的那條規則。
Day 12 引用過的〈Queueing〉那篇裡,作者比較了四種取用策略,前兩種 FIFO 與 LIFO 已經介紹過,第三種就是今天的 Priority Queue。那篇對它的描述是「FIFO 和 LIFO 都平等對待每一個請求,但有些請求本來就是比較重要的」,而它也點出一個限制:當隊伍滿了,該丟掉的還是得丟,優先權只決定誰先被處理,不保證誰不會被丟掉。
既然 Priority Queue 沒有規定怎麼存,那就先用 Array 試試看,直覺想法是維持一個排好序的 Array,插入時就把新資料放到正確位置,並把優先程度最高的那個放在 Array 的尾端。
為什麼是尾端而不是開頭呢?因為從 Array 開頭移除元素是 O(N),後面每一格都得往前補;而從尾端移除不需搬動任何東西。既然叫號是最頻繁的操作,就讓它落在成本最低的那一端。
這樣一來,取出最高優先的資料是 O(1),直接從尾端拿走就好。問題出在插入:新病患來的時候,得先找出他該插在哪個位置,再把後面的人全部往後挪一格,所以插入是 O(N),急診室的病患越多,這個成本就越明顯。
這裡可以先想想,O(N) 到底是為了什麼而付出的成本?
是為了維持「整份名單完全照優先程度排好」,但其實急診室叫號真正需要的只有「現在最該處理的是誰」。至於第二嚴重的和第三嚴重的誰在前面,在他被叫到之前都沒差。Ordered Array 給的保證遠超過需求,而那個 O(N) 就是為了多出來的保證付的。
我們可以換個問法:有沒有一種規則,弱到不必把所有資料完整排好,但仍然強到隨時指得出最高優先的那一個?
這就是前言說的那種存法,全名是二元堆積 (Binary Heap)。先給一句話的定義:
Binary Heap(二元堆積)是一棵 Binary Tree,靠兩條規則讓優先程度最高的那一個永遠待在 root,所以不必把資料完整排好,也能立刻取到它。
接下來就來看看這兩條規則是什麼~
Heap 分成 Max-Heap 與 Min-Heap 兩種,兩者的結構相同,只是規則的方向相反,而今天的急診室是數字越大越優先,所以底下都以 Max-Heap 為例。
第一條規則管的是值的大小關係,可稱為 Heap Condition:
Heap Condition(堆積條件):在 Max-Heap 中,每個 node 的值都必須大於它底下所有的 descendant。
descendant 代表規則要求的不只是比自己的兩個 child 大,而是比整棵 subtree 裡的每個 node 都大。不過實際檢查時不需真的逐一比對,因為只要每一顆 node 都比自己的 child 大,往下傳遞後自然就比所有 descendant 都大。
反過來,這條規則對左右兩邊沒有任何要求,left child 和 right child 誰大誰小都可以,只要都比 parent 小就是合法的。Day 20 的 Binary Search Tree 規定 left 比自己小、right 比自己大,Heap 沒有這限制。
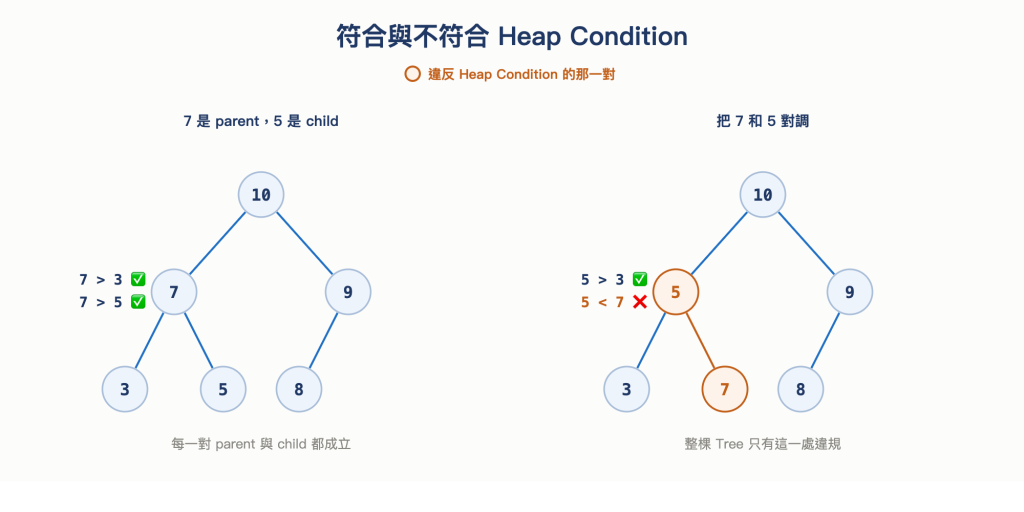
圖 2 只要有一顆 node 比它的 parent 大,整棵 Tree 就不再是 Max-Heap
第二條規則管的是形狀,可稱 Complete Tree:
Complete Tree(完全樹):除了最底層以外,每一層都必須填滿;最底層可以沒填滿,但所有 node 必須盡可能靠左,不可以在空位的右邊還有 node。
昨天的文章結尾有提過,Binary Search Tree 的規則只管值的大小,形狀要另外維持。Heap 的做法不同,形狀是它的規則之一,形狀只要不是 Complete Tree,就不算是 Heap。因此 Heap 的高度永遠是 log N,這保證來自規則本身,不需另外處理平衡。
提到 Complete Tree 時,還有兩個名字常常一起出現,比較如下:
| 名稱 | 規則 | 最底層 |
|---|---|---|
| Complete | 逐層填滿,最底層盡量靠左 | 可以沒填滿 |
| Full | 每個 node 底下有 0 個或 2 個 child | 沒有限制 |
| Perfect | 同時滿足上面兩條 | 一定是填滿的 |
Heap 只要求 Complete,另外兩個只是順便補充~
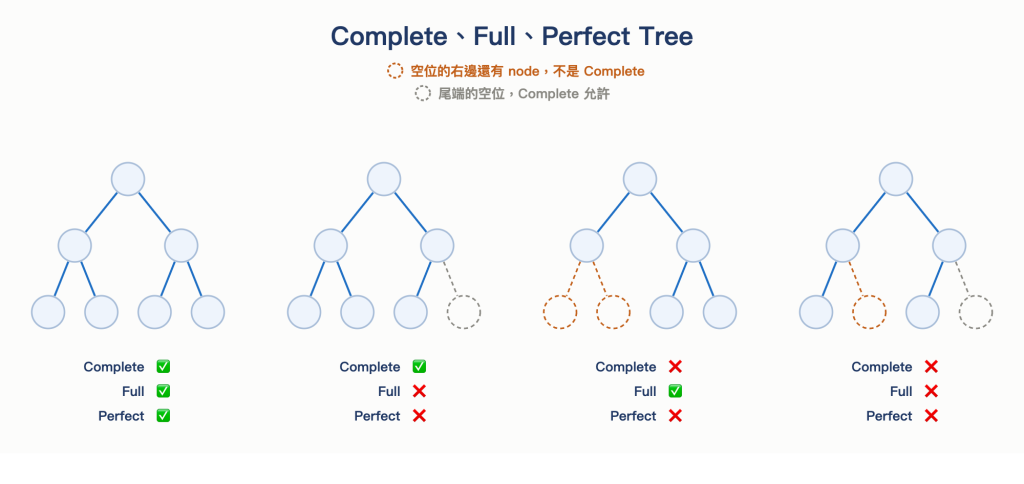
圖 3 Complete、Full、Perfect Tree
看完規則後,接著來看這組規則帶來什麼,有捨必有得,分為失去的部分和換得的部分。
先看失去的。因為 Heap 不管左右大小,所以搜尋特定值時,走到某顆 node 後沒有任何依據可判斷該往左還是右。以急診室來說,就算知道要找的嚴重程度是 3、而目前這顆是 8,也推不出 3 會在哪一邊,兩邊都有可能。Binary Search Tree 每比一次就能砍掉一半,Heap 做不到,因此在 Heap 裡找任意值,最壞要檢查每一顆 node,是 O(N)。
再看換得的。Heap Condition 往上傳遞的結果是 root 一定大於它的所有 descendant,也就是整個 Heap 裡最大的那個必定在 root。既然位置是固定的,要知道目前最高優先的就不必找,直接讀 root 就好,這是 O(1)。
由上可知,Heap 放棄的是「找任意一個值」,換到的是「隨時知道最大值在哪」。
補充:Memory Heap 不是這個 Heap
JavaScript 引擎在執行程式時會用到 stack 和 heap 兩塊記憶體,那個 heap 指的是一塊可以存放任意資料的自由空間,和今天講的 Heap 沒有關係,兩者只是名字剛好撞在一起。C 語言那類需要手動配置記憶體的語言也有同名的東西,指的一樣是記憶體區域而不是資料結構。
接著來看實作~Heap 的插入與刪除都會用到同個位置,也就是最底層最右邊的那顆 node,這裡把它叫做 Last Node。插入時新資料要放在 Last Node 的下一格,刪除時則要拿 Last Node 去補 root 空出來的位置。
問題是,如果照 Day 19 那樣用 node 和 link 來存一棵 Tree,程式要怎麼找到 Last Node?人看著圖可以一眼指出來,但程式裡只有 root 和一堆 left、right,而 Heap Condition 只描述值的大小,沒有提供任何線索指出最底層的最右邊在哪。結果就是為了找一個位置,可能得把整棵 Tree 走過一遍。
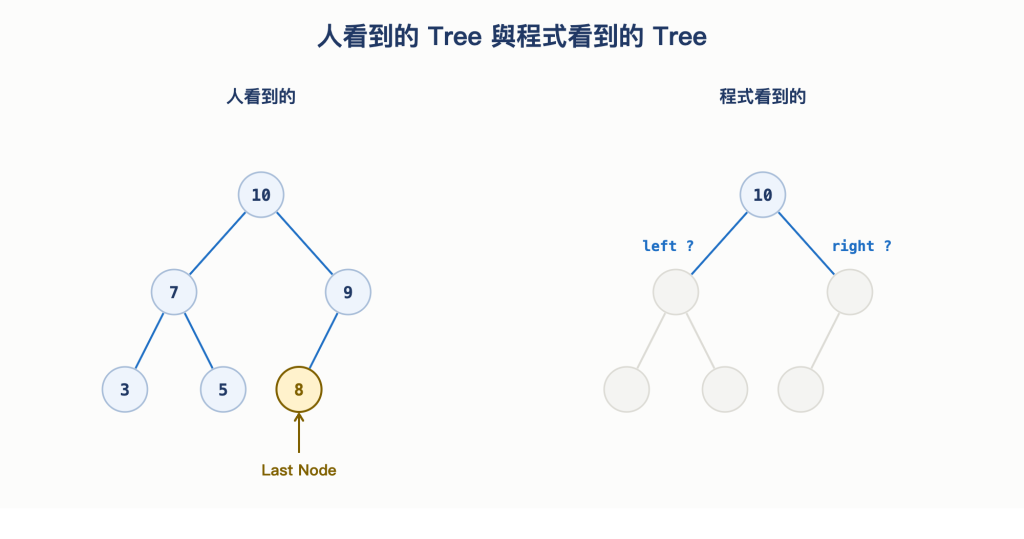
圖 4 人看到的 Tree 與程式看到的 Tree
為了找到 Last Node,我們可以換一種存法,既然 Heap 一定是 Complete Tree,那就把每一顆 node 按照「由上到下、由左到右」的順序,一格一格放進 Array 裡。
這個順序其實 Day 19 就出現過,當時介紹的層序走訪 (level-order) 就是這樣,先看完一層再看下一層,每層由左到右。
存進 Array 之後,Last Node 的問題就解決了。Complete Tree 的規則保證了每一層都填滿、最底層也靠左排,因此按這個順序放進 Array 時中間不會留下空格,最底層最右邊那顆就是 Array 的最後一個元素,而 root 則是第一個元素。插入時只要 push 到尾端,新資料就自動成為新的 Last Node。
那要怎麼從 Array 看到 Tree 的結構、找到 parent 和 child 的關係呢?parent 和 child 的關係其實可以直接用 index 算出來。假設某顆 node 在 index i:
| 要找什麼 | index |
|---|---|
| left child | 2i + 1 |
| right child | 2i + 2 |
| parent | (i - 1) / 2,小數捨去 |
拿前面那個 10, 7, 9, 3, 5, 8 的 Heap 來試算一次。index 1 上面是 7,它的 left child 在 (1 * 2) + 1 = 3、right child 在 (1 * 2) + 2 = 4,也就是 3 和 5,對照前面那棵 Tree 就是 7 底下那兩顆。反過來從 5 出發,它在 index 4,parent 在 (4 - 1) / 2 = 1.5、捨去小數後是 1,回到的正是 7。
公式為什麼會長這樣呢?關鍵仍然是沒有空格。排在 index i 前面的那 i 顆 node,也就是 index 0 到 i - 1,每一顆都帶著兩個 child,而這些 child 從 index 1 開始往後排,剛好佔掉 2i 格。既然前面的位置都被佔滿了,輪到 index i 自己的 child 時,就只能從下一格開始,也就是 2i + 1,right child 再往後一格就是 2i + 2。
反過來要找 parent 也是,left child 是 2i + 1、right child 是 2i + 2,兩個各自減 1 再除以 2 並捨去小數,都會回到同一個 i,所以不必先判斷自己是左邊還是右邊那一個,一條公式就夠了。
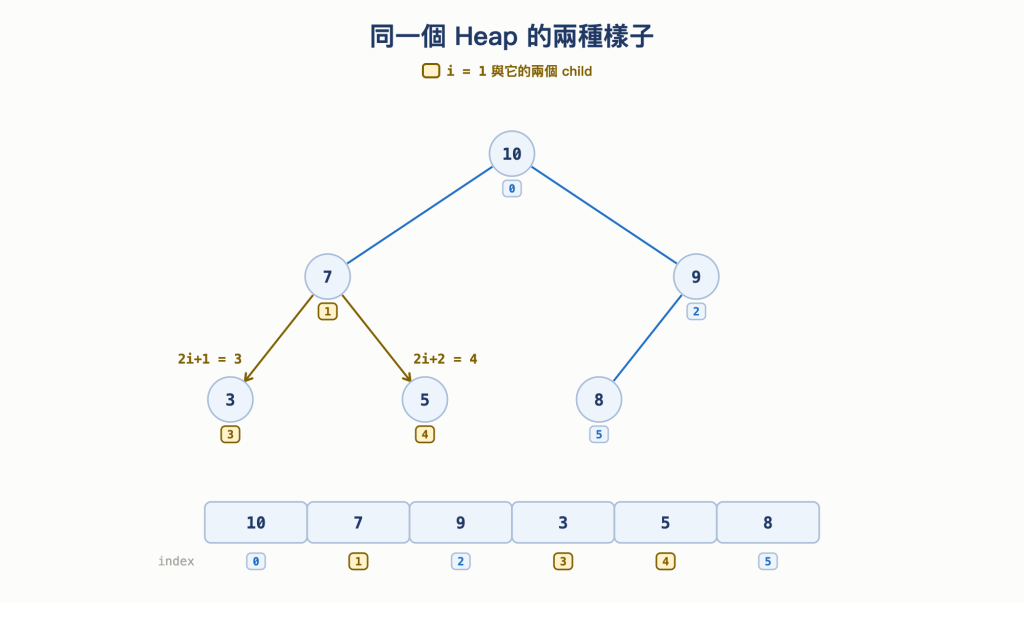
圖 5 上下是同一個 Heap,Tree 是用來理解規則的樣子,Array 才是實際存的樣子
有了這組公式,程式裡就不必真的用 node 和 link 建一棵 Tree,存的是一個 Array:
class MaxHeap {
  constructor() {
    this.heap = [];
  }

  parent(i) { return (i - 1) >> 1; }   // >> 1 等於除以 2 並捨去小數
  left(i) { return 2 * i + 1; }
  right(i) { return 2 * i + 2; }

  swap(i, j) {
    [this.heap[i], this.heap[j]] = [this.heap[j], this.heap[i]];
  }

  peek() {
    return this.heap[0];
  }
}
接著來看一下 heap 的操作~首先是 Insert。
插入分兩步,第一步是把新資料 push 到 Array 尾端,這樣 Complete Tree 的形狀一定是對的,因為新位置就接在最後一顆 node 後面。但這時 Heap Condition 可能被破壞了,如果新來的病患比他的 parent 更嚴重,那條「parent 比 child 大」的規則就不成立。
第二步是修好它,拿新資料和它的 parent 比,如果比 parent 大就交換,然後站到 parent 的位置繼續往上比,直到比不過 parent、或是已經到了 root 為止。這動作叫 bubble up,新資料像氣泡一樣一路往上浮。
回到急診室案例,試著走一次流程,假設先後進來五位病患,嚴重程度依抵達順序分別是 8、5、9、3、7,全部插入之後 Array 會是 [9, 7, 8, 3, 5]。這時又來了一位嚴重程度 10 的病患,插入步驟如下:
push 到 Array 尾端,10 落在 index 5,成為新的 Last Node。形狀此時是對的,但它的 parent 比它小,Heap Condition 被破壞了5 的 parent 在 (5 - 1) / 2 = 2,那裡是 8,10 比較大,兩個交換,10 站到 index 2
2 的 parent 在 (2 - 1) / 2 = 0,那裡是 9,10 還是比較大,再換一次,10 坐上 root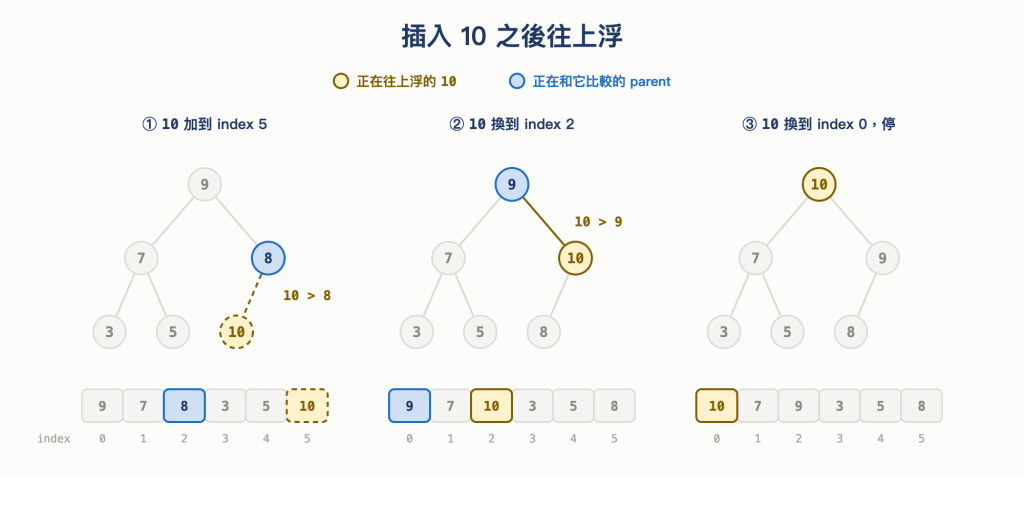
圖 6 新資料先放到最後一格,再和 parent 逐層比較往上換
寫成程式如下:
insert(value) {
  this.heap.push(value);

  let i = this.heap.length - 1;
  while (i > 0 && this.heap[i] > this.heap[this.parent(i)]) {
    this.swap(i, this.parent(i));
    i = this.parent(i);
  }
}
成本上,push 本身是 O(1),而 bubble up 最多從最底層走到 root,走的步數就是 Tree 的高度。Complete Tree 的高度是 log N,所以插入是 O(log N)。
取出最高優先的資料同樣分成兩步。
第一步是把 root 拿走,因為它就是要叫號的那一位,但這樣 root 就空了一格,而 Complete Tree 不允許中間有空位。這時能填進去又不破壞形狀的只有一個,就是 Last Node,也就是 Array 的最後一個元素。把它搬到 root、並把尾端那格移除,形狀就恢復了。
第二步一樣是修 Heap Condition,剛從最底層搬上來的那個值通常不夠大,所以要讓它往下沉:和自己的 child 比,如果比 child 小就交換,然後跟著下去繼續比,直到比兩個 child 都大、或是已經沒有 child 為止。這動作叫 bubble down。
這裡有個地方要選對:當兩個 child 都比自己大時,要跟比較大的那個交換。接著前面那個 [10, 7, 9, 3, 5, 8] 的例子,取出 root 的 10,流程如下:
0,再移除尾端那格,Array 變成 [8, 7, 9, 3, 5]。形狀恢復了,但 8 比它的 child 還小,Heap Condition 被破壞0 的 left child 在 (0 * 2) + 1 = 1、right child 在 (0 * 2) + 2 = 2,分別是 7 和 9。兩個都比 8 大,所以要跟比較大的 9 交換,8 沉到 index 2
2 的 child。它們在 5 和 6,而這時 Array 只到 index 4,兩個都不存在,於是停下來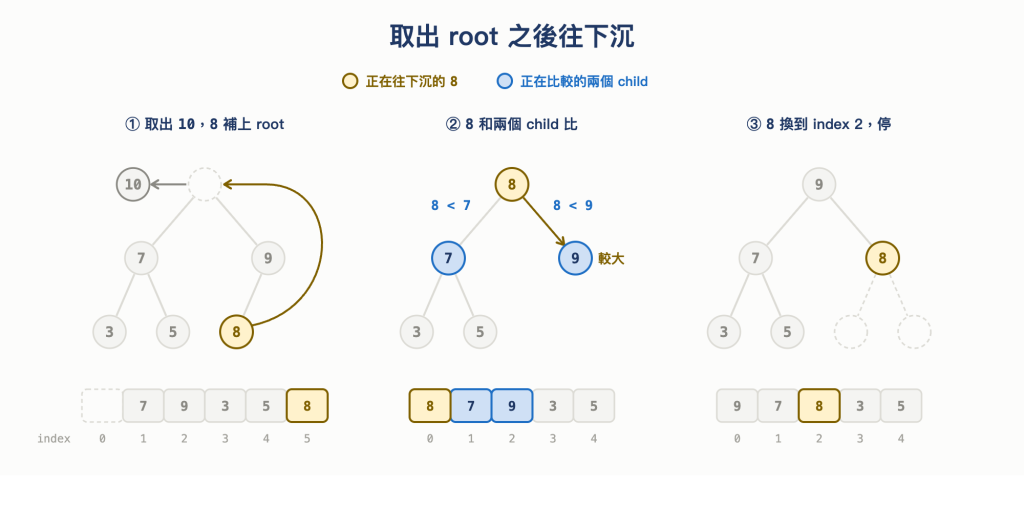
圖 7 用 Last Node 補上 root,再和比較大的那個 child 逐層往下換
回頭看第 2 步,8 的兩個 child 是 7 和 9,兩個都比它大。如果這時挑的不是比較大的 9,而是比較小的 7 呢?結果會是 [7, 8, 9, 3, 5],7 坐上 root,但它的兩個 child 變成 8 和 9,兩邊都比它大。交換前只有一處違規,換完之後變成兩處,比動手前還糟。原因是換上來的那個值必須同時大於兩個 child,而能同時滿足的,只有原本比較大的那一個。
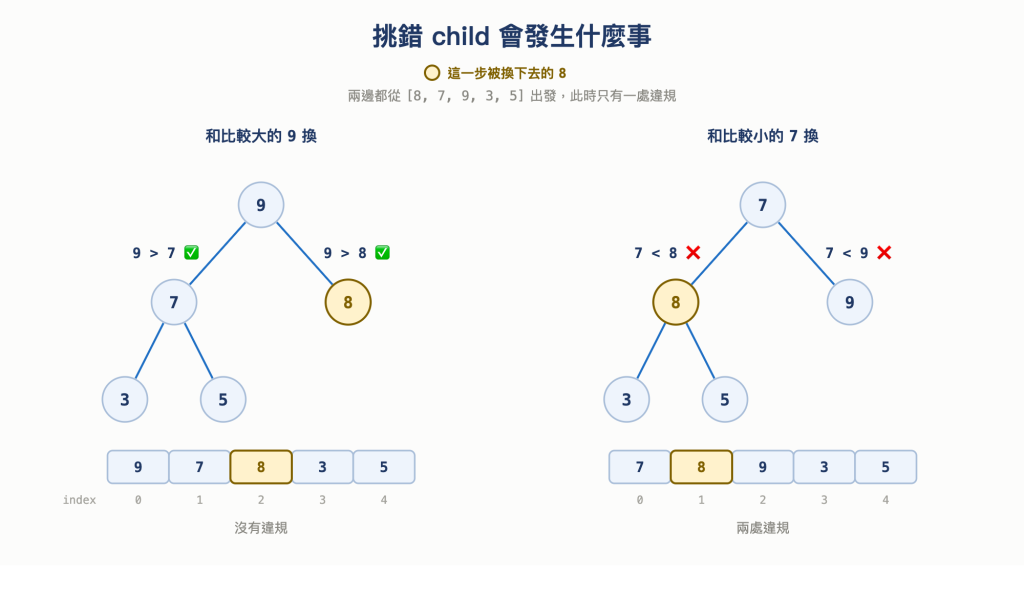
圖 8 挑錯 child 會發生什麼事
寫成程式如下:
extractMax() {
  if (this.heap.length === 0) return undefined;

  const max = this.heap[0];
  const last = this.heap.pop();

  if (this.heap.length > 0) {
    this.heap[0] = last;

    let i = 0;
    while (true) {
      let largest = i;
      const l = this.left(i);
      const r = this.right(i);

      if (l < this.heap.length && this.heap[l] > this.heap[largest]) largest = l;
      if (r < this.heap.length && this.heap[r] > this.heap[largest]) largest = r;
      if (largest === i) break;

      this.swap(i, largest);
      i = largest;
    }
  }

  return max;
}
bubble down 走的同樣是從 root 到最底層這條路,因此取出也是 O(log N)。
插入和取出都繞著同一顆 node 打轉:插入時新資料先成為新的 Last Node,刪除時又拿 Last Node 去補 root。那到底為什麼一定得是 Last Node?
反過來看,如果不用 Last Node,會發生什麼事呢?插入時如果不放在下一個空位,而是隨便挑一個還空著的地方,例如直接掛到最左下角,那一層就會在上一層還沒填滿的情況下先長出來,Tree 開始往一邊偏;刪除後如果不用 Last Node 補 root,而是隨便挑一顆 node 搬上去,被挑走的那個位置就會在中間留下一個洞。
兩種情況都會讓 Tree 不再是 Complete Tree,而形狀一旦壞掉,高度就不再保證是 log N。前面兩節的 O(log N) 之所以成立,靠的正是「最多走 Tree 的高度」,但形狀壞掉時,插入與刪除也會跟著退化成 O(N)。換句話說,Last Node 不是實作上隨便挑的慣例,它是讓那兩個 O(log N) 繼續成立的條件。
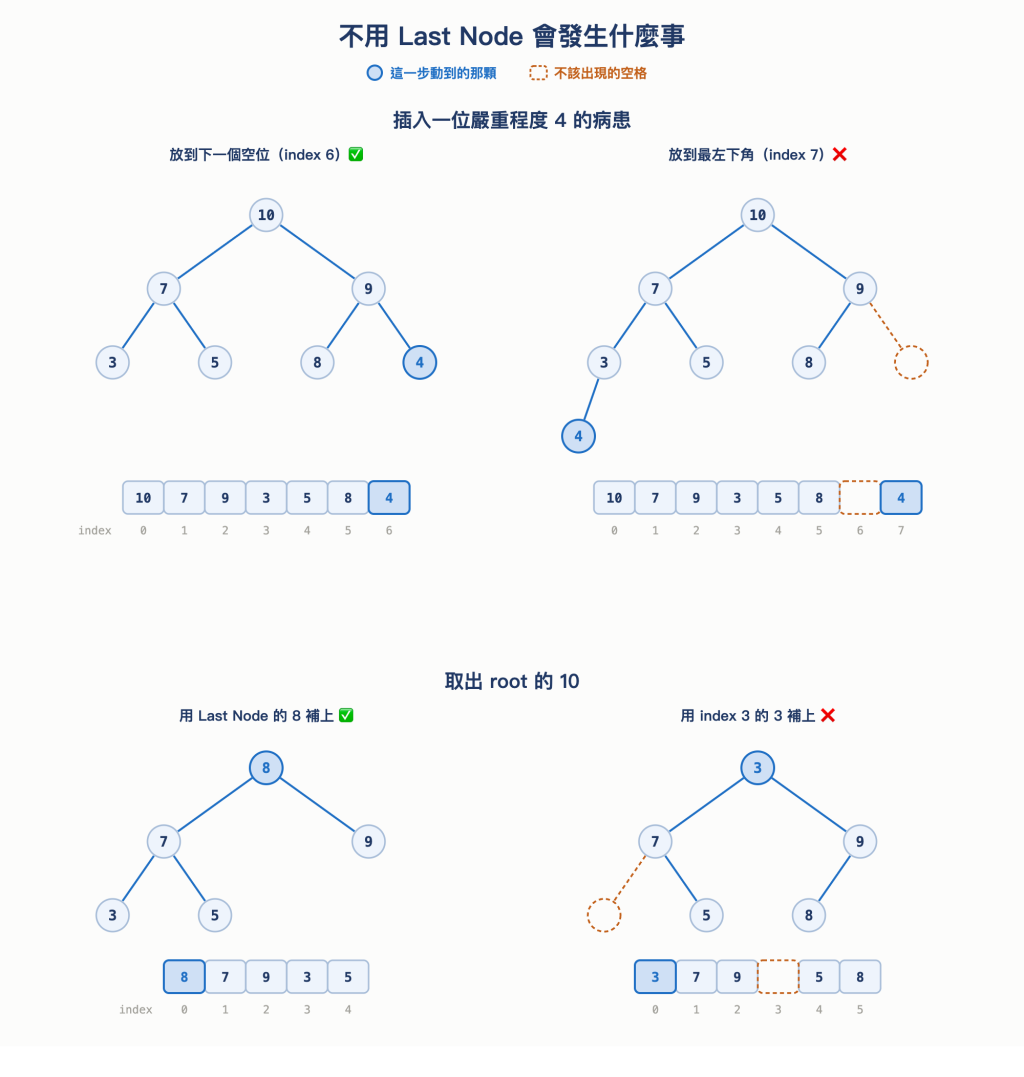
圖 9 不用 Last Node 會發生什麼事
Heap 和 BST 兩種都是 Binary Tree,插入與刪除也都在 O(log N) 這個等級,但它們承諾的事情不一樣,比較如下:
| BST | Heap | |
|---|---|---|
| 規則管什麼 | left 比自己小、right 比自己大 | parent 比 child 大,左右不管 |
| 形狀 | 規則沒管,交給插入順序 | Complete Tree 是規則的一部分 |
| 高度 | 最壞可能退化成 N |
永遠維持在 log N 這個等級 |
| 找任意值 | O(log N),前提是形狀夠矮 |
O(N) |
| 取最大值 | 一路往右走,O(log N) |
直接讀 root,O(1) |
可看出兩者是往不同方向走的。BST 維持的是全域的順序,任何兩顆 node 間的相對位置都是確定的,代價是規則管不到形狀,得另外想辦法維持平衡。Heap 只維持 parent 和 child 間的局部關係,同一層的 node 誰大誰小完全沒有規定,但也因為承諾得少,它才有辦法一起規定 tree 的形狀。這個差別在 Day 21 用過的中序走訪上可明顯看到,BST 中序走訪會得到由小到大的順序,Heap 則排不出順序。
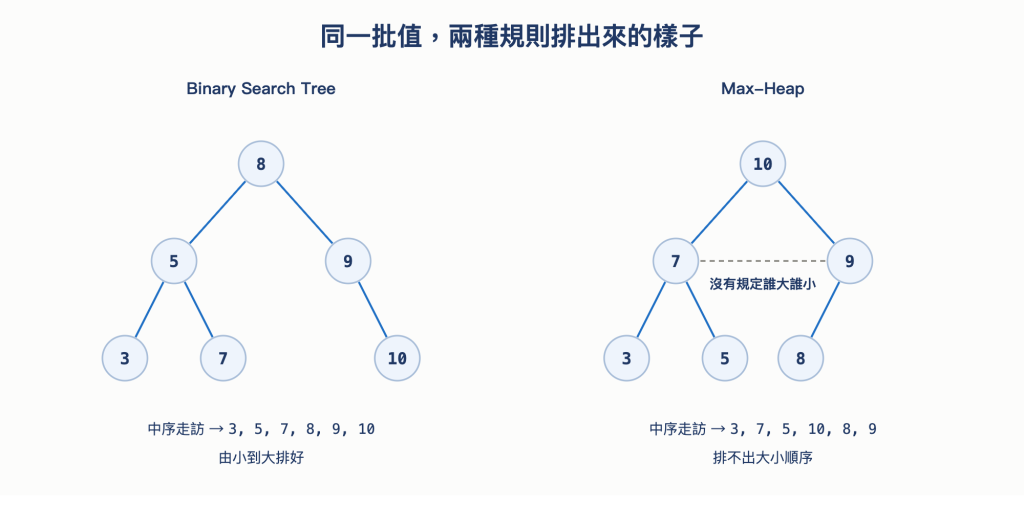
圖 10 同一批值,兩種規則排出來的樣子
setTimeout 底下就是一個 Heap前面說 Priority Queue 是 ADT、底層可以有不同實作,這裡延伸補充~其實在 Node.js 裡有一個現成的例子。(以下補充篇幅有點長,沒興趣的話也可跳過><)
Node.js 的 lib/internal/priority_queue.js 裡有一個 class 就叫 PriorityQueue,而它是什麼,開頭註解第一句就寫了:
// https://github.com/nodejs/node/blob/v24.14.0/lib/internal/priority_queue.js#L3-L7
// The PriorityQueue is a basic implementation of a binary heap that accepts
// a custom sorting function via its constructor. ...
至於它被拿來做什麼,寫在 lib/internal/timers.js 的架構註解裡:
// https://github.com/nodejs/node/blob/v24.14.0/lib/internal/timers.js#L69-L72
// The PriorityQueue — an efficient binary heap implementation that does all
// operations in worst-case O(log n) time — which manages the order of expiring
// Timeout lists ...
也就是說,我們平時在 JS 寫 setTimeout,底下確實用了一個 Heap。而且它是 Min-Heap,因為要先處理的是最早到期的那一個,這也印證了前面說的:Max-Heap 和 Min-Heap 結構相同,把比較的方向反過來就換了一種。不過註解裡的關鍵字是 lists,Heap 裡放的並不是個別的 timer。
在讀原始碼之前,有一件事要先講清楚,上面那句註解說它管的是 expiring Timeout lists 的順序,關鍵字是 lists,因為 Node.js 並沒有把每一個 timer 都丟進 Heap。它是兩層的:
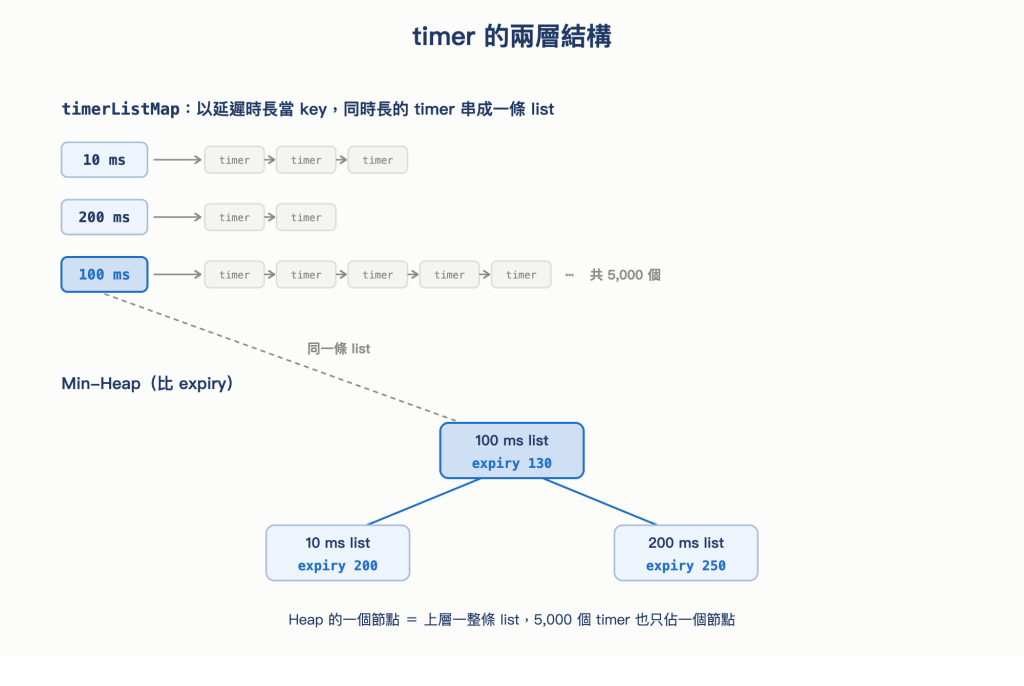
圖 11 timer 的兩層結構
以「延遲的毫秒數」當 key,時長相同的 timer 串成同一條 linked list;而 Heap 裡放的是這些 list,不是個別的 timer。同一條 list 裡的 timer 因為時長一樣,後加入的必定後到期,因此新增只要接在尾巴,是 O(1)。
這裡有兩個時間值容易搞混,延遲時長決定一個 timer 該歸到哪一組,而 Heap 比較的是絕對到期時刻,建立一條 list 時,Node.js 會算出 expiry = 現在 + 延遲時長 存在那條 list 上,Heap 排的就是這個 expiry。所以 Heap 比的是「哪一條會先到時間」。舉例來說,在第 0 毫秒建立的 200ms list,expiry 是 200;而到了第 150 毫秒才建立的 100ms list,expiry 是 250。這時先到期的反而是 200ms 那條,因為它已經等了 150 毫秒、只剩 50 毫秒,而 100ms 那條才剛開始等。
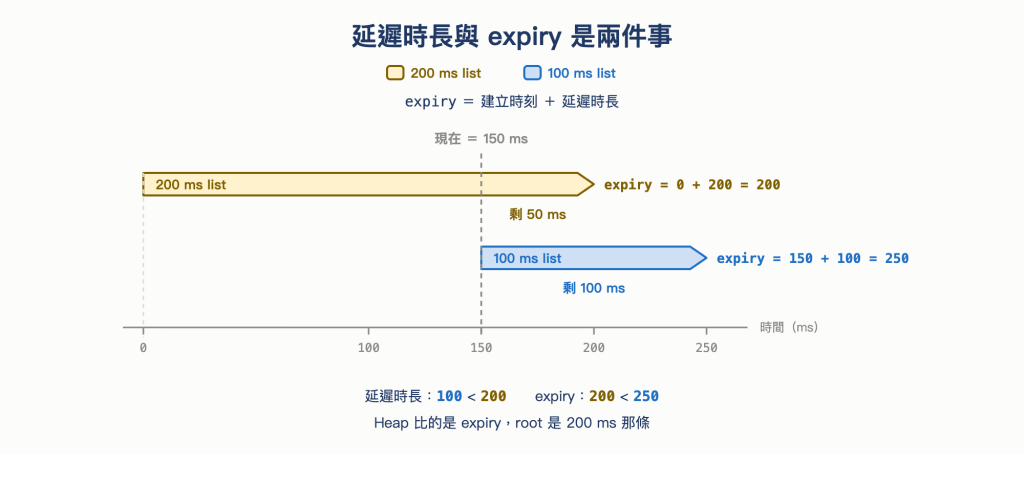
圖 12 延遲時長與 expiry 是兩件事
這代表 Heap 要處理的節點數,是「有幾種不同的延遲」,而不是「有幾個 timer」。開 5,000 個延遲都是 100 毫秒的 timer,只會產生 1 條 list、也就是 Heap 裡 1 個節點;而一條 list 要等到裡面的 timer 都到期才會消失,「目前有幾種延遲」是會累積的,再開三個延遲不同的,就變成 4 條。
有了這理解後,接下來讀原始碼時只要記住一件事:Heap 的每個節點都是一條 list。
// https://github.com/nodejs/node/blob/v24.14.0/lib/internal/priority_queue.js#L9-L20
module.exports = class PriorityQueue {
  #compare = (a, b) => a - b;
  #heap = [undefined, undefined];
  #setPosition;
  #size = 0;

  constructor(comparator, setPosition) {
    if (comparator !== undefined)
      this.#compare = comparator;
    if (setPosition !== undefined)
      this.#setPosition = setPosition;
  }
PriorityQueue 四個欄位各有用意,說明如下:
#compare 是比較規則,預設 (a, b) => a - b,也就是前面說的 Min-Heap,找比較小的#heap 是實際存資料的 Array,開頭放了佔位值、index 0 不使用,等等會說明#size 另外記錄有效資料的筆數,因為 #heap.length 不能代表目前有幾個節點#setPosition 等等解釋,它是這份實作最特別的一段其中 #compare 和 #setPosition 這兩個,constructor 都開放由外面傳進來,而 timers.js 兩個都傳了:
// https://github.com/nodejs/node/blob/v24.14.0/lib/internal/timers.js#L150
const timerListQueue = new PriorityQueue(compareTimersLists, setPosition);
所以實際在跑 timer 的那個 Heap,用的並不是預設的 a - b,而是 compareTimersLists,先比兩條 list 的 expiry,相同時再用 list 的 id 決定先後,避免到期時間一樣的兩條沒有明確順序。這也是為什麼底下每次比較都寫成 compare(...) 而不是直接寫 <,規則是外面決定的。
1 開始用前面自己寫的版本,root 放在 index 0,公式是 2i + 1、2i + 2、(i - 1) / 2。Node.js 選了另一條路:
// https://github.com/nodejs/node/blob/v24.14.0/lib/internal/priority_queue.js#L22-L28
insert(value) {
  const heap = this.#heap;
  const pos = ++this.#size;
  heap[pos] = value;

  this.percolateUp(pos);
}
++this.#size 是先加再用,所以第一筆資料的 pos 是 1,不是 0,而 index 0 那格從頭到尾不放資料,這就是 #heap 一開始就放了佔位值的原因;要知道目前有幾個節點,看的是 #size 而不是 #heap.length。
第 0 格空著看起來浪費,但換來的是更短的公式,和前面那組對照:
| 要找什麼 | 從 0 開始(前面的版本) | 從 1 開始(Node.js) |
|---|---|---|
| left child | 2i + 1 |
pos << 1 |
| right child | 2i + 2 |
(pos << 1) + 1 |
| parent | (i - 1) / 2,小數捨去 |
pos >> 1 |
補充一下,>> 和 << 是位元運算,處理的是數字的二進位表示法。以 5 為例,它的二進位是 101,把每一位往右推一格、最右邊那位掉出去,剩下 10,也就是十進位的 2,剛好是 5 / 2 捨去小數;反過來 3 的二進位是 11,往左推一格變成 110,也就是 6,剛好是 3 × 2。會這樣是因為二進位每往左一位就代表兩倍,整串往右推一格就是除以 2(掉出去的那一位正好是被捨去的小數),往左推一格就是乘 2。回到公式,pos >> 1 就是 pos / 2 捨去小數,pos << 1 就是 2 × pos。減 1 那一步在右欄消失了,因此程式碼只用兩個位元運算就表達得完。
percolateUp:不交換,而是讓空位往上移這是差異最大的地方。前面自己寫的 insert 每往上一層就 swap 一次,而 Node.js 的版本一次都沒有交換:
// https://github.com/nodejs/node/blob/v24.14.0/lib/internal/priority_queue.js#L71-L92(略去 setPosition 相關的行)
percolateUp(pos) {
  const heap = this.#heap;
  const compare = this.#compare;
  const item = heap[pos];

  while (pos > 1) {
    const parent = pos >> 1;
    const parentItem = heap[parent];
    if (compare(parentItem, item) <= 0)
      break;
    heap[pos] = parentItem;
    pos = parent;
  }

  heap[pos] = item;
}
(原始碼在迴圈裡還夾了幾行 setPosition 的呼叫,為了先看清主結構,這裡把它們拿掉了,下面會單獨講。)
這個手法可能有點熟悉,這和 Day 15 的 Insertion Sort 很像,只是方向從左右換成上下:Insertion Sort 是把要插入的值先存進變數暫存,原本那一格就空出來;接著比它大的元素一個個往右挪,空位跟著往左移;最後把暫存的值寫回空著的那一格。
percolateUp 做的是同一件事,先把要移動的值抓出來存進 item,heap[pos] 這一格就空出來了;接著每一輪把 parent 的值搬進空位(heap[pos] = parentItem),空位跟著往上移一層(pos = parent);直到 compare(parentItem, item) <= 0、也就是 parent 已經比 item 小時 break。迴圈結束後 pos 停在空位上,最後一行 heap[pos] = item 才把值放進去。
要注意的是,程式碼從頭到尾沒有真的把那一格清空,舊值還留在裡面。說它「空」,指的是那一格接下來一定會被蓋掉,讀它沒有意義。
這裡的差別在資料搬移的次數,以演算法層來數,交換一次要三步:把 A 存到暫存、B 蓋到 A、暫存再蓋到 B。而留空位的做法每一層只把 parent 往下搬一格,走到底之後才把 item 寫回去一次。以走 3 層為例,交換版是 9 次搬移、空位版是 4 次,而兩者的結果完全一樣:
把最小值從最底層浮到 root(走 3 層)
  交換版 搬移 9 次 → [1,2,6,4,10,12,14,8]
  空位版 搬移 4 次 → [1,2,6,4,10,12,14,8]
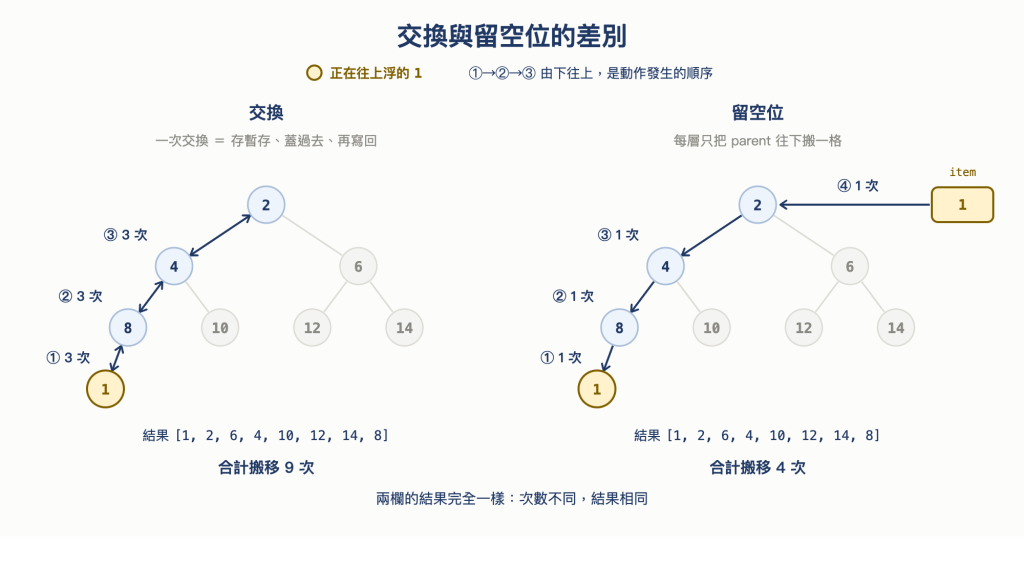
圖 13 交換與留空位的差別
percolateDown:先挑出較小的那個 childpercolateDown 類似前面說的 bubble down,往下沉的方向多了一個判斷,因為要先決定跟哪一個 child 換:
// https://github.com/nodejs/node/blob/v24.14.0/lib/internal/priority_queue.js#L38-L69
percolateDown(pos) {
  const compare = this.#compare;
  const heap = this.#heap;
  const size = this.#size;
  const hsize = size >> 1;
  const item = heap[pos];

  while (pos <= hsize) {
    let child = pos << 1;
    const nextChild = child + 1;
    let childItem = heap[child];

    if (nextChild <= size && compare(heap[nextChild], childItem) < 0) {
      child = nextChild;
      childItem = heap[nextChild];
    }

    if (compare(item, childItem) <= 0) break;

    heap[pos] = childItem;
    pos = child;
  }

  heap[pos] = item;
}
稍微看下 hsize = size >> 1 這一行。照前面說的,>> 就是除以 2 捨去小數,所以 hsize 其實是「目前節點數的一半」,例如 size 是 5 的時候 hsize 是 2。
而這個一半剛好就是「還有 child 的最後一格」,推導很短:index pos 的 left child 在 2 × pos,只要 pos 超過一半,2 × pos 就大於 size,那個 child 根本不存在。index 1 到 hsize 就是有 child 的節點,後面全是 leaf。因此迴圈條件寫成 pos <= hsize,等於一開始就把「會不會走到沒有 child 的地方」排除,不必在迴圈裡反覆檢查邊界。
挑 child 的邏輯則是先假設是 left(let child = pos << 1),再看 right 存不存在、而且是不是更小(nextChild <= size && compare(...) < 0),成立才換過去。這正是前面自己實作時強調的那件事,只是方向相反:Min-Heap 要跟比較小的那個換,Max-Heap 要跟比較大的那個換,理由是同一個,換上來的值必須同時滿足和兩個 child 的關係。
停止條件 compare(item, childItem) <= 0 的意思是,item 已經不比那個「較小的 child」大了,那它自然也不比另一個大,可以停,之後同樣是把較小的 child 往空位搬,最後一行寫回。
setPosition:記住每條 list 在 Heap 裡的位置前面說過 Heap 找任意值是 O(N),因為沒有依據判斷該往哪一邊。而 clearTimeout 平常只需要從 linked list 上拆掉一個 timer,根本不必動到 Heap;但如果被取消的剛好是那條 list 的最後一個 timer,那條空掉的 list 就得從 Heap 移除,而它可能正排在 Heap 中間。如果每次都得掃過整個 Heap 才找到它,那就白費了。
Node.js 的解法是把「它在第幾格」記在那條 list 自己身上。timers.js 建構 PriorityQueue 時傳進去的第二個參數就是這個:
// https://github.com/nodejs/node/blob/v24.14.0/lib/internal/timers.js#L446-L448
function setPosition(node, pos) {
  node.priorityQueuePosition = pos;
}
這函式會被插進前面那兩個迴圈裡。把 percolateUp 完整的原始碼攤開如下:
// https://github.com/nodejs/node/blob/v24.14.0/lib/internal/priority_queue.js#L71-L92
percolateUp(pos) {
  const heap = this.#heap;
  const compare = this.#compare;
  const setPosition = this.#setPosition;
  const hasSetPosition = setPosition !== undefined;
  const item = heap[pos];

  while (pos > 1) {
    const parent = pos >> 1;
    const parentItem = heap[parent];
    if (compare(parentItem, item) <= 0)
      break;
    heap[pos] = parentItem;
    if (hasSetPosition)
      setPosition(parentItem, pos);
    pos = parent;
  }

  heap[pos] = item;
  if (hasSetPosition)
    setPosition(item, pos);
}
每當一個值被搬到新位置,就搭配一次 setPosition,讓它身上的 priorityQueuePosition 跟著更新,不會有記錄和實際位置不一致的時候。percolateDown 也是這樣,只是兩者呼叫的先後略有不同。
這讓我想到 Day 10 提的 intrusive list,感覺是類似思路,都把和容器有關的資訊放在資料自己身上,差別在 intrusive list 嵌進去的是 node 本體,指標本身就是結構、不會有不一致的問題;而這裡記的是位置的副本,同一件事在陣列和物件上各存了一份,才需要 setPosition 一路跟著維護。
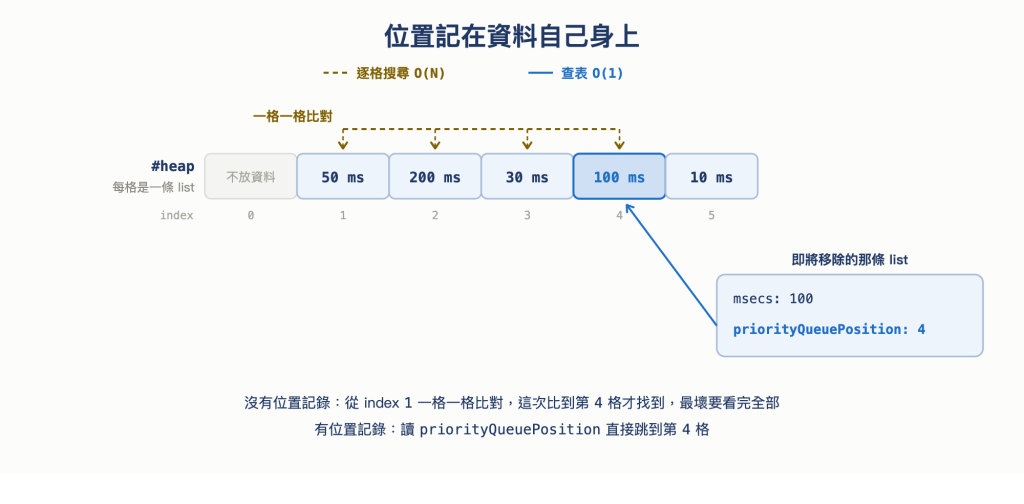
圖 14 位置記在資料自己身上
於是要移除時不必搜尋,直接讀出位置再交給 removeAt:
// https://github.com/nodejs/node/blob/v24.14.0/lib/internal/priority_queue.js#L94-L107
removeAt(pos) {
  const heap = this.#heap;
  let size = this.#size;
  heap[pos] = heap[size];
  heap[size] = undefined;
  size = --this.#size;

  if (size > 0 && pos <= size) {
    if (pos > 1 && this.#compare(heap[pos >> 1], heap[pos]) > 0)
      this.percolateUp(pos);
    else
      this.percolateDown(pos);
  }
}
removeAt 的前三行和前面自己寫的 extractMax 是相同作法:拿最後一格的值補到要移除的位置,再把尾端清空,差別在它移除的不一定是 root,而是任意位置,因此補上來的那個值可能太小、也可能太大,比 parent 小就要往上浮,否則往下沉,這就是那個 if / else 在判斷的事。
那 clearTimeout 呢?以一般的 setTimeout 為例,流程在 lib/timers.js:
// https://github.com/nodejs/node/blob/v24.14.0/lib/timers.js#L82-L97(省略中間的註解與 debug 呼叫)
  L.remove(item);
  ...
    const list = timerListMap[msecs];
    if (list !== undefined && L.isEmpty(list)) {
      timerListQueue.removeAt(list.priorityQueuePosition);
      delete timerListMap[list.msecs];
    }
先 L.remove(item) 把那個 timer 從它所屬的 linked list 上拆掉,這一步是 O(1),而且根本沒碰到 Heap。只有當這條 list 因此空掉了,才需要把整條 list 從 Heap 移除,這時就直接讀它身上記好的 priorityQueuePosition 交給 removeAt,不必搜尋。
精確地說,Heap 找任意值是 O(N) 這件事並沒有被推翻,Node.js 是在 Heap 外面自己補了一份位置記錄,把搜尋換成查表。而移除一條 list 的成本是 O(log D),這裡的 D 是目前還有 timer 在等的延遲種數,也就是 Heap 現在的節點數。一條 list 空掉之後會連同 timerListMap 上的 key 一起被刪掉,所以 D 不會累積成「程式跑過的所有延遲種類」。這也看到一個很有趣的思考角度,結構本身缺的能力,有時不必換結構,補一層記錄就夠了。
最後,同樣是「每次取出最優先的那個」,作業系統挑下個要執行的工作時也在做這件事,但 Linux 的 CFS 排程器用的是 Day 21 提過的 Red-Black Tree,不是 Heap。可見 Priority Queue 只描述要做到什麼,用什麼結構做到是另一回事。
Day 18 比較了五個排序演算法,今天認識 Heap 後,可以再補一個排序演算法進去。
既然每次 extractMax 都會拿到目前最大的值,那把資料全部插進 Heap,再一個一個取出來放進新的 Array,取出的順序自然就是由大到小,這個做法叫做 Heap Sort。用前面那批數字跑一次,插入 8、5、9、3、7、10 之後逐一取出,會得到 [10, 9, 8, 7, 5, 3]。Max-Heap 得到的是降冪,換成 Min-Heap 就是升冪。
放回 Day 18 的框架來看,它有三個結論:
O(N log N)。插入 N 個值、每次 O(log N),取出也是同樣的次數與成本。O(N) 的額外空間,因為結果放在另一個 Array 裡。Node.js 那個比較函式就處理過這件事,它先比到期時間,時間相同時再比 id,讓先建立的 timer 先到期,這說明如果順序真的重要,就得自己在比較的規則裡補上。
小小總結一下今天對 Heap 的認識~
O(N),而那份完整順序在急診室叫號時其實用不到。Heap 只維持一條夠用的規則,讓插入和取出都落在 O(log N)。O(N),換到的是 O(1) 讀取最大值。實際使用時,還可以記住幾件事~
2i + 1 那組是從 0 開始的版本,從 1 開始就會是另一組圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。
lib/internal/priority_queue.js(v24.14.0)
lib/internal/timers.js(v24.14.0,檔頭的架構註解)


 iThome鐵人賽
 看影片追技術