
昨天用 inorder 遍歷主例那棵 Tree 時,輸出的是 1, 4, 6, 9, 15, 20, 170,剛好由小到大。當時只說這不是巧合,這裡面有些規則,今天就來看看那規則是什麼~
之前介紹 Binary Search 時,有提到它搜尋比較快的原因是每次比較都能排除一半,前提是資料必須先排好;介紹 Array 時也提過,一個排好的 Array 想在中間插入一筆資料,沒有想像中簡單。由此可知,「已排序」這狀態本身很有用,但維持它要付出成本,資料一旦頻繁變動,光要維持順序,要花的力氣可能比搜尋省下的力氣還多。
那有沒有辦法讓資料一直維持排序,又不必在每次插入時搬動一整排元素呢?
假設現在有個排好的 Array [1, 4, 6, 9, 15, 20, 170],現在要把 8 放進去。這件事可以拆成兩步,第一是找插入的位置,這步驟很快,8 應該落在 6 和 9 中間,用 Binary Search 幾步就能得出;真正花時間的是第二步的插入元素,9 之後的四個元素全部得往右挪一格,才空得出那一格給 8,這就是 Day 05 算過的 O(N)。
維護 Array 排序的成本在於,Array 用「位置」來表達順序。1 排在 4 前面,因為它剛好放在 index 比較小的那格,而順序這資訊是被寫進記憶體位置裡的,想改順序就得改位置。Hash Table 則是另個路線,它算出 key 該去哪一格,插入和搜尋都能做到 O(1),但那個位置是雜湊算出來的,和值的大小沒關係,於是 Hash Table 裡面的資料是沒有順序的,想按大小印出所有 key 就只能整份重排一次。
也就是說,如果希望資料維持排序、插入時又不必搬動每個元素,我們需要的是一種同時滿足兩件事的結構:
第一點 Linked List 已經做得到,node 放在記憶體哪裡都可以,順序是靠 next 這條 link 表達的,插入只要改 link,不用搬動既有的 node。它缺的是第二點,一條線走到底只能一個一個看,沒辦法一次排除一半。
而一條線之所以只能一個一個看,是因為每個 node 後面只接著一個 next,走到任何一格都只有一條路可以往下。那如果讓一個 node 可以接兩個呢?
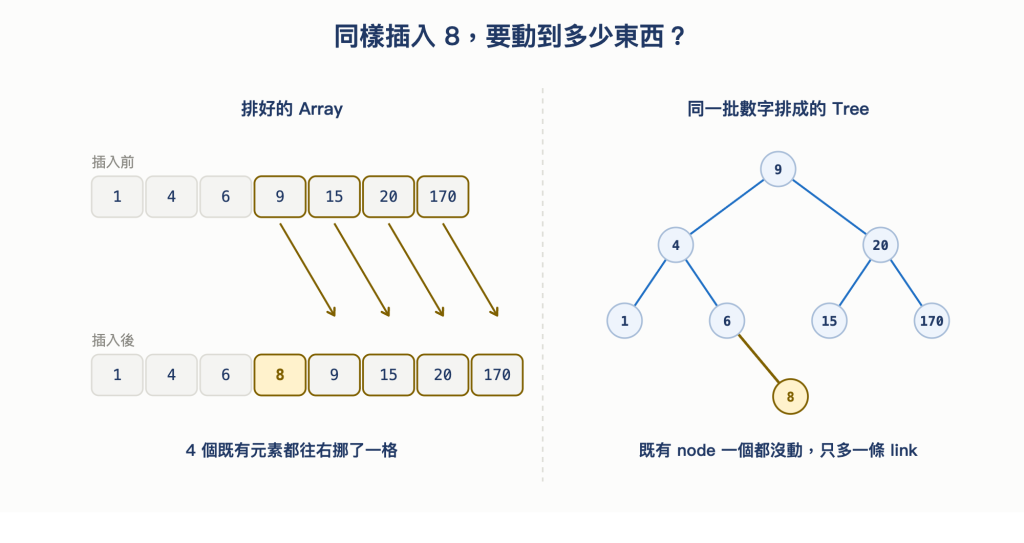
圖 1 同樣插入一個值,Array 要挪動後面每一個元素,Tree 只多接一條 link
昨天的 binary tree 已經有了「每個 node 最多兩個 child」的結構,但當時 node 裡的數字和放置的位置無關,Tree 只表示階層,不表示大小。而 Binary Search Tree 就是在 binary tree 這個結構上加一條關於大小的規則。
一樣先給 Binary Search Tree 一句話定義:
Binary Search Tree (BST) 是一棵 binary tree,而且對每一個 node 來說,它左 subtree 裡的所有值都小於它,右 subtree 裡的所有值都大於它。
回頭看昨天那棵主例 Tree,9 是 root,左邊是 4、1、6,右邊是 15、20、170,左邊三個都小於 9、右邊三個都大於 9;再往下看 4,它的左邊是 1、右邊是 6,一樣成立。這棵 Tree 從頭到尾都符合那條規則,它就是一棵 Binary Search Tree。
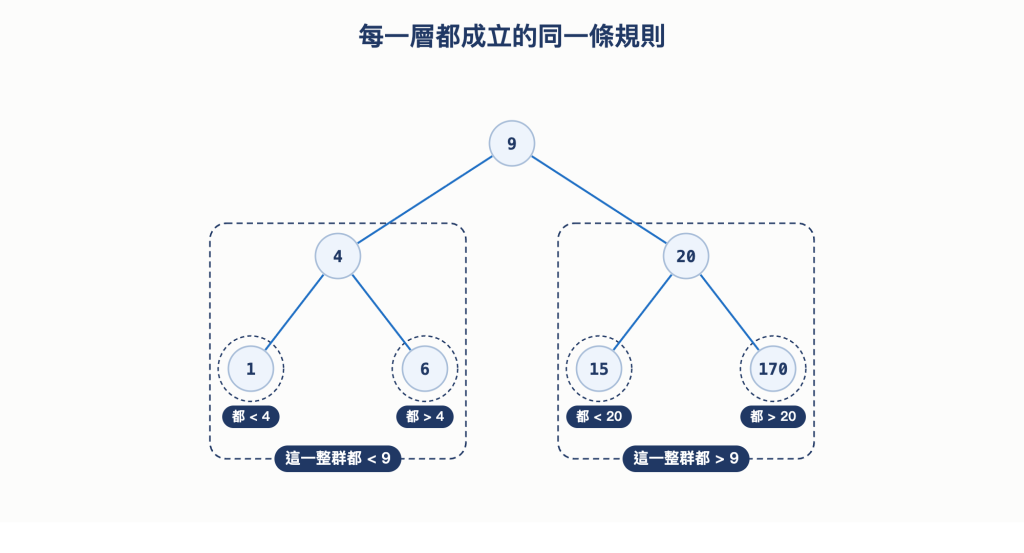
圖 2 昨天那棵主例 Tree,9、4、20 每一顆的左右兩邊都各自守著同一條規則
這條規則有個要注意的地方,它說的是「左 subtree 裡的所有值」,而不是「左 child 這一顆」。這兩種讀法在很多 Tree 上會有相同答案,但它們並不是同一件事。
那只檢查父子關係,會漏掉什麼呢?看看下面這棵 Tree:
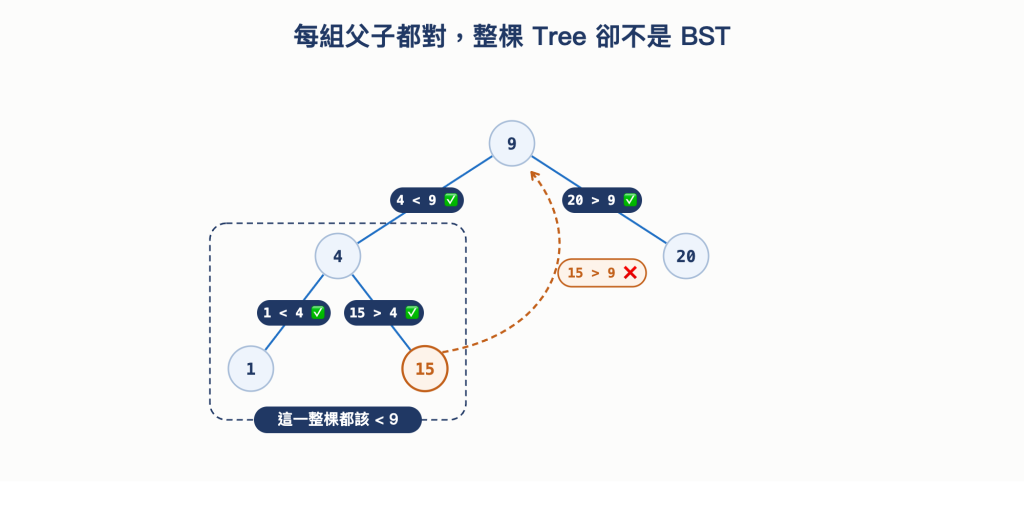
圖 3 四組父子關係逐一檢查都通過,但 15 落在 9 的左邊卻比 9 大
問題出在 15,它落在 9 的左 subtree 裡,卻比 9 大。只檢查父子關係會漏掉這種情況,規則要對整棵 subtree 成立。
這件事重要的原因在於,搜尋時需要倚賴這特性,若在這棵 Tree 上搜尋 15,走到 9 發現 15 > 9 就直接不看左邊,那個不看的理由來自「左 subtree 裡每一個值都比 9 小」,如果規則只保證左 child 比 9 小,這棵 Tree 裡的 15 就會被漏掉。至於要怎麼有系統地驗證一棵 Tree 有沒有真的維持住這條規則,之後會再看到~
Binary Search Tree 定義寫的是「小於」和「大於」,那如果要插入的值和某個 node 一模一樣呢?這件事目前各有做法,沒有標準答案,常見的做法有四種:
| 做法 | 換到什麼 | 要注意什麼 |
|---|---|---|
| 不允許重複 | 規則維持嚴格的「左 < node < 右」,後面所有操作都不必處理例外 | 插入已存在的值時要決定是忽略還是覆蓋 |
| 相等的往左放 | 規則放寬成「左 ≤ node < 右」 | 刪除時要補的那個 node 也必須從左邊挑,否則相等的值會跑到錯的一側 |
| 相等的往右放 | 規則放寬成「左 < node ≤ 右」 | 同一個值重複很多次時,那些 node 會沿著同一側往下疊,把 Tree 拉長 |
| node 自己存一個計數 | 重複的值不佔 node,只把 node 上的數字加一 | 每個 node 要多存一個欄位,刪除時要先減計數再考慮拆掉 node |
第三種和第四種的差別是 Tree 的 height。BST 的操作成本幾乎都取決於 height,如果重複的值會生出新的 node,一份有大量重複值的資料就會把某一側拉得很長;改成在 node 上記次數,不管同一個值出現幾次,Tree 的高度都不會被拉長。
今天的文章都採用第一種策略,也就是不允許重複,插入一個已經存在的值時什麼都不做。這樣「左 < node < 右」就是一條沒有例外的規則,接下來的搜尋、插入、刪除、inorder 四節都不再複述。
規則講完了,接著把結構寫出來~ node 的部分可以直接沿用昨天的 binary tree node,一個值加上左右兩條 link,另外再包一個類別拿 root:
class Node {
  constructor(value) {
    this.value = value;
    this.left = null;
    this.right = null;
  }
}

class BinarySearchTree {
  constructor() {
    this.root = null;
  }
}
BST 和昨天的 binary tree 的資料結構其實一樣。BST 的規則沒有寫在任何一個資料欄位裡,它管的是值被放在哪一顆 node 上,因此光看程式碼分辨不出手上這棵 Tree 是不是 BST,得把整棵 Tree 走過一遍才知道。
有了規則後,來看看如何在 BST 做搜尋,它會從 root 開始,把目標和目前這個 node 相比,相等就找到,比較小就往左走,比較大就往右走,走到沒有 node 可走還沒找到,代表這個值不在 Tree 裡。
以主例那棵 Tree 找 15 為例,整趟只要比較 3 次:
9,15 > 9,所以只可能在右邊。9 的整棵左 subtree 這時就可以完全不看,裡面的 4、1、6 都不必碰20,15 < 20,往左走。20 的右 subtree 那顆 170 也一起被排除15,找到了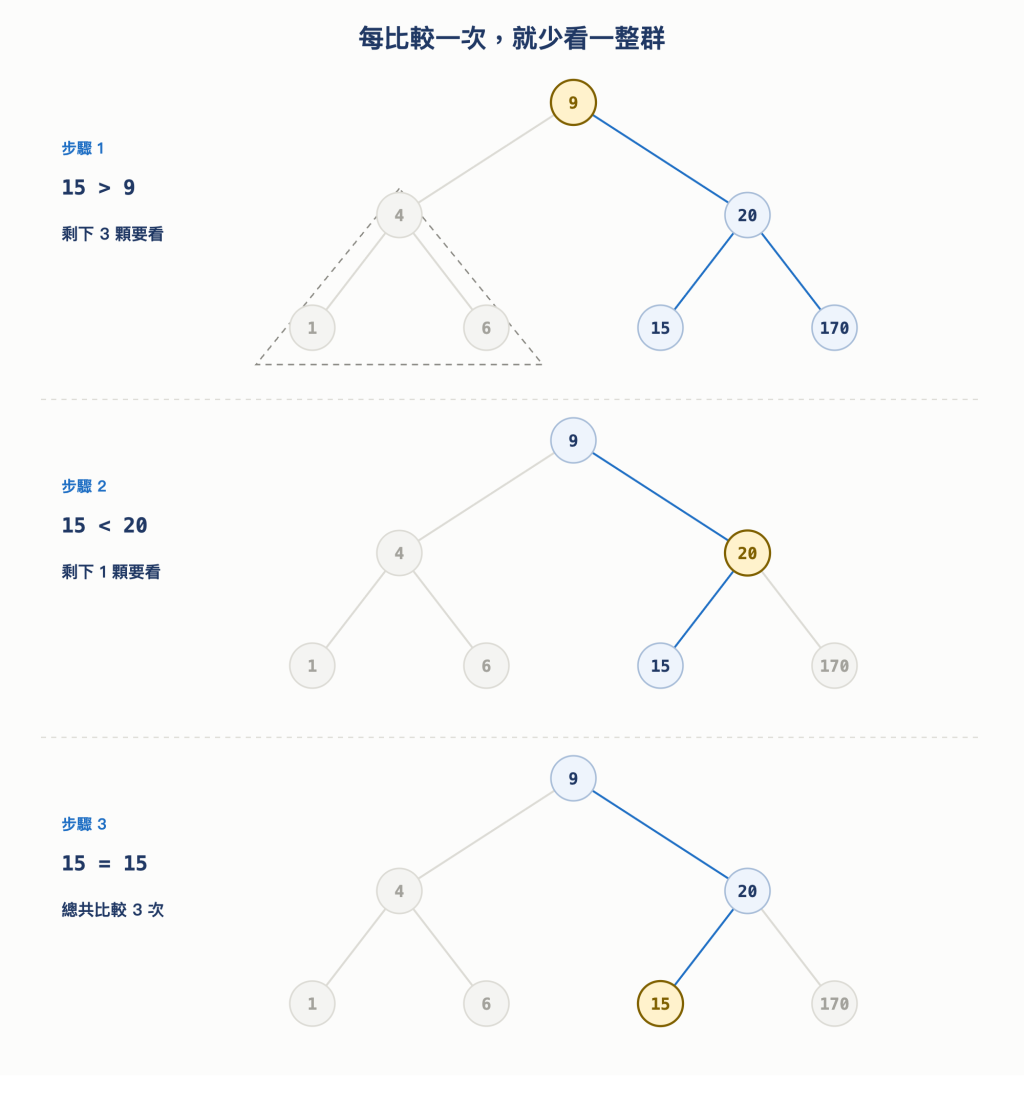
圖 4 搜尋 15 的三個步驟,每比較一次就淡化掉一整群不可能的 node
寫成程式碼如下:
lookup(value) {
  let current = this.root;
  while (current !== null) {
    if (value === current.value) return current;
    current = value < current.value ? current.left : current.right;
  }
  return null;
}
那如果要找的值不在 Tree 裡呢?找 8 的話,8 < 9 往左到 4,8 > 4 往右到 6,8 > 6 再往右,但 6 沒有右 child,於是 current 變成 null,迴圈結束,回傳找不到。
這裡要看的是走過的 node 數量,每比較一次就往下移動一層,最多走幾步取決於這棵 Tree 有幾層,也就是昨天說的 height。搜尋的成本因此是 O(h),而不是 O(N)。
插入和搜尋其實很類似,剛才要找 8 時,我們一路走到 6 的右邊,然後因為那裡是空的而宣告找不到;換個角度看,假設現在要插入 8,那個空位正好就是 8 該待的地方。原因是這條路上每一次往哪邊走,都是由規則決定的,8 比 9 小,不可能在右邊;比 4 大,不可能在 4 的左邊;比 6 大,所以只能在 6 的右邊,一路排除掉不可能的位置,最後只剩那一格。
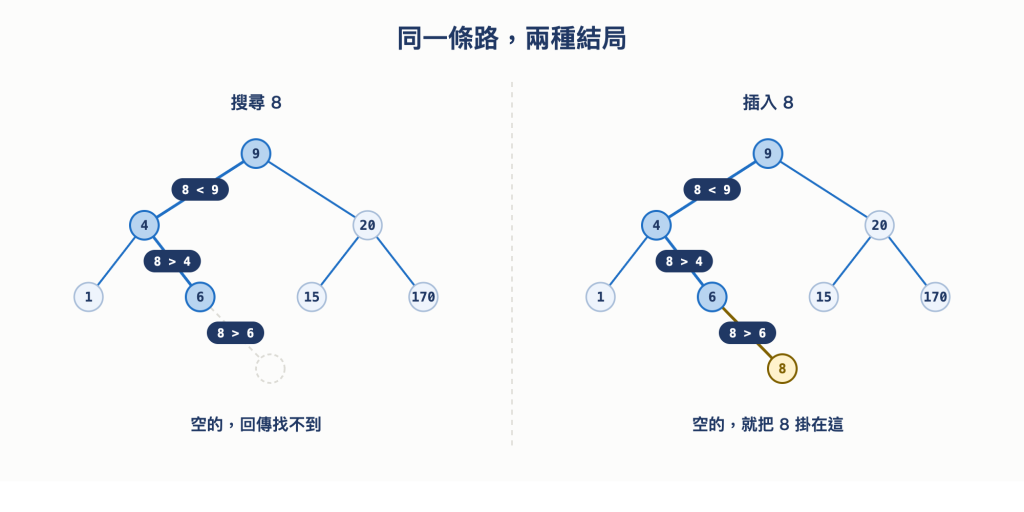
圖 5 搜尋和插入走的是同一條路,差別只在走到空位時是回傳找不到還是掛上去
所以插入就是一次搜尋,只是走到空位時不回傳失敗,而是把新的 node 放上去,程式如下:
insert(value) {
  const node = new Node(value);
  if (this.root === null) {
    this.root = node;
    return this;
  }

  let current = this.root;
  while (true) {
    if (value === current.value) return this;

    if (value < current.value) {
      if (current.left === null) {
        current.left = node;
        return this;
      }
      current = current.left;
    } else {
      if (current.right === null) {
        current.right = node;
        return this;
      }
      current = current.right;
    }
  }
}
開頭那個 this.root === null 處理的是空的 Tree,這時沒有東西可以比較,新的 node 直接當 root。而 value === current.value 就是前面說的重複值政策,遇到已經存在的值直接回傳,不做任何事。
插入的成本和搜尋一樣。找位置是 O(h),找到之後改一條 link 是 O(1),加起來還是 O(h)。而且 8 被插入進去的前後,沒有任何一顆既有的 node 被動到。
刪除是最麻煩的操作,因為被刪除的 node 底下可能還接著其他 node,那些 node 不能跟著一起消失。刪除的流程取決於被刪的 node 有幾個 child,以下分成三種情況來看。
為了解釋刪除會遇到的所有狀況,這一節會改用另一棵 Tree 作為輸入資料:
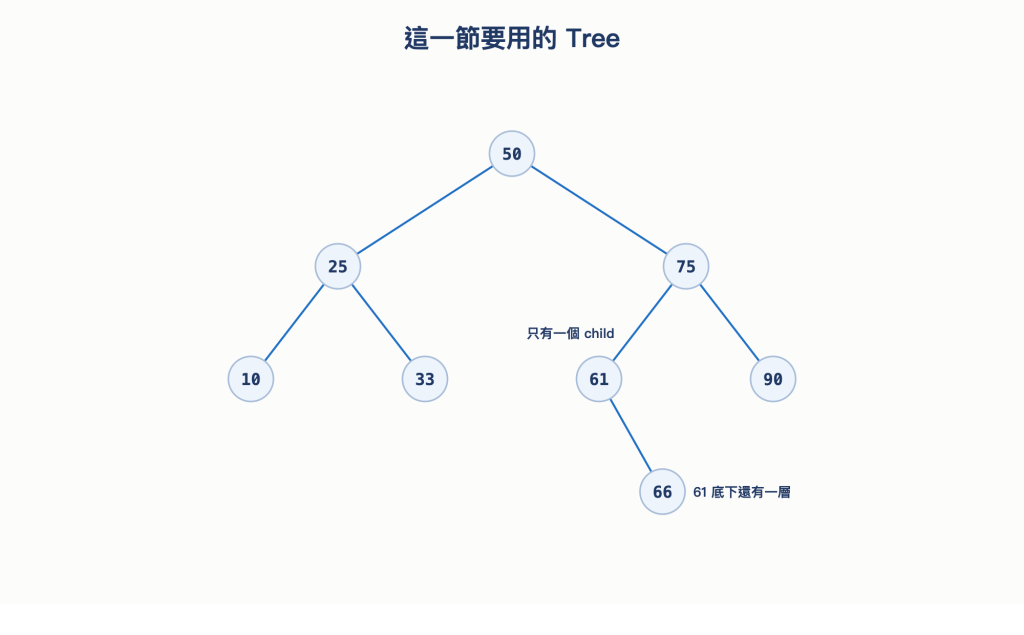
圖 6 這一節的 Tree,61 和 66 這兩處是主例那棵演不出來的
刪 10 是最單純的情形。10 是一顆 leaf,底下沒有接任何東西,把 25 的左邊那條 link 改成空的就結束了,Tree 上其他 node 完全不受影響。
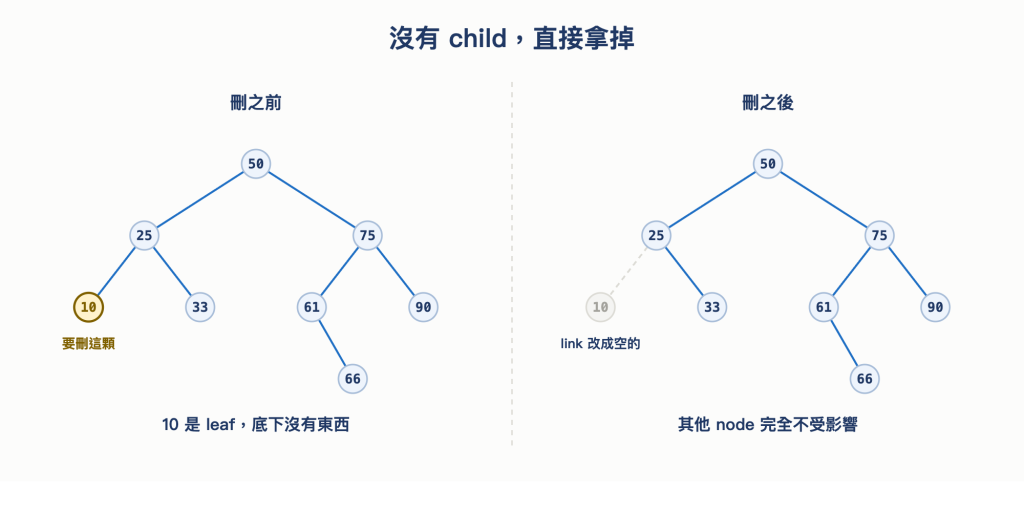
圖 7 10 底下沒有接東西,改掉 25 左邊那條 link 就結束
刪 61 就有事情要處理了。61 底下還接著一個 66,如果只是把 75 的左邊那條 link 拿掉,66 就會連同它斷開,變成一顆再也走不到的 node。正確做法是讓 66 直接補上 61 原本的位置,也就是把 75 的左邊接到 66。
這樣接會不會破壞 BST 的規則呢?不會,因為 66 本來就在 75 的左 subtree 裡,所以它一定小於 75;而 66 原本是 61 的 descendant,61 這一整棵 subtree 的值都落在同一個範圍裡,少掉 61 這顆並不會讓剩下的值跑出那個範圍。
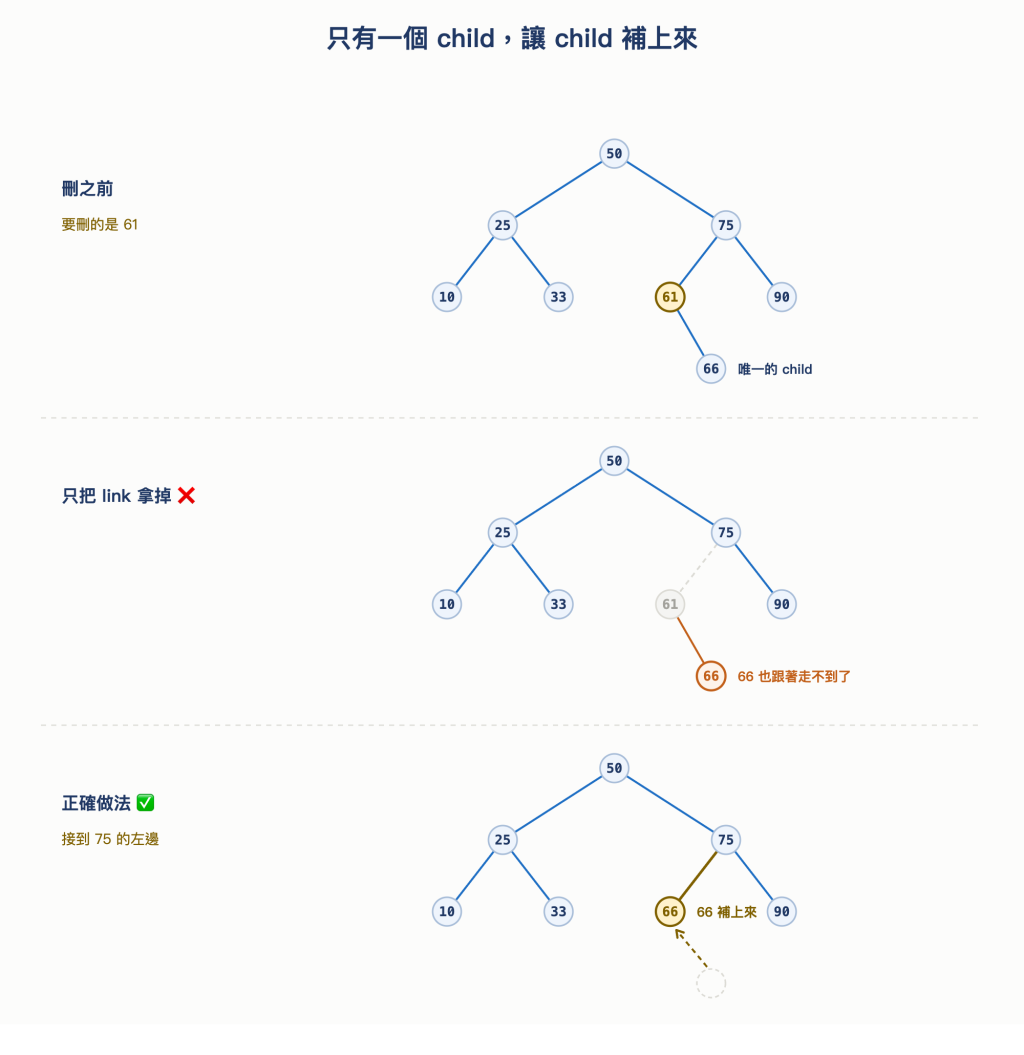
圖 8 只把 link 拿掉的話 66 會斷在外面,所以要讓它補上 61 原本的位置
刪 50 就稍微複雜點。50 是 root,左邊接著 25、右邊接著 75,兩邊都是一整棵 subtree,而 50 空出來的只有一個位置,兩棵不可能同時放上去。
那該放誰上去呢?這個位置有個要求,放上去的那個值必須大於左 subtree 裡的每一個值,同時小於右 subtree 裡的每一個值,否則 BST 規則就被破壞了。左邊是 10, 25, 33、右邊是 61, 66, 75, 90,滿足這個條件的值只能是右邊那組裡最小的 61。
這個值有個名字,叫做後繼節點 (successor),定義是所有大於被刪除值的 node 裡面最小的那一個。把被刪的 node 和它底下所有 descendant 按大小排成一列 10, 25, 33, 50, 61, 66, 75, 90,successor 就是緊接在被刪的值 50 後面的那一個,也就是 61。
實際做法不會把 61 那顆 node 整個搬過去,而是拆成三步:
61 這個值複製到 50 的位置,這一步只搬值,不搬 node61 從右 subtree 裡移除61 只有一個 child,這次移除就是一次 Case 2,66 補上它原本的位置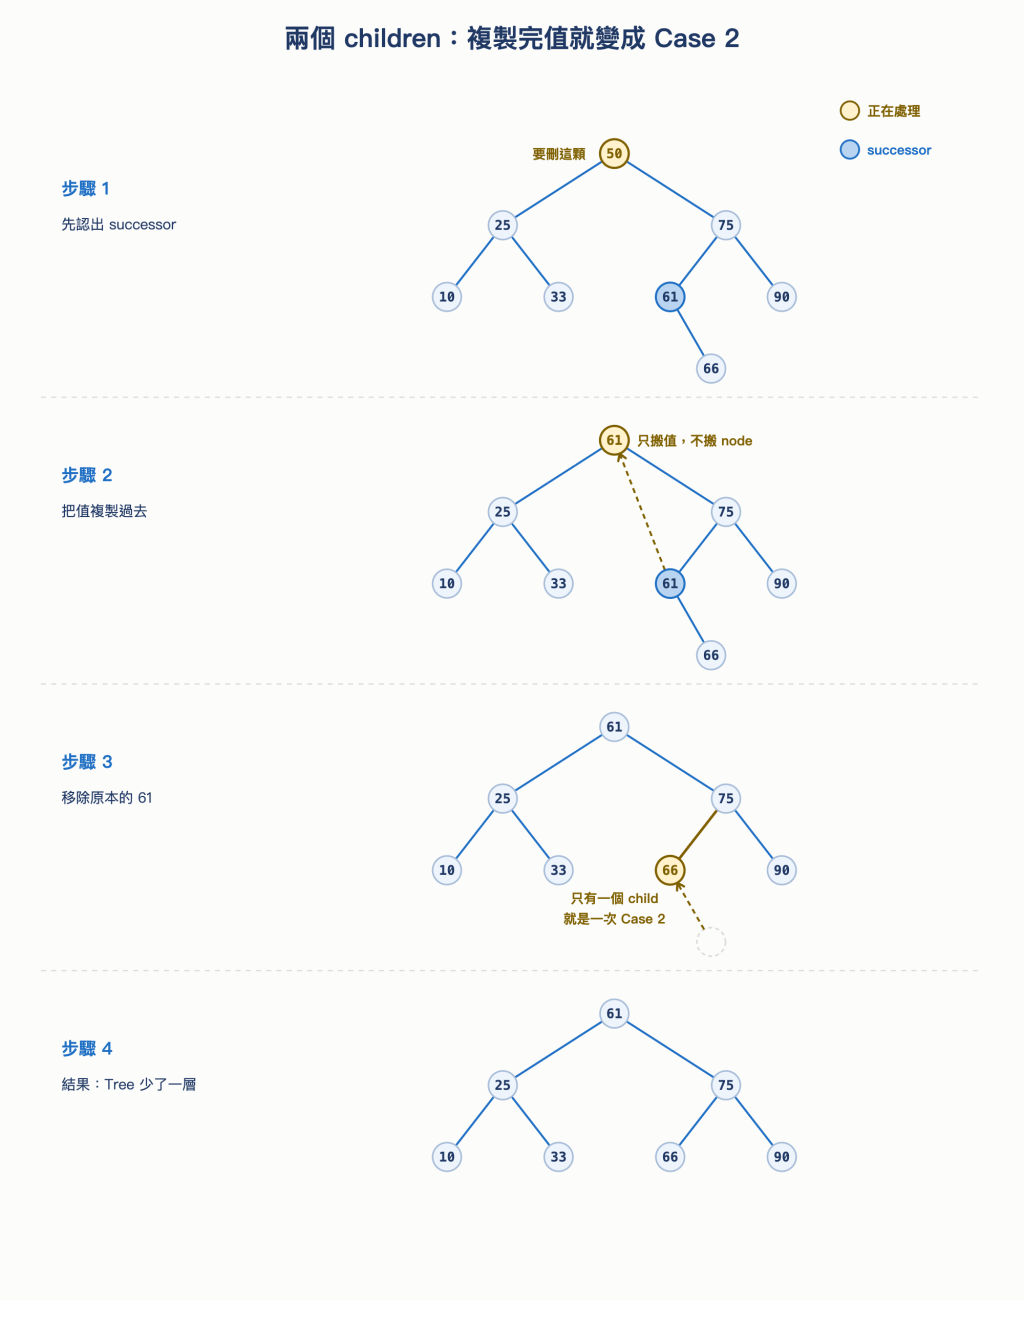
圖 9 Case 3 沒有自己的解法,複製完值之後就變成一次 Case 2 的刪除
但程式裡總不能把所有值排一次序再挑,那要怎麼挑到 successor 呢?這件事在 BST 上有個固定的方法:先往右走一步,接著一路往左走到不能再走,停下來的那個 node 就是 successor。
為何這方法可找到 successor?可將這句話拆成兩部分來看。第一,往右走一步之後所站的整棵 subtree,裡面每一個值都大於被刪的值,這是 BST 的規則,successor 一定在這棵 subtree 裡面;第二,一棵 subtree 裡最小的值一定在它的最左邊,只要目前這個 node 還有左 child,那個 left subtree 裡的值就全都比它小,還沒到底。兩句合起來,右邊那棵 subtree 的最左端就是「所有比被刪除值大的當中最小的」。
以剛才刪 50 為例,往右一步站到 75,再往左到 61,61 沒有左 child,所以 61 就是 successor。
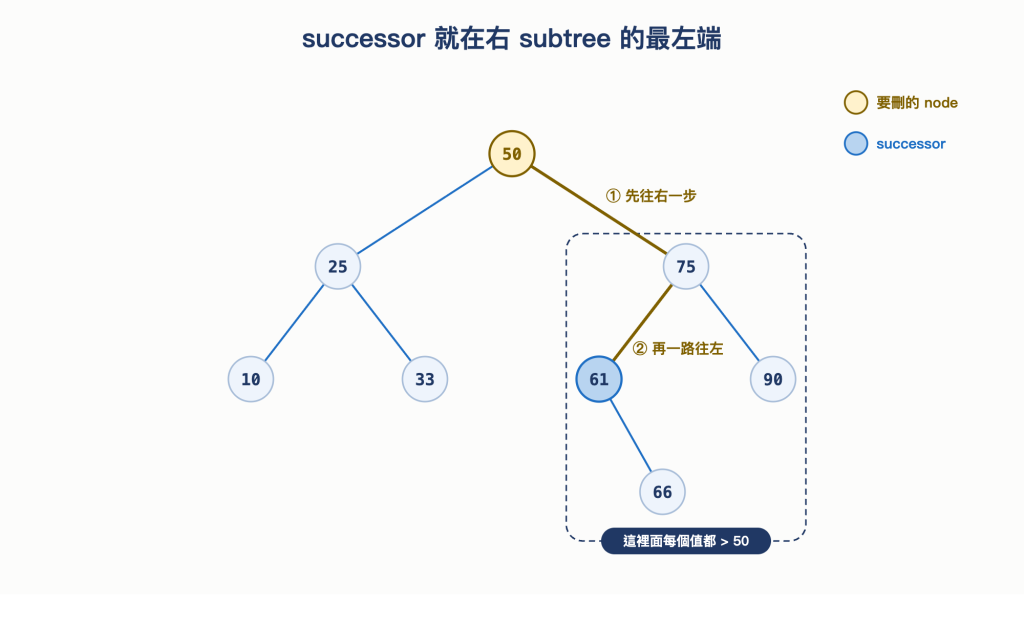
圖 10 successor 就在右 subtree 的最左端
successor 有沒有可能底下還掛著 node 呢?左邊一定沒有,因為它是一路往左走到不能走才停下來的,有左 child 就代表還沒走到底。但有可能有右邊的 child,剛才那棵 Tree 裡的 61 就掛著一個 66。
這時把 61 的值搬走後,那顆原本的 61 要被移除,而 66 不能跟著消失,得接回 61 空出來的位置,也就是變成 75 的左 child。
既然 successor 不可能有左 child,它就只會是沒有 child 或只有一個 child,所以移除它的那一步必定落進 Case 1 或 Case 2。回頭看 Case 3,它其實沒有專屬的做法,而是把值複製過去之後,把問題化簡成「移除 successor 那顆 node」這個更小的同類問題,而這個更小的問題必定是前兩種,只會化簡這一次。
刪除還有一件事沒處理:被刪的 node 消失或被取代後,它的 parent 那條 link 要改指向誰?如果在函式裡去改 parent,就得一路記著自己是從哪裡走下來的、又是從左邊還是右邊接過來的,分支會變得很多。
換個角度想,如果讓刪除函式回傳「這棵 subtree 處理完之後新的 root」,然後由上一層負責把回傳值接回自己的 left 或 right 呢?這樣每一層都只需要管自己這一格,不必知道自己在整棵 Tree 的哪個位置。Day 13 談遞迴時看過這種做法,每一層只回答自己那一小塊,答案在回程時一層層拼起來。以下為完整程式:
remove(value) {
  // 刪掉 root 時整棵 Tree 的 root 會更換,所以結果要指回 this.root
  this.root = removeNode(this.root, value);
  return this;
}
const removeNode = (node, value) => {
  // 走到空的位置,代表這個值不在 Tree 裡
  if (node === null) return null;

  // 還沒找到,往下走,並把處理完的 subtree 接回來
  if (value < node.value) {
    node.left = removeNode(node.left, value);
    return node;
  }
  if (value > node.value) {
    node.right = removeNode(node.right, value);
    return node;
  }

  // 找到了:沒有左 child,就讓右邊補上來(Case 1 和 Case 2 都走這行)
  if (node.left === null) return node.right;
  // 沒有右 child,就讓左邊補上來(Case 2)
  if (node.right === null) return node.left;

  // 兩邊都有,從右 subtree 找 successor 來補(Case 3)
  node.right = lift(node.right, node); // 傳入參數時已經先往右走一步
  return node;
};

const lift = (node, nodeToDelete) => {
  if (node.left !== null) { // 如果左邊還有 node,就繼續往左走
    node.left = lift(node.left, nodeToDelete);
    return node;
  }

  // 走到最左端,這顆就是 successor,successor 的值取代要刪除的 node 的值
  nodeToDelete.value = node.value;
  // successor 的右 child 補上它原本的位置
  return node.right;
};
if (node.left === null) return node.right; 為什麼能同時涵蓋 Case 1 和 Case 2 呢?只有右 child 時回傳右 child,上一層就會把 link 改指向它;而完全沒有 child 時,node.right 本身就是 null,回傳 null,上一層會把 link 改成空的,剛好就是 Case 1 要的結果。Case 1 因此不需要自己的分支。
再來看 lift。它一路往左找到 successor,把值複製回 nodeToDelete,然後回傳 node.right,也就是讓 successor 的右 child 補上它原本的位置。如果 successor 沒有右 child,回傳的就是 null,那條 link 直接變空,同樣不必分開處理。
實際跑一次 remove(50),看看每一層各自回傳了什麼。lift 一路往左走到 61 之後,把 61 寫進 50 那顆 node,然後回傳自己的右 child 66;66 因此被接到 75 的左邊,75 再回傳自己,接回那顆現在裝著 61 的 node 的右邊。注意的是,75 接回去的時候,接回來的還是原本那顆 75,那條 link 前後沒變,改動點之上的每一層都是這樣,接了和沒接一樣,但還是要接。過程中沒有任何一層需要知道自己在整棵 Tree 的什麼位置,也不知道改動發生在哪一層,每一層都只做兩件事,把處理完的結果交給上一層,以及把上一層交回來的東西接到自己身上。
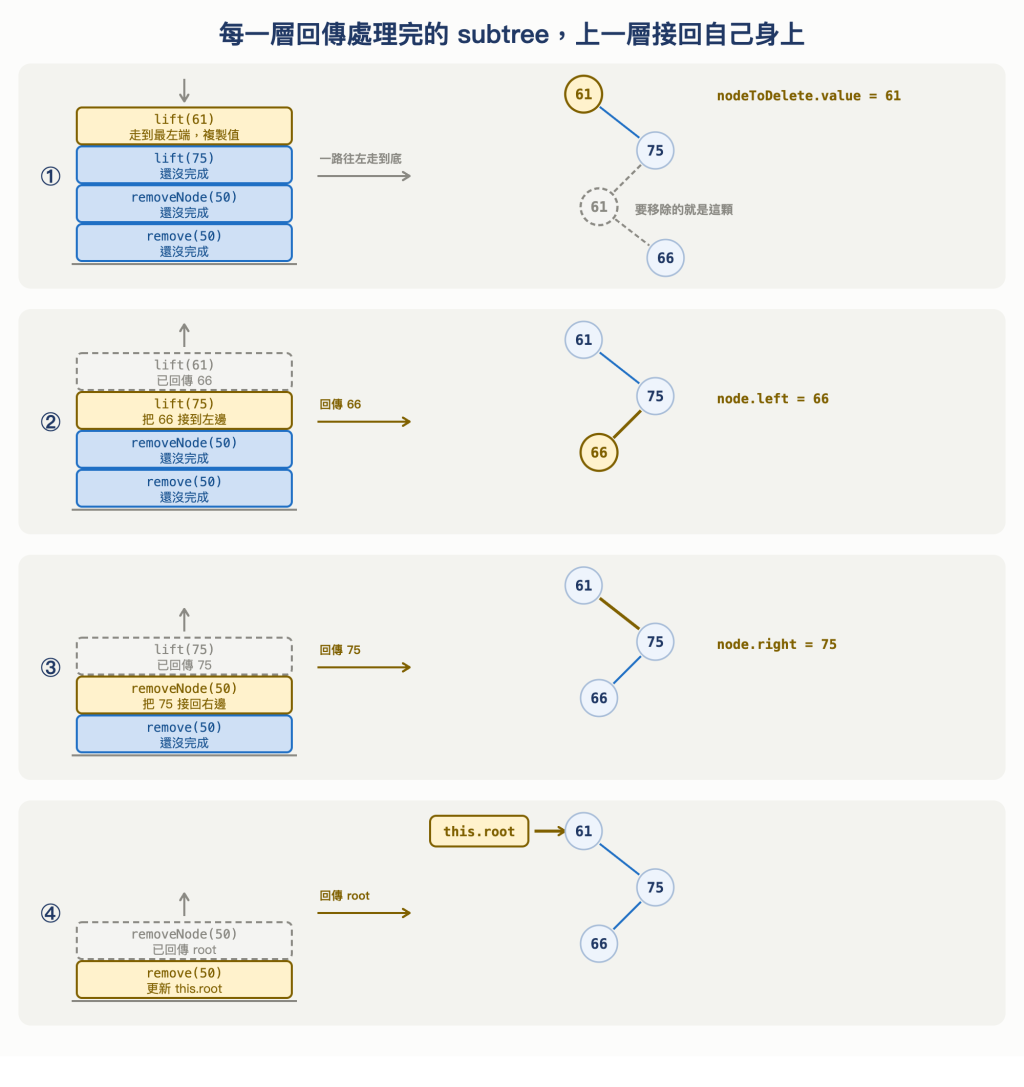
圖 11 每一層只把處理完的 subtree 回傳給上一層,上一層再把它接到自己身上
複雜度方面,刪除要先找到目標,這是搜尋的 O(h);找到之後如果是前兩種情況,改一條 link 是 O(1);如果是第三種,還要走一趟找 successor,那趟最多也是 O(h)。加起來仍是 O(h)。
昨天提 inorder 走訪時,它的規則是「先走完左 subtree,再處理自己,最後走右 subtree」,而 BST 的規則是「左 subtree 全部小於自己,右 subtree 全部大於自己」,把這兩句擺在一起,就知道為何 inorder 是由小到大了:走到任何一個 node 時,比它小的那些值全都排在它前面被處理掉了,比它大的那些則全部排在它後面,因此它被放進結果的那個時機,正好就是它在整個排序裡該在的位置。而這件事對 Tree 上每個 node 都成立,因為 BST 的規則本來就對每個 node 都成立。
inorder() {
  const list = [];

  const walk = (node) => {
    if (node === null) return;
    walk(node.left);
    list.push(node.value);
    walk(node.right);
  };

  walk(this.root);
  return list;
}
拿主例那棵 Tree 跑一次,輸出就是 1, 4, 6, 9, 15, 20, 170。前面提到 Hash Table 沒辦法直接按大小把資料列出來,而 BST 走一次 inorder 就有了。
inorder 成本和昨天算過的相同,是 O(N),每個 node 都要碰到一次,而這和搜尋不同,搜尋只走一條路,因此是 O(h)。
O(log N) 的前提是 Tree 夠矮前面提的搜尋、插入、刪除的時間複雜度都是 O(h),一直沒有換算成 N,現在就來看看 h 到底是多少。
如果一棵 Tree 每一層都盡量填滿,層數和 node 數量的關係如下表:
| 層數 | 填滿時的 node 總數 |
|---|---|
| 1 | 1 |
| 2 | 3 |
| 3 | 7 |
| 4 | 15 |
| 5 | 31 |
每多一層,能裝的 node 數量大約多一倍,反過來說,N 個 node 排成一棵填滿的 Tree 時,層數大約是 log N。搜尋每比較一次就往下一層,最多走 log N 步,前面那些寫成 O(h) 的操作,在這種填滿的 Tree 上就是 O(log N)。之前介紹 Binary Search,每次比較排除掉一半的候選,也一樣是 log N,差別只在 Binary Search 靠 index 算出中間那一格,而 BST 靠的是 root 這顆 node 站在中間的位置。
不過 O(log N) 有個前提,那就是 Tree 真的夠矮。
BST 的形狀不是由裡面有哪些值決定的,而是由插入順序決定的,同樣是 1, 4, 6, 9, 15, 20, 170 這七個數字,照主例那個順序 9, 4, 20, 1, 6, 15, 170 插入,9 先當 root,接著 4 和 20 各佔一邊,最後 4 顆填滿第 3 層,height 是 2;但如果照排好的順序 1, 4, 6, 9, 15, 20, 170 一個一個插入,1 當 root 之後,每一個新來的值都比目前所有的值大,於是全部往右掛,整棵 Tree 縮成一條線,height 變成 6。
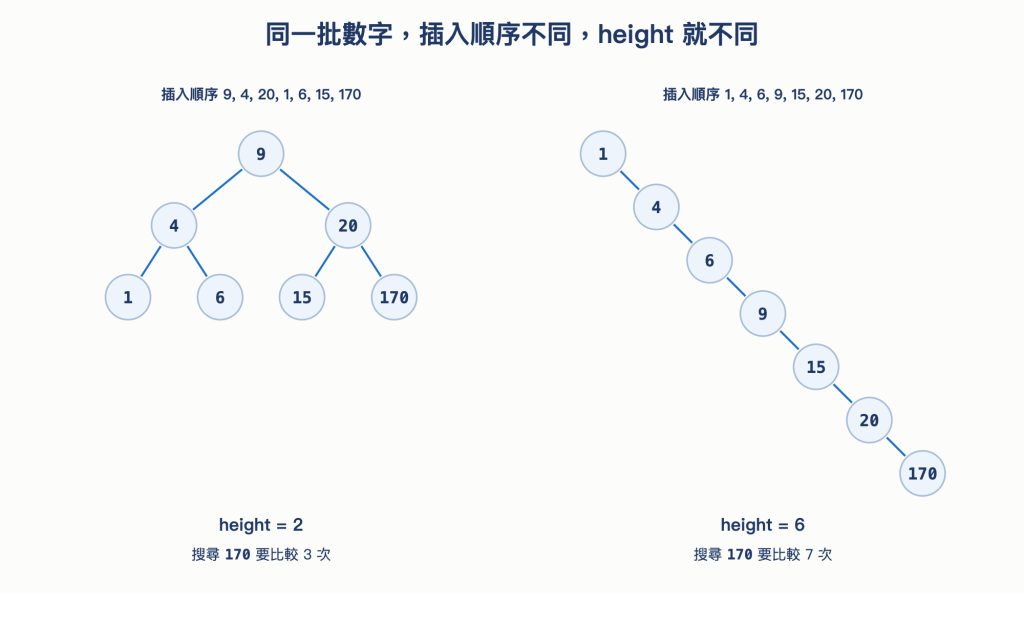
圖 12 同一批七個數字,換一個插入順序,height 從 2 變成 6
比較這兩棵 Tree,差別如下:
| 主例的順序 | 排好的順序 | |
|---|---|---|
| height | 2 | 6 |
搜尋 170 的比較次數 |
3 | 7 |
| search/insert/remove | O(log N) |
O(N) |
照排好的順序插入的那棵 Tree 雖然完全符合 BST 的規則,但它已經沒有 BST 的好處了。每個 node 都只有一個 child,搜尋時每一次比較都只排除掉自己這一顆,沒有任何一整棵 subtree 被排除,這正是 Linked List 在做的事,時間成本回到 O(N)。這種形狀通常叫做傾斜 (skewed)。
也就是說,O(log N) 不是 BST 平白就具備的,它是 Tree 維持得夠平衡 (balanced) 時才成立的結論。而照排序好的資料一筆一筆插入,就是最容易長出一條線的情況,把資料先打亂再插入通常就能長得比較平衡。因此實務上用的通常不是今天這種 BST,而是會在插入和刪除時自己動手調整形狀、把 Tree 維持在矮的狀態的版本。
承上所述,BST 並不是在所有情況下都比排好的 Array 好。資料很少變動、只是一直查詢的話,一個排好的 Array 加上 Binary Search 就夠用了,而且它連續存放,快取的表現通常還更好;BST 的長處在資料會頻繁增刪,又必須隨時維持順序的時候,那時 Array 每次都要搬動一整排元素,BST 只要改幾條 link。
小小總結一下今天對 Binary Search Tree 的認識~
O(1),資料卻沒有順序。當資料既要維持排序、又會頻繁增刪時,這兩種結構都不太合用。O(h),操作成本取決於 Tree 的形狀。實際使用時,還可以記住幾件事~
O(h),只有 inorder 走訪是 O(N),因為前三者只走一條路,inorder 要碰到每一顆 nodeO(log N) 是 Tree 夠平衡時才成立的結論,照排序好的資料一筆一筆插入會長成一條線,那時三個操作都退回 O(N)
O(1) 更直接;需要按大小把資料列出來時才輪到 Binary Search Tree 的 inorder圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術