
這篇把它落實成測試案例,講 AI Agent 的測試案例跟傳統 TC 到底差在哪、預期結果該怎麼寫、驗收標準怎麼定。
以前的測試案例,是明確的規格、明確的動線,預期結果就是一個值。
但 Agent 每次回答都可能不一樣,有可能會跑偏,預期結果就沒辦法寫死。
| 傳統 TC | Agent TC | |
|---|---|---|
| 預期結果 | 明確的值:「顯示『登入成功』」 | 方向:「要提到物流狀態,不可編造日期」 |
| 判定方式 | PASS / FAIL | 固定部分 PASS / FAIL + 方向部分打分數 |
| 通過標準 | 100% 全過 | 達到可接受的分數門檻 |
記住,是「方向」。 因為很難完全控制 AI 會怎麼回答,我們能做的是驗證方向正確,剩下的交給腳本把固定的部分驗死。
用客服 Agent 查訂單當例子:
Test Case:查詢訂單物流狀態
Input:「我的訂單 A123 到哪了?」

【固定驗證】腳本驗證,PASS / FAIL
1. 意圖判斷為「查訂單」
2. 有呼叫「訂單查詢」工具,參數 order_id = A123
3. 工具回傳成功(status_code = 200)

【方向驗證】評估器打分數
Ground Truth:訂單 A123 目前「配送中」
1. 回答有提到物流狀態,且與 Ground Truth 一致 → 正確性 ≥ 0.9
2. 回答切題,沒有答非所問                       → 相關性 ≥ 0.9
3. 沒有編造查詢結果以外的資訊(例如送達日期)  → 幻覺性 ≥ 0.9(1 = 沒有幻覺)
兩段各司其職:
| 固定驗證 | 方向驗證 | |
|---|---|---|
| 驗什麼 | 動線、工具呼叫、參數 | 回答的內容與品質 |
| 用什麼驗 | 腳本 | 評估器 |
| 結果 | 一翻兩瞪眼 | 分數 |
| 從哪裡來 | 讀懂 Agent 架構(Day23) | 評估面向(Day24) |
能放進「固定驗證」的,就不要丟給評估器。 腳本不會幻覺,但評估器有可能會!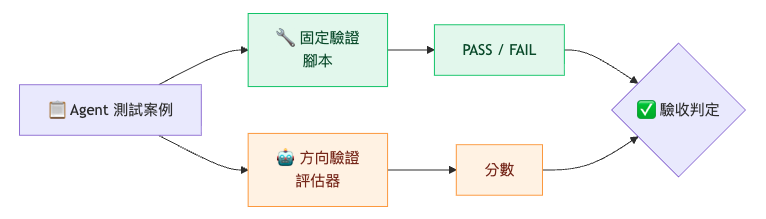
Ground Truth(基準真相)= 你的「預期答案」,就像傳統 QA 對照的規格書。
好的 Ground Truth 有三個特點:
常見的 Ground Truth 來源:
反過來說,沒有明確定義什麼是「對」,就寫不出 Ground Truth,後面的分數也就沒有意義。
Agent 的方向驗證,通常不太可能想以前那樣 100% 全過。
所以驗收通常是看一整批測試案例(例如 100 筆),要用固定驗證+評估氣可接受的分數門檻來綜合判定:
| 部分 | 驗收標準 |
|---|---|
| 固定驗證 | 必須 100% 通過。腳本是確定的,沒有「差不多」這回事 |
| 方向驗證 | 各面向的平均分數達到門檻,例如相關性 ≥ 0.9、幻覺性 ≥ 0.9 |
| 整批通過率 | 例如 ≥ 90% 的案例達標,才算這次可以上線 |
評估器的 1、0.5、0 各代表什麼,沒有標準答案,是團隊自己定義的。
例如「幻覺性」,可以定義成「1 = 有幻覺」,也可以定義成「1 = 沒有幻覺」。
我的建議是:統一 1 = PASS。
| 分數 | 意義 |
|---|---|
| 1.0 | Pass:符合預期 |
| 0.5 | Neutral:部分符合,有爭議 |
| 0.0 | Fail:不符合預期 |
這樣幻覺性 1 分就代表「沒有幻覺」,跟相關性、正確性一樣都是越高越好。
最後的報告攤開來,每個評估器的思路都一致,不用每看一欄就要想一次「這個是越高越好還是越低越好」。
重點不是用哪一種,而是團隊內要溝通好、統一一套規範。
到這裡,概念的部分差不多都鋪完了。
接下來要實際動手:這些測試案例要放在哪裡跑?分數要怎麼算?執行軌跡要去哪裡看?
明天開始用 LangSmith 平台來實際操作一輪。


 iThome鐵人賽
 看影片追技術