
「為什麼同一個問題,AI 每次給的答案都不一樣?」這是企業導入 AI 時最常見的抱怨。多數主管將其歸類為「AI 幻覺」,試圖透過調整模型參數來解決。然而,在 BAIOS 專案近期的一次自體檢查中,我們發現了一個足以令所有治理專家流冷汗的真相:最致命的風險往往不在模型性能,而在於開發者為了「圖方便」而設計的系統架構。
最諷刺的是,這個發現發生在一個專門為了「AI 治理」而開發的系統上。當我們以為自己在建立規範時,其實正親手埋下合規風險的種子。
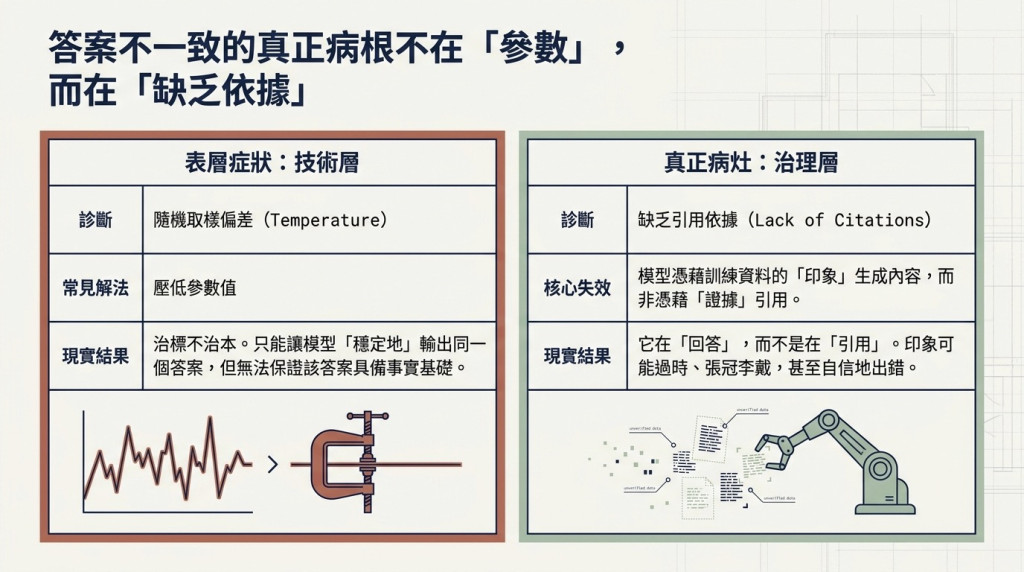
當 AI 出現不一致的回答時,我們習慣從技術層面尋找藥方。但事實上,這存在一個巨大的治理誤區:
這裡隱藏著一個**「偽安全感陷阱」**。如果你只壓低溫度而不提供精確依據,AI 會變得「穩定地講錯話」。這種一致性比隨機的胡言亂語更危險,因為它極難被肉眼察覺,讓使用者誤以為這是經過驗證的標準答案。記住:穩定一個謊言,比得到一個隨機的錯誤答案更具破壞性。
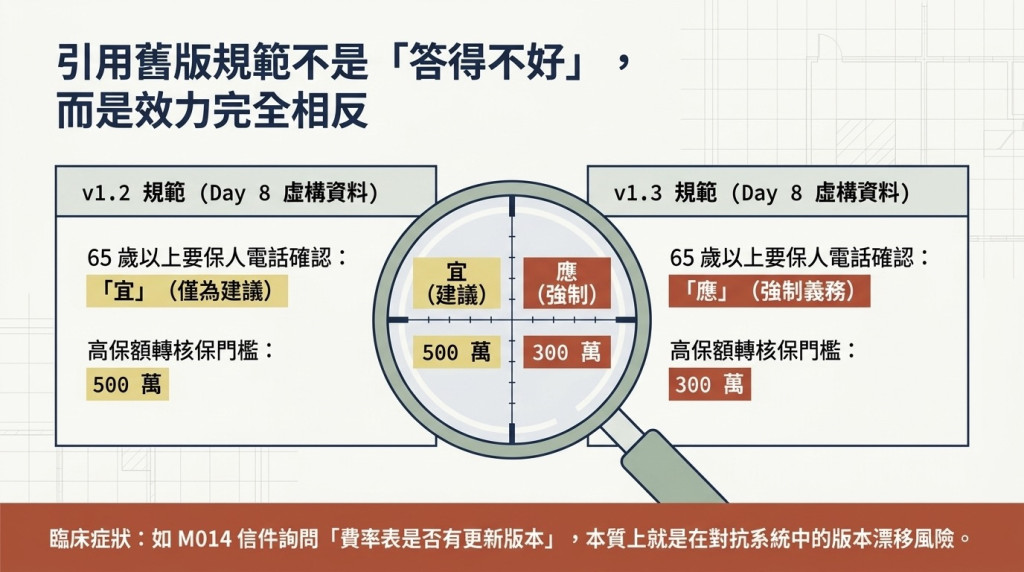
在 BAIOS 專案的測試中,我們對比了兩版虛構規範(v1.2 與 v1.3),揭示了「版本錯誤」如何直接轉化為經營風險。當 AI 引用了僅僅差一個版本的文件,其後果不只是「資訊過時」,而是徹底的「合規失靈」。
| 規範項目 | 虛構規範 v1.2 (舊版) | 虛構規範 v1.3 (新版) | 實質損害與風險 |
|---|---|---|---|
| 65 歲以上投保要求 | 標註為「宜」電話確認 | 標註為「應」電話確認 | 法律責任:將強制義務誤判為建議,導致合規違失 |
| 高保額轉核保門檻 | 門檻為 500 萬 | 門檻為 300 萬 | 財務風險:導致大量應審核件漏查,產生承保漏洞 |
這種「版本漂移」證明了:對於企業而言,知識的時效性與準確性是不可分割的。
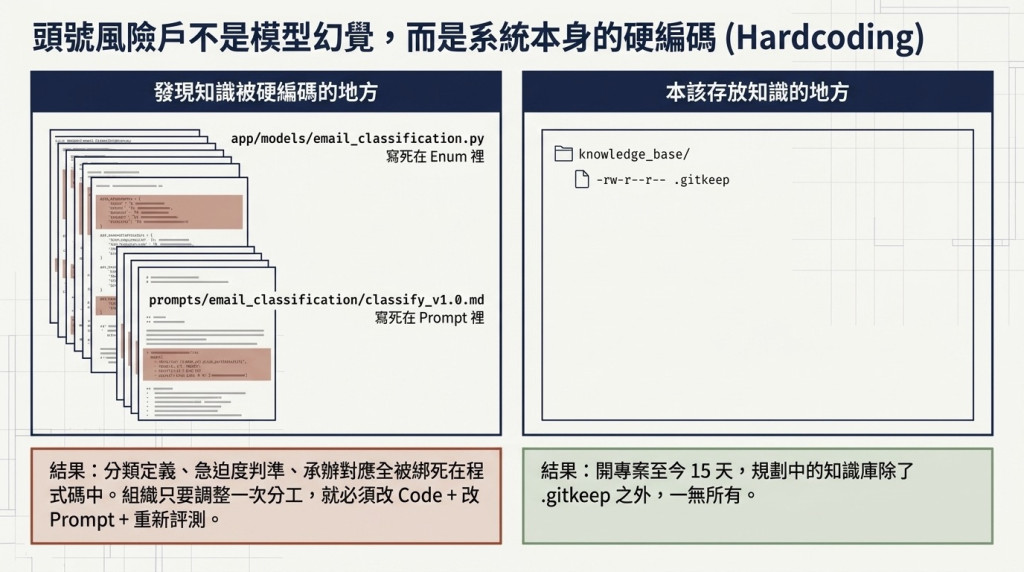
在專案自體檢查中,我們使用 grep 指令追蹤系統內的知識流向,結果令人震驚。一個標榜治理的系統,竟然將極易變動的組織知識直接寫進了程式碼與 Prompt 裡。
=== 「保單行政科」出現在哪些檔案 ===
app/models/email_classification.py ← 程式碼 enum (寫死)
prompts/email_classification/v1.0.md ← Prompt (寫死)
=== knowledge_base 目錄現況 ===
-rw-r--r-- .gitkeep ← 空目錄 (諷刺的現實)
這項發現揭示了一個殘酷的管理真相:知識碎片化並非源於「工具不足」,而是每個當下「最省事的決定」累積出來的產物。
當開發者為了快速上線,將分類定義、急迫度判準直接寫進 Prompt 時,這些知識就變成了**「組織不可見」的黑盒子。合規部門無法審計 Prompt 內容,稽核人員也看不見程式碼裡的 enum。這種「技術捷徑」最終會演變成沉重的技術債**,並隨時引爆為合規風險。
根據我們對 30 封虛構信件的盤點,有 36.7%(11 封)屬於純粹的知識型問題。然而,即使在 M005 這類案例中,系統出現判斷錯誤(表面線索壓過了核心需求),根源並非模型智商不足,而是因為系統中缺乏「客戶權益期限優先」這類明確的優先順序規則。
我們必須意識到:AI 不會創造混亂,它只是在大規模地放大既有的混亂。
如果組織內部缺乏「單一事實來源(SSOT)」,即使 AI 無法處理而轉交人工,人類員工同樣會因為找不到統一依據而給出歧異的答案。引進 AI 前,若不先清理「知識負債」,AI 只會讓企業的失誤效率變得更高。
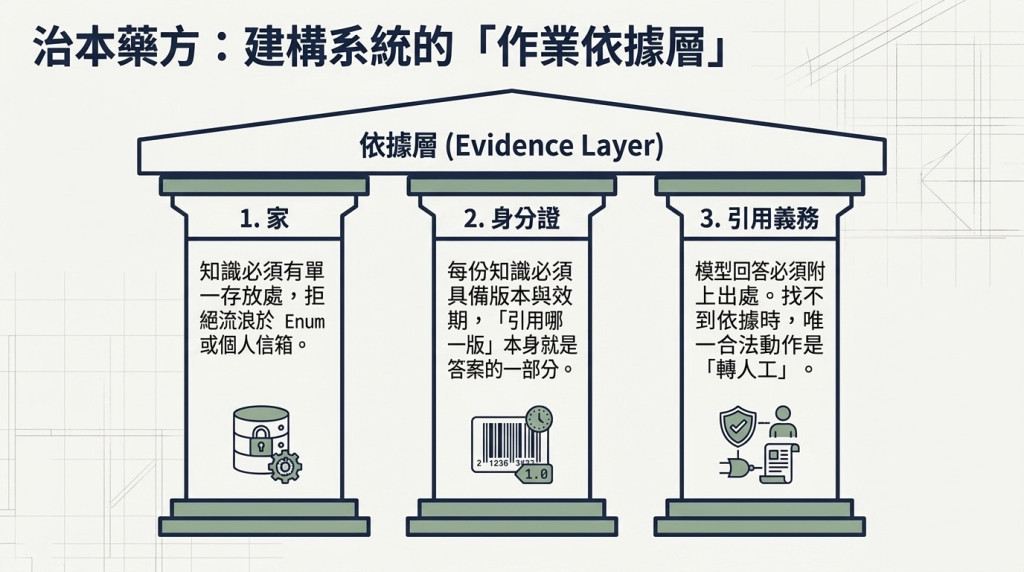
要治癒 AI 的隨機性與幻覺,必須從系統架構層面建立三道防線:
AI 治理的戰場不在模型參數,而在於對「知識管理(Knowledge Management)」的重新審視。如果一個專門做治理的團隊都會因為「圖省事」而將知識流浪在程式碼中,你的組織恐怕也難以倖免。
在投入資源優化 Prompt 之前,請先問自己一個問題:在你的系統或組織中,有多少關鍵知識正以「最省事的方式」,流浪在沒人看得見的程式碼或員工的腦海裡?


 iThome鐵人賽
 看影片追技術