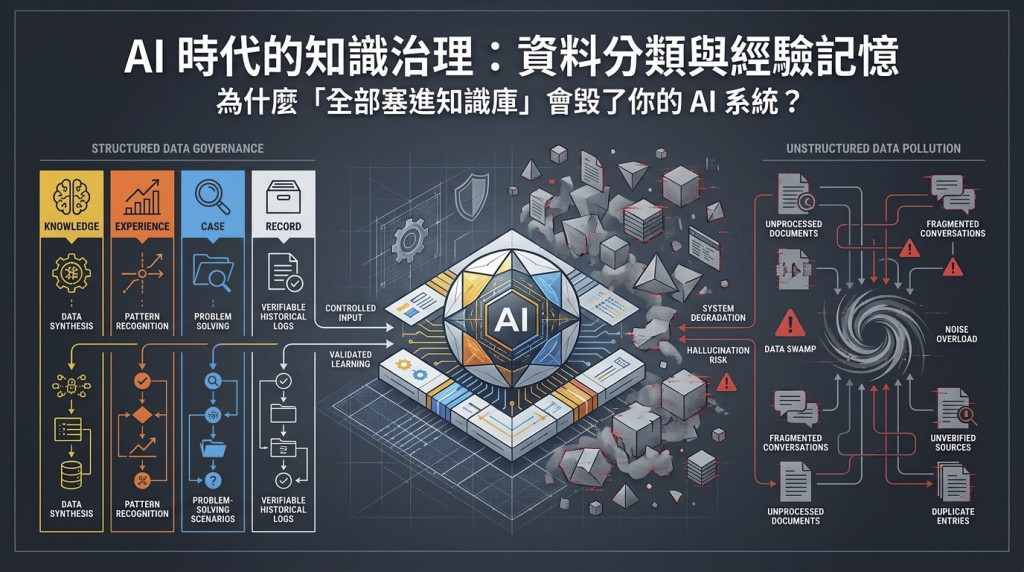
1. 引言:當 AI 開始「以訛傳訛」
在推動企業 AI 轉型的過程中,許多決策者常陷入「資料量即智慧量」的迷思,認為只要將所有對帳結論、審核紀錄與心得通通餵進知識庫,AI 就會變得無所不知。然而,現實往往相反:若缺乏嚴密的過濾機制,AI 會引用過時的統計數據回答當前的問題,甚至將某次偶發的誤判經驗視為標準作業程序。
身為治理顧問,我必須嚴肅提醒:不加分類的資料導入,並不會讓組織變得聰明,反而會導致「以訛傳訛,只是速度變快了」。要讓 AI 真正成為戰力,我們必須在知識庫門口建立四道防火牆,透過「資料分類模型」確保每一筆進入系統的資訊都具備應有的資產價值。
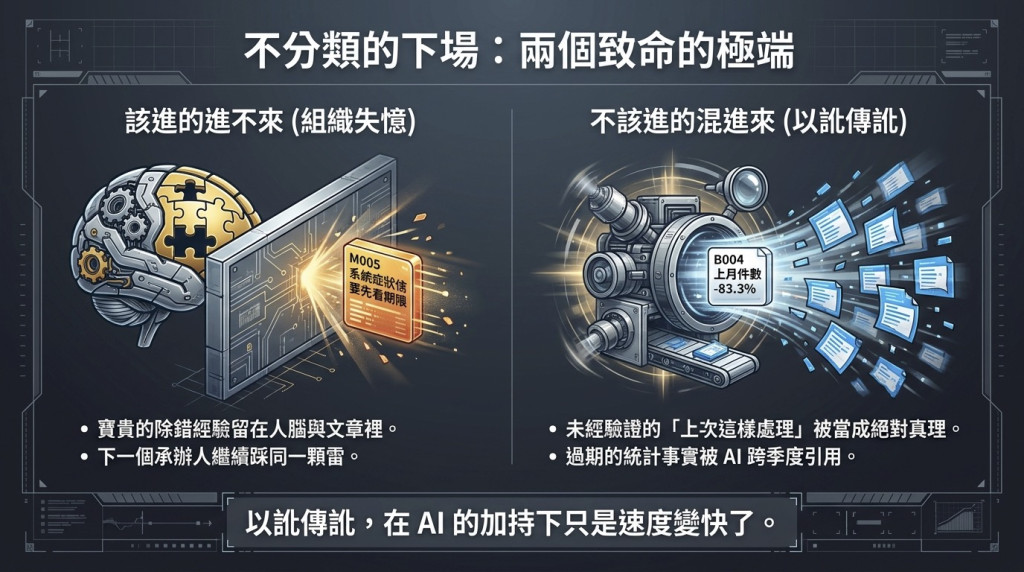
2. 驚人的發現:傳統的二分法為何失效?
傳統資訊管理習慣將資料簡單分為「知識」與「紀錄」。但在 AI 治理的實務走查中,這種二分法會導致嚴重的治理真空。請看以下兩個典型的「高價值灰色地帶」案例:
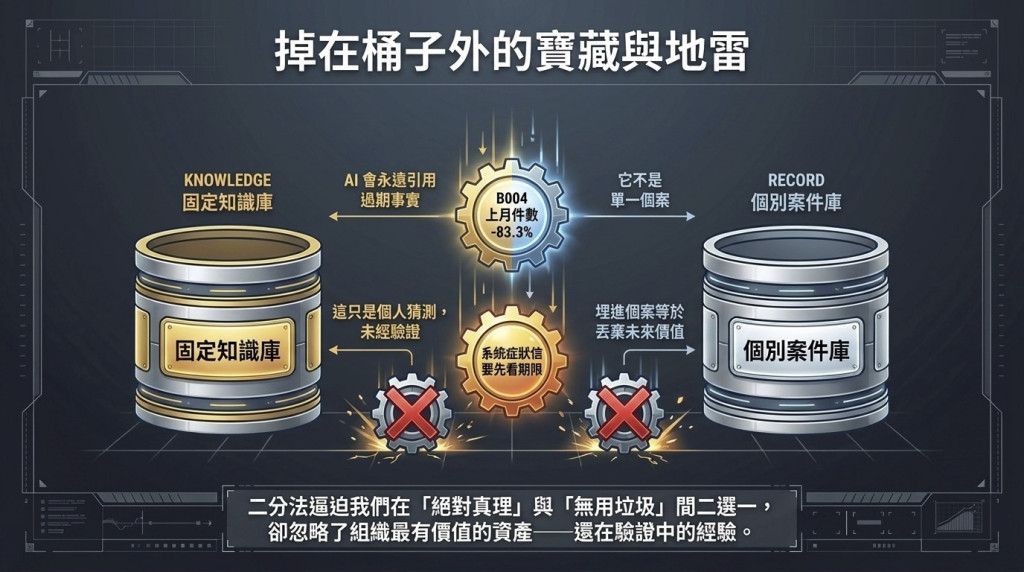
-
案例 B004(統計類事實): 「上月件數下降 83.3%」。若歸類為「知識」,AI 在下一季仍會引用這份過時事實;若視為「紀錄」,它又不屬於任何單一案件,導致寶貴的趨勢觀察被遺忘在角落。
-
案例 M005(經驗類假設): 「系統症狀信要先檢查有無期限」。這是一次誤判後歸納出的教訓。若直接入庫,AI 會將尚未驗證的「猜測」當成「真理」自動化放大;若埋進案件紀錄,則下一個承辦人註定會重複同樣的錯誤。
> 「二分法的問題在於,它逼你在『當成真理』與『當成垃圾』之間二選一——而組織裡最有價值的『歷史經驗』,恰好兩者都不是。」
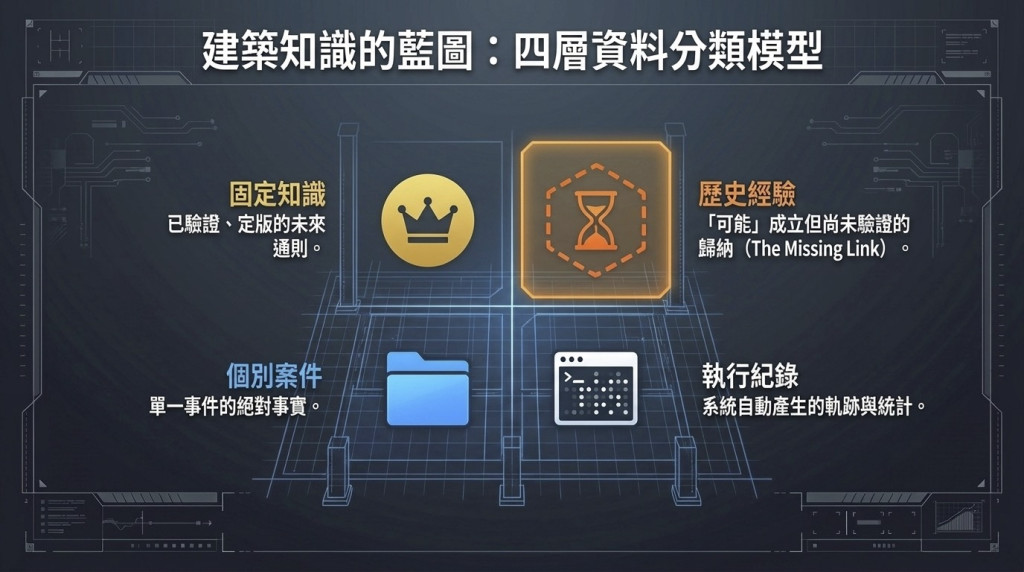
3. 第一個關鍵 takeaway:資料分類的「四分法」模型
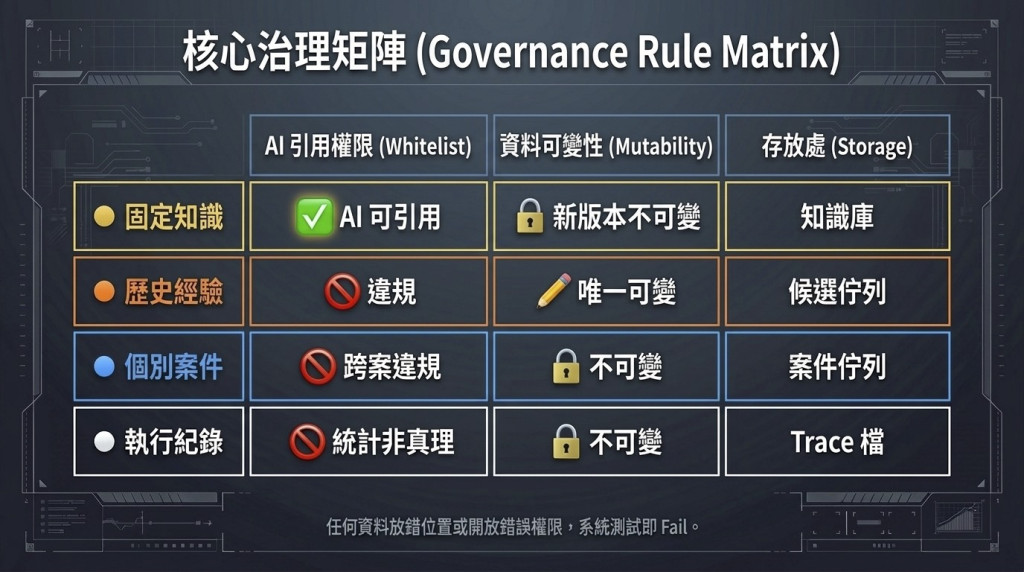
為了達成精準治理,我們必須揚棄二分法,改採「四分法」模型,並為每一類資料制定專屬的治理屬性:
1. 固定知識 (Fixed Knowledge)
-
定義: 已驗證、已定版且具備通用指導意義的標準(如 FAQ、SOP)。
-
治理規則: 不可變動(僅限版本更新);存放於正式知識庫。
-
引用權限: 完全開放 AI 引用。
-
錯置風險: 若誤入過時版本,將導致 AI 提供錯誤決策依據。
2. 個別案件 (Individual Cases)
-
定義: 發生在特定單一案件中的事實與審核軌跡。
-
治理規則: 強制攜帶唯一身分標識(ID)。這是為了防止數據脫離脈絡後,被 AI 誤當成通則。
-
引用權限: 嚴禁跨案引用。
-
錯置風險: 若遺失 ID,個案特例可能被 AI 誤判為組織通則。
3. 歷史經驗 (Historical Experience)
-
定義: 從個案中歸納出的假設或教訓(如 M005),尚在驗證中。
-
治理規則: 唯一具備「可變性」的類別。允許根據新證據修訂,存放於候選知識佇列。
-
引用權限: 升級前禁止 AI 引用。
-
錯置風險: 若直接視為知識,AI 將擴大未經驗證的偏差判斷。
4. 執行紀錄 (Execution Records)
-
定義: 系統自動產生的 Log、軌跡或單期統計數據(如 B004)。
-
治理規則: 不可變動;存放於日誌系統或 Trace 檔。
-
引用權限: 禁止 AI 作為知識引用。
-
錯置風險: 若混入知識庫,會產生「過時數據毒化」現象。
4. 第二個關鍵 takeaway:AI 引用白名單——防範「幻覺」的最後防線
為了從根源消除 AI 幻覺(Hallucination),資料分類模型設有一項強制性的技術約束:AI 引用白名單僅限「固定知識」。
這項規則背後的專業邏輯在於:
-
防止個案污染: A 案的特殊通融原因不能成為處理 B 案的標準。強制禁止跨案引用,能確保 AI 不會因偶發事件而產生邏輯偏移。
-
確保背書權威: 在「歷史經驗」通過驗證升級為「固定知識」前,即使其價值再高,也不允許 AI 調用。這確保了 AI 輸出的每一句話都具備組織認可的法效性與正確性。
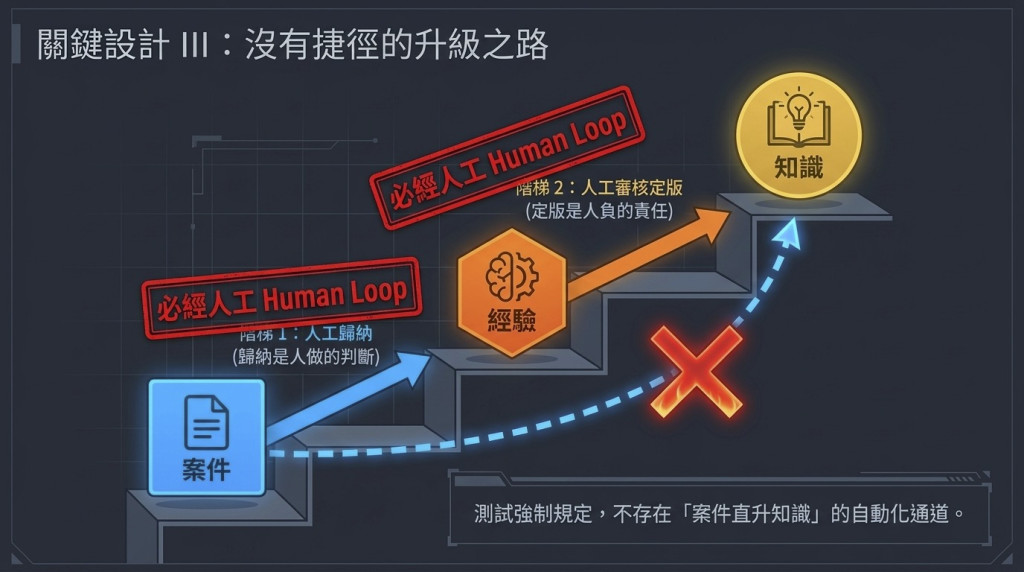
5. 第三個關鍵 takeaway:嚴格的升級路徑——人工智慧需要「人工」把關
資料要轉化為資產,必須經過嚴謹的升級路徑,這不僅是流程,更是「法律責任」的界定:
-
唯一升級路徑:個別案件 → 歷史經驗 → 固定知識
-
核心禁令:不存在「案件直升知識」的通道
身為資深顧問,我必須強調:「歸納是人做的判斷,定版是人負的責任。」 機器可以協助運算,但從個案事實提煉成經驗,再到定案為組織知識,每一步都必須經過人工審核。這種「人機協作」的本質在於責任歸屬(Accountability)——只有人能為組織的真理負責。
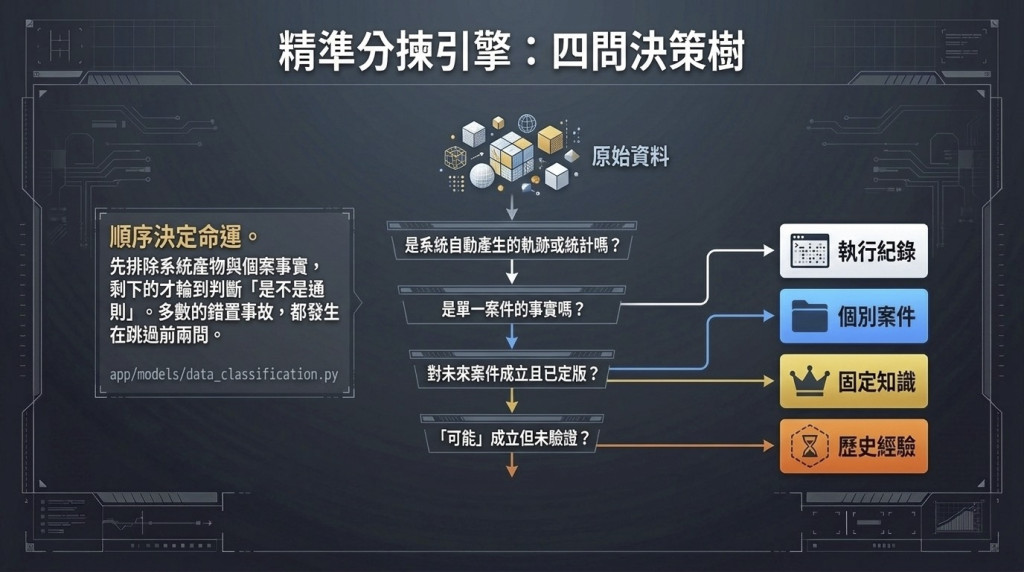
6. 實踐工具:判準決策樹的四個核心問題
在面對紛雜的資料時,請引導團隊依照以下決策樹進行檢核。請注意,問題順序具有重大的治理意義:我們必須先排除客觀事實,最後才討論主觀通則。
-
是系統自動產生的軌跡或統計嗎? (若是 → 執行紀錄)
-
是具備特定 ID 的單一案件事實嗎? (若是 → 個別案件)
-
對未來案件成立,且已驗證、已定版嗎? (若是 → 固定知識)
-
是目前「可能」成立但尚未驗證的假設嗎? (若是 → 歷史經驗)
優先執行前兩個問題的篩選,能有效排除 80% 以上的「資料錯置事故」,防止過時統計或個案紀錄污染 AI 的推理邏輯。
7. 結語:讓組織經驗真正變為資產
建立資料分類模型,是企業從「資料堆填區」轉向「知識工程」的關鍵轉折。透過四分法治理與嚴格的引用白名單,我們不僅保護了 AI 免於以訛傳訛,更為那些最寶貴、卻常被遺忘的「歷史經驗」找到了合法歸宿。
請反思你的組織:那些藏在員工腦中、散落在會議紀錄裡的珍貴教訓,現在是有家可歸,還是正如同斷線的風箏,隨時可能消失在資料的洪流之中?


 iThome鐵人賽
 看影片追技術