
前 10 天講原理和 xxx Engineering 發展. 你介入的單位從一句話擴到一整條會自跑的流程. 但單位越外面, 錯誤被放大得越大:
你越讓 AI 自主, 你自己的驗證判斷就越是 bottleneck.
問題的本質跟數學一樣: 數學對付「證明看起來對, 但可能有漏」, AI 對付「答案看起來對, 但可能是幻覺」. 兩者都是打表面說服力. 數學磨了幾百年的驗證方法論可以直接借來當日常姿勢.
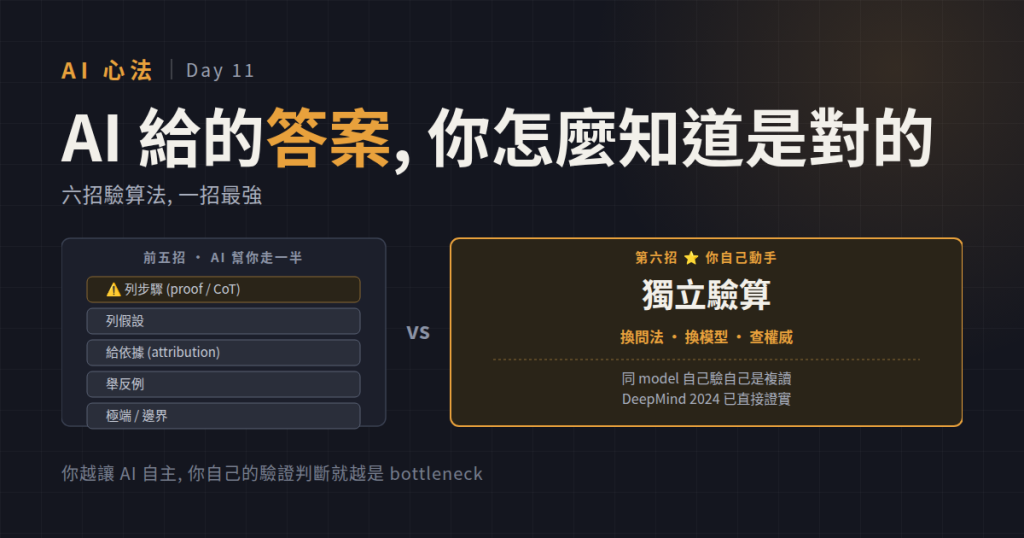
每一列是一個手段. 左欄是寫 prompt 時要求它做的事, 右欄是答案回來後你自己該做的事.
| 手段 | 寫 prompt 時要求它 | 收到答案時自己做 | 學術對應 |
|---|---|---|---|
| 列步驟 (proof) ⚠️ | 「先列推理步驟再給結論, 不要跳」 | 檢查每一步之間有沒有跳、有沒有偷渡假設 | Chain-of-Thought (Wei 2022), 對推理模型已負收益 |
| 列假設 | 「列出這結論依賴的假設」 | 看那些假設在你的實際情境是否成立 | — |
| 給依據 (citation) | 「每個斷言附可查證來源: 數字 / 引用 / 時間」 | 隨機抽一項回頭查, 特別是數字和人名 | attribution / RARR (Gao 2022); 長文變體 FActScore (Min 2023) |
| 舉反例 (counterexample) | 「舉一個能推翻這結論的情境」 | 自己想一個「如果 X 不是這樣」的反例 | counterexample probing |
| 極端 / 邊界 (edge case) | 「代入 0、極大值、負數、空集合會怎樣?」 | 用極端輸入代進去看它會不會崩 | adversarial / edge-case testing |
| 獨立驗算 ⭐ | ⚠️ 寫進 prompt 沒用 | 換問法、換模型、查權威來源, 對得起來才信 | cross-family judge / generative reasoning judges (2025 SOTA) |
前五招都是寫進 prompt 就能讓 AI 幫你自己攤開一半. 第六招不一樣, 得靠你自己動手.
「列步驟」有一個大注意: Day 06 講過, 「Let's think step by step」對現代推理模型 (Claude 4.x、o1、GPT-5) 已經是負收益 — Wharton 2025 報告測下來, 加了反而拖慢或拖錯, 因為模型內部本來就在做這件事, 你再要求一次是干擾. 但這裡的用途不同: 不是「逼 AI 答對」, 而是把它的推理攤開讓你檢查有沒有跳步. 這個 verification 用途仍然成立, 只是別再期待「加一句 step by step 就變聰明」.
數學裡「加法用減法驗」就是它. 同一個模型、同一個 session 再問一次, 它會傾向重複剛才的說法 (context 已經被前一輪的答案汙染). 這不是驗證, 是複讀.
這不是玄學, 學術界已證實. DeepMind 2024 (Huang et al., ICLR 2024) 直接把論文名叫「LLMs Cannot Self-Correct Reasoning Yet」, 實驗證明: 沒外部訊號的自我修正普遍讓推理答案變差. 因為產出錯的 prior 也會產出「驗證」, 打回原點. 唯一破口: 訊號從外部進來.
真正的獨立驗算有三條路:
對重要答案, 這招比其他五招加起來更能抓錯. 呼應 Day 09 的 loop: 那裡「測試 = code 的獨立驗算」, 因為測試是跟 code 相反方向寫的東西, 兩邊對得起來才算過.
⚠️ 一個常見的假動作: 問 AI「你這個答案有幾成把握?」以為得到 confidence 分數. Xiong et al. (ICLR 2024) 實測 verbalized confidence 系統性高於實際準確率, 而且 RLHF 訓練後更嚴重. 這等於問醉漢自己會不會開車, 別把它當獨立驗算的替代品.
不是每題都要驗, 否則變儀式, 沒法融入日常. 三條快速判準:
大原則: 越接近「一旦錯了就麻煩」, 越該把六招搬出來, 尤其獨立驗算. 反過來, 越是探索型工作, 驗越少、發散越多.


 iThome鐵人賽
 看影片追技術