
# 把 AI 產出轉換成好驗證的形狀
* 為什麼心智清單好驗證
  * 文字是線性的, 要讀完才知漏什麼
  * 清單是結構化的, 一眼看到缺口與硬撐
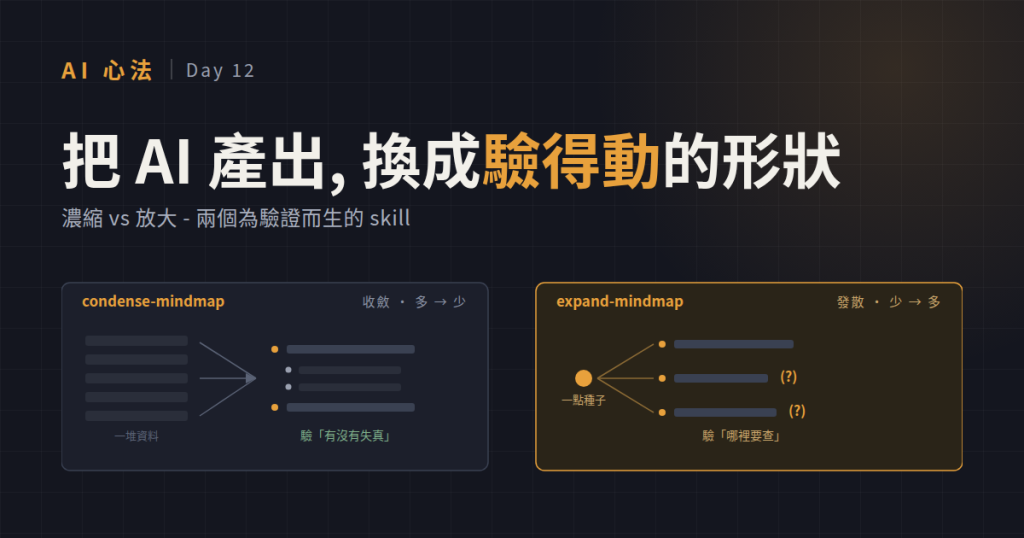
* condense-mindmap(收斂)
  * 每節點可追回原文 → 抽查就好
* expand-mindmap(發散)
  * (?) 標記 = 驗證待辦清單
  * 不重疊角度 = 驗涵蓋夠不夠
* 共通點
  * 同一套輸出格式, 相反的忠實度心法
  * 讓答案一出來就好查
一大段文字很難驗. 它是線性的, 你得從頭讀到尾才知道它漏了什麼、哪裡誇大. 而心智清單是結構化的: 幾個主要分支一眼看完, 缺了哪一塊、哪一塊硬撐, 掃過去就發現.
這正好打 Day 11 那個瓶頸. Day 11 說「人的驗證判斷是 bottleneck」, 而瓶頸的一大來源是產出的形狀不好驗. 換個形狀, 驗證成本就掉下來.
(jason3e7)我做這兩個 skill 的動機很實際: 我常常拿到 AI 一大坨輸出, 知道「應該要驗」但懶得逐字讀, 結果就沒驗. 把它先變成一張清單, 我才驗得下去.
兩個 skill 分別對應能力全景圖的兩端 - 一個收斂、一個發散, 但都是為了同一件事: 讓你驗得動.
輸入一堆資料 (筆記、逐字稿、多份文件), 輸出一張濃縮的心智清單. 這是收斂, 忠實度優先.
它幫驗證的關鍵, 藏在一條硬規則裡:
每個節點都必須能追回原始資料的哪一段, 加不出處的就是幻覺.
所以這張清單天生可驗: 你拿清單上任一節點, 回原文找對應那段. 對得上 → 沒失真; 對不上 → 抓到它加料. 你不用重讀全文, 只要抽查幾個節點.
而且缺漏也看得出來: 清單上少了一整個你知道原文有講的主題, 那就是它漏了.
自己試: 拿一份長會議記錄丟給它, 收到心智清單後, 挑最重要的三個節點回原文對. 你會在 30 秒內知道這份濃縮能不能信 - 比重讀十頁快得多.
輸入一點種子 (一個主題、一個問題), 研究之後放大成一張清單. 這是發散, 可以生, 但有一條為驗證而設的規則:
推測的節點一律標 (?), 沒標的就代表它保證查證過.
這個標記本身就是一張驗證待辦清單. 清單上標了 (?) 的, 就是它自己承認「這條我沒把握」- 你的驗證力氣直接往那些節點集中, 不用每條都查.
反過來, 沒標 (?) 的節點是它給的承諾. 你抽查一個沒標的, 如果發現其實沒有依據, 那就知道這次它的標記不可信, 整張清單要重驗.
另外, 它被要求主要分支不能重疊 - 這條是刻意的: LLM 自己發想會收斂到同一核心 (一項研究中 94% 的點子共享同一概念), 不強制岔開就整片面向漏掉. 岔開之後你也能一眼驗「涵蓋夠不夠」: 四個角度攤開, 明顯少了某個面向, 你當場看得出來.
它們是一組對照, 共用同一套輸出格式, 但驗證的東西相反:
| condense-mindmap | expand-mindmap | |
|---|---|---|
| 方向 | 收斂 (多 → 少) | 發散 (少 → 多) |
| 你驗的是 | 有沒有失真 (節點對得回原文嗎) | 哪裡要查 ((?) 節點) + 涵蓋夠不夠 |
| 忠實度心法 | 追不回原文就丟 | 可以生, 但要標虛實 |
| 輸出 | 一個根、深度 ≤ 4、每層 ≤ 7、節點是短語 | 同左 |
輸出格式刻意一致, 所以你看兩張清單的姿勢一樣, 驗法卻各有重點. 這跟 Day 11 的精神一致: 驗證不是儀式, 是把力氣花在會出錯的地方 - condense 把力氣導向「對不對得回來源」, expand 把力氣導向「它自己標不確定的地方」.
兩個 skill 都是純 markdown 巢狀清單輸出, 不綁工具: GitHub 顯示成縮排清單, 貼到 markmap 就畫成圖.
今天的心法一句話:
與其在讀不完的輸出裡找錯, 不如先把輸出換成驗得動的形狀.
驗證的前六招 (Day 11) 是「拿到答案後怎麼查」; 這兩個 skill 是更前面一步 - 讓答案一出來就好查.
兩個 skill 的完整內容都在下面 (全英文, SKILL.md 格式, 可直接放進 ~/.claude/skills/ 或貼給任何吃 SKILL.md 的平台), 拿去用:


 iThome鐵人賽
 看影片追技術