
第 18 篇我手寫過一個 44 行的代理迴圈,它送出去的,就是「我的訊息」加「我自己定義的工具」,乾乾淨淨。可是我用 Claude Code 問一句 20 字的話,用 token-inspectour 把送出去的請求攔下來一看,是 82,574 個詞元。我真正打的那句,只有 749 個。其餘九成九,是誰放進去的?
先講結論:第 21 篇和第 22 篇做的是 loop/agent engineering,講迴圈本身跟怎麼讓它停得對。這一篇是 harness engineering,講那個夾在你和模型中間、把一句話組成八萬詞元請求的「執行框架」。它補的不是模型能力,而是讓一個裸迴圈,真的能拿出去用的那一整層。
這一層有個名字,叫 harness engineering(早一點的說法是 agent harness、agent scaffolding)。它 2026 年初才在業界流行起來,背後是一句好記的等式:代理 = 模型 + harness,模型負責想,harness 負責讓它真的把事做成。這個詞不是哪一篇論文發明的,但 Zhu 等人的 SemaClaw(arXiv, 2026)把它定義得很清楚,我借他們的說法:不是只調提示詞或脈絡,而是設計一整套運作基礎設施,把裸的代理能力變成可控、可稽核、能上線的系統。 論文把這套基礎設施分成四塊:工作流程的 DAG 編排、權限安全層、分層的脈絡管理、自動維護的知識庫。這四塊聽起來抽象,但你每天用的 Claude Code 就是一個,把它攔下來看最清楚。
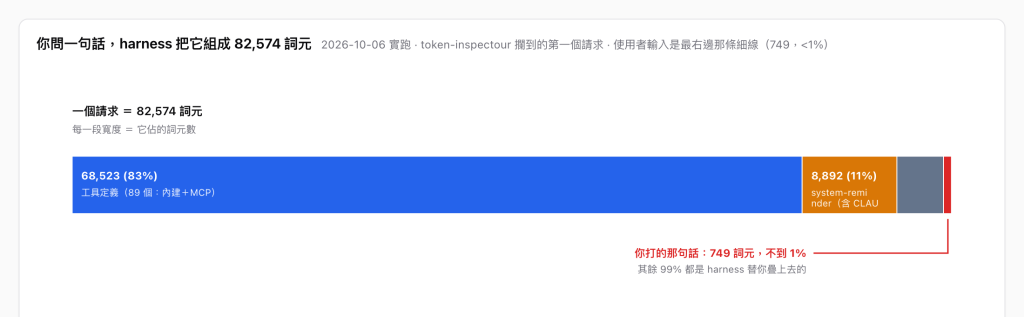
一個極小的專案:一個 calc.py,一個兩條規則的 CLAUDE.md(「回答用繁中」「動檔案前先問」)。我用 token-inspectour(一個本地代理,攔下 Claude Code 送往 API 的原始請求)問一句:「calc.py 裡有哪個函式?」第一個請求的 82,574 個詞元,來源是這樣分的(2026-10-06,Claude Code,claude-opus-5-5):
| 來源 | 詞元 | 佔比 |
|---|---|---|
| 工具定義(89 個:內建+連上的 MCP 伺服器) | 68,523 | 83% |
system-reminder(含 CLAUDE.md、提醒) |
8,892 | 11% |
| harness 系統提示+框架 overhead | 4,374 | 5% |
| 我真正打的那句話 | 749 | <1% |
(只跑一次,是例子不是證據。)那句話不到百分之一,其餘全是 harness 疊上去的。要說明的是,82,574 這個數字跟「你接了幾個 MCP 伺服器」強相關,我這台接得多、工具清單特別肥,換一台乾淨的會小很多。重點不是精確數字,是比例:你輸入的 < 1%,框架疊的 > 99%。
把這個請求跟第 18 篇那個 44 行裸迴圈對照,差距就是 harness 幫你做的事。裸迴圈每一輪送的是 {你的訊息, 你的 tools}。Claude Code 的 harness 另外補上:
CLAUDE.md、一段 system-reminder,都是它每輪替你拼進去的。第 16 篇那個工具搜尋與延遲載入,就是在管這一塊別爆掉。deny 規則、工作目錄邊界、-p 跳不跳核准,都在這層。CLAUDE.md 重新放回來。end_turn 之外的那些硬煞車、錯誤接回去重試,是它在跑那個 for 迴圈。對照 SemaClaw 的四層:脈絡組裝=分層脈絡管理,權限沙箱=權限安全層,子代理與停止=編排。你沒寫這些,但每一句話它都替你做了一遍。所以 harness 不只屬於這一層,它是後面每一層的地基:單一代理的成本(下一篇)、多個代理的分工(再下一層),都是在這層執行框架上長出來的。
第 21 篇說過一句話:你能調的不是模型,是外面那圈 while。這一篇補上後半句。那圈 while,連同它每一輪組什麼進去、什麼時候停、狀態存在哪裡,全都在 harness 手裡。 第 21 篇講「狀態不在模型身上,在迴圈那串 messages」,而那串 messages 怎麼累加、怎麼壓縮、怎麼重送,正是 harness 在管。所以 loop engineering 不是一個抽象概念,它有個很具體的落腳處,就是這層執行框架。
要看一個 harness 長什麼樣,最乾淨的例子是拿來量代理的那種。terminal-bench(Merrill, Shaw, Carlini et al., 2026)有 89 道命令列任務,每一道是一個指令、一個 Docker 環境、一份驗證用的測試腳本、一份人工解答。它底下的 Harbor 框架就是一個 harness:把任意一個代理(Claude Code、OpenHands、Codex)丟進沙箱、讓它自己跑迴圈、最後用測試檢查容器的最終狀態。前沿的代理在上面也只到 65% 以下。
這其實是整條 loop → agent → harness 的複習:要量一個代理能不能做事,你得把迴圈(第 21 篇)、停止(第 22 篇)、工具(第 16 篇)、harness(這一篇)全組起來,再加一個 verifier。 代理評測跟第九篇那種模型評測差在哪、verifier 怎麼設、為什麼要 pass@k,留到收尾那一篇講。這裡先記住一件事:測試腳本就是那個 harness 的最後一塊。
而 harness 自己也能被調。LangChain 的 Sydney Runkle 在〈The art of loop engineering〉裡把代理的迴圈疊成四層,而這四層,剛好可以用「離 harness 多遠」來排:
while。harness 每一輪替它組脈絡、跑工具、判斷停不停,前面那個八萬詞元的請求,就是這一圈的一次。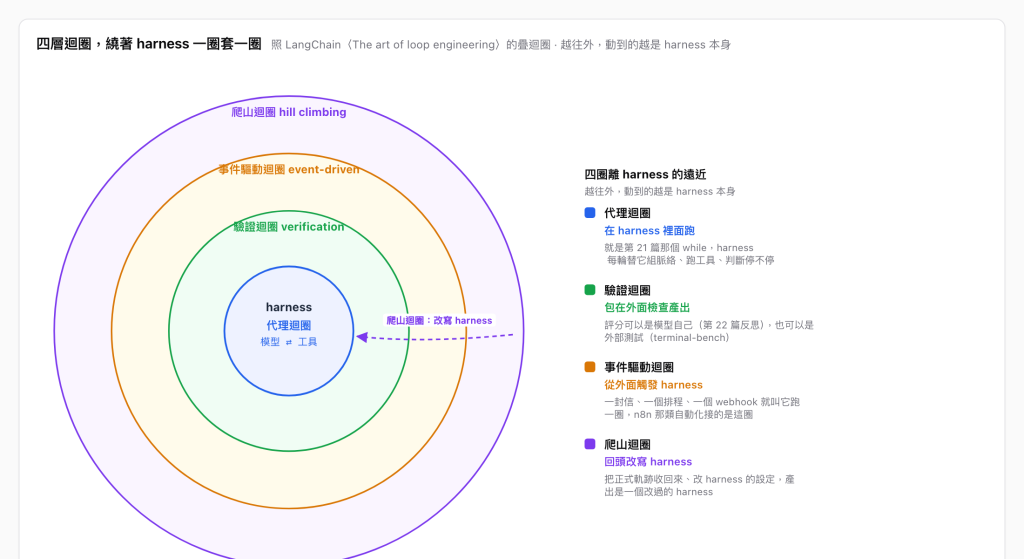
所以這四圈不是並排,是一圈套一圈,而且越往外,動到的越是 harness 本身:代理迴圈在 harness 裡跑,爬山迴圈直接改寫 harness。第 18 篇之後我們一直在做的,就是不改模型,改它外面一圈又一圈。
第一,它看不見。 你以為送出去的是一句話,其實是八萬詞元,絕大部分你沒寫、也不會看到。這很方便,但你也很難知道模型到底讀到了什麼。token-inspectour 這種工具存在,就是因為這層預設是黑的。
第二,它貴,而且被工具清單綁架。 光工具定義就佔了八成,而且第 21 篇說過,每一輪都把整包重送一次。你多接一個 MCP 伺服器,之後每一句話都跟著變貴。
第三,你讓渡了控制。 停止、權限、記憶、壓縮全在這層,平常幫你擋掉很多麻煩,但真的出事時,這層也最難插手,因為它不是你寫的。
多了什麼能力:你知道「執行框架」不是一句空話,它是一套把裸迴圈變可控、可稽核、能上線的基礎設施,看得懂一個請求裡 harness 替你疊了哪些層,也知道 loop engineering 真正的落腳處就是這裡。
多付了什麼代價:一個預設看不見的八萬詞元請求、一條被工具清單撐大的成本線,以及一層方便但難插手的控制權。
harness 把這麼多東西疊上去,方便,但代價呢?這一整疊(迴圈、代理、框架)加起來,到底多貴、多容易失控、中間過程又有多難看清?
下一篇把單一代理這一層的帳算完。


這份按來源拆開的詞元表,比只看總量更容易找到可調的地方。我會再用同一個任務比較「全部 MCP 開啟」和「只留必要工具」,一起記錄輸入詞元、快取命中、工具選錯次數與任務成功率。這樣才看得出瘦身是單純省了脈絡,還是也改善了工具選擇;也能避免把請求總詞元直接當成每輪的實際帳單。


 iThome鐵人賽
 看影片追技術