
昨天做完自動記憶提取器之後,我興沖沖地打開 app 測試。先跟莉莉說「我叫小明」,她記下來了。接著我聊了幾句別的,然後問她:
我:「你還記得我叫什麼嗎?」
莉莉:「哈?!你、你自己的名字都不記得了嗎……」(然後就沒有然後了)
記憶明明躺在向量資料庫裡,她卻叫不出來。
問題出在 RAG 檢索的本質是「語意相關性」。我問「你還記得我叫什麼嗎」,這句話跟「使用者叫小明」的語意距離其實不近,撈不到非常正常。更糟的是,如果我聊的是香菜,那 RAG 撈到的當然是香菜相關的記憶,但不管聊什麼,她都應該記得我叫什麼名字。
這就是今天要補齊的兩塊拼圖:
還有一個順手要解的老問題:Lore 檢索沒有距離門檻,永遠會撈回「最接近的那一筆」,就算它一點也不接近。
先把觀念釐清,這是今天最核心的一句話:
RAG 檢索是「這句話讓我想起什麼」,用戶輪廓是「我認識的這個人是誰」。
兩者是互補關係,而非互相取代:
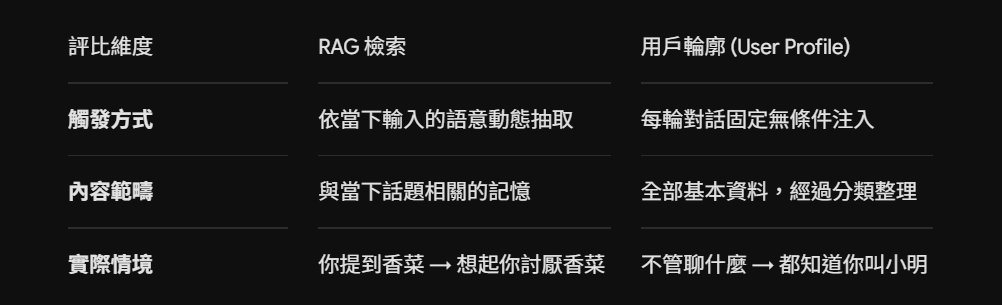
實作上,用戶輪廓不做向量檢索,而是直接把該使用者的所有記憶抓出來,按 category 分組整理:
# memory_extractor.py

# 輪廓的排版順序與標題。用固定順序而不是 dict 迭代,
# 側寫的結構才會每次都一樣,模型讀起來也穩定
PROFILE_SECTIONS = [
    ("name", "稱呼"),
    ("other", "身分"),
    ("preference", "喜好"),
    ("hobby", "興趣"),
    ("habit", "習慣"),
    ("schedule", "近期行程"),
]

def build_user_profile(user_id: str = "default_user") -> str:
    """把散落的記憶整理成一段可讀的側寫,供每輪注入 system_instruction。"""
    got = rag_memory.user_memory_collection.get(
        where={"user_id": user_id}, include=["documents", "metadatas"]
    )
    if not got["ids"]:
        return ""

    grouped = {}
    for doc, meta in zip(got["documents"], got["metadatas"]):
        grouped.setdefault((meta or {}).get("category", "other"), []).append(doc)

    lines = []
    for key, label in PROFILE_SECTIONS:
        if key in grouped:
            lines.append(f"{label}:{'、'.join(grouped[key])}")

    # 沒有任何記憶時回空字串,不要注入一個只有標題的空殼,
    # 那會讓模型以為「有這個區塊但內容被省略了」,反而開始猜測
    return "【關於這位使用者】\n" + "\n".join(lines) if lines else ""
固定順序的 PROFILE_SECTIONS(非動態迭代)
輪廓結構每次保持一致,模型讀取時才穩定。如果順序每輪都在變,等於每輪都給模型一個「結構不同」的 Prompt,會導致角色回覆的一致性下降。
無記憶時直接回傳空字串(不回傳「尚無資料」)
這是實作踩過的坑。若注入一個只有標題的空殼,模型會誤以為「有資料但內容被省略」,進而開始自主腦補使用者的身分。「不知道就什麼都不要說」比說「不知道」更安全。
註:正因為昨天的 category Enum 是鎖死的 6 種,這裡才能寫成一張固定的對照表。如果當初讓模型自由分類,這裡就必須處理一堆 Fallback。
陪伴感的核心差異在於「誰先開口」。你問她才回答,那是客服機器人;她記得三天前你說要考試、今天主動問你考得怎樣,那才叫陪伴。
schedule 這個分類就是為此存在的。邏輯非常直觀:存在超過指定天數的行程記憶,代表事件可能已經發生,值得主動追問一次。
# rag_builder.py

# schedule 類記憶存在超過幾天,就值得主動追問一次。
# 用「記憶存在多久」而不是「事件日期」,是因為提取時只存了說話時間,
# 沒有解析出「下週二」到底是哪一天,日期解析留給之後再說
PROACTIVE_DAYS = 3

def build_proactive_hint(user_id: str = "default_user") -> str:
    """挑一筆該關心的 schedule 記憶,產生主動追問的提示。

    只挑最舊的一筆而不是全部:一次列五件待追問的事,
    角色會像在唸待辦清單而不是在關心人。
    """
    got = rag_memory.user_memory_collection.get(
        where={"user_id": user_id}, include=["documents", "metadatas"]
    )
    if not got["ids"]:
        return ""

    candidates = []
    for doc, meta in zip(got["documents"], got["metadatas"]):
        meta = meta or {}
        if meta.get("category") != "schedule":
            continue
        ago = _calculate_time_ago(meta.get("created_at", ""))
        # 只認「X 天前」;「幾小時前」代表才剛講,這時追問只顯得沒在聽
        if "天前" in ago:
            days = int(ago.split(" ")[0])
            if days >= PROACTIVE_DAYS:
                candidates.append((days, doc))

    if not candidates:
        return ""

    days, text = max(candidates)  # 挑選最久沒有下文的那一筆
    return (
        f"【主動關心提示】使用者在 {days} 天前提過「{text}」,"
        f"那個時間點可能已經過了。可以在對話中自然地關心一下結果,"
        f"但不要每一輪都問,也不要生硬地照唸這句提示。"
    )
【主動關心提示】 這幾個字直接唸出來。這是 Day 22 留下的尾巴。當時的 query_character_lore() 沒有設定距離門檻,永遠會回傳「最接近的那一筆」,即便該筆資料一點也不相關。
實際症狀:當我說「我今天好累」,系統硬是撈出「非常擅長製作甜點」的設定,莉莉便無頭無腦地開始推薦薄餅。
# rag_memory.py

# Lore 檢索的距離上限。
# 沒有門檻的話 query 永遠會回傳最接近的那筆,你說「我今天好累」,
# 莉莉就會被塞進「非常擅長製作甜點」的設定,然後沒頭沒腦地開始推薦薄餅。
LORE_DISTANCE_MAX = 0.72

def query_character_lore(
    query_text, char_id, n_results=1, max_distance=LORE_DISTANCE_MAX):
    ...
    return [hit for hit in hits if hit["distance"] <= max_distance]
0.72 是在當時 7 筆語料上測出的門檻(命中都在 0.72 以下,不相關的都在 0.72 以上)。(註:隨著後續 Day 26 語料擴充至 24 筆,向量分佈改變後重新校正至 0.68)。
這兩個門檻呈現出截然不同的設計哲學:
門檻對比:
- 記憶去重誤判 (
DUPLICATE_DISTANCE = 0.25):保守設定。若誤判會導致事實永久遺失,必須壓低。- Lore 檢索誤判 (
LORE_DISTANCE_MAX = 0.72):積極設定。若誤判僅是這輪少一句設定,下輪還有機會補救。
同一個系統裡兩個門檻的哲學不同,因為錯誤的代價不對稱。
build_rag_context()現在一輪對話要注入的資訊包含四大區塊,排列順序也有嚴謹邏輯:
def build_rag_context(
    user_input: str, char_id: str, user_id: str = "default_user") -> str:
    # lore 依角色過濾;user_memory 不分角色,
    # 「使用者討厭香菜」是關於使用者的事實,兩個角色都該知道
    lores = rag_memory.query_character_lore(user_input, char_id)
    memories = rag_memory.query_user_memory_with_time(
        user_input, user_id, n_results=2
    )

    context_parts = []

    # 1. 用戶輪廓:每輪都注入的基本資料,不依賴當下話題
    profile = memory_extractor.build_user_profile(user_id)
    if profile:
        context_parts.append(profile)

    # 2. 主動關心:是否有「上次提過但還沒下文」的行程
    hint = build_proactive_hint(user_id)
    if hint:
        context_parts.append(hint.strip())

    # 3. 角色設定 (Lore)
    if lores:
        lore_text = "\n".join(f"- {l['text']}" for l in lores)
        context_parts.append(f"【檢索到的角色設定 (Lore)】:\n{lore_text}")

    # 4. 檢索到的相關記憶(帶時間註記)
    if memories:
        memory_lines = [
            f"- [{_calculate_time_ago(m['created_at'])}] {m['text']}"
            for m in memories
        ]
        context_parts.append(
            f"【關於使用者的歷史記憶(包含時間註記)】:\n"
            + "\n".join(memory_lines)
        )

    if not context_parts:
        return ""

    # 錨定「現在時間」:
    # 模型僅有訓練資料的年代背景。記憶中的「3 天前」是相對時間,
    # 若使用者提到「下週二」,沒有當前的時間錨點就無法推算事件是否過期。
    now_local = datetime.now().astimezone()
    weekday_zh = "一二三四五六日"[now_local.weekday()]
    now_text = f"{now_local.strftime('%Y-%m-%d %H:%M')}(星期{weekday_zh})"

    return (
        f"--- [RAG 檢索輔助記憶] ---\n"
        f"【現在時間】{now_text}\n\n"
        + "\n\n".join(context_parts)
        + "\n"
        f"(注意事項:請根據記憶發生的時間差距與邏輯來回應。"
        f"若記憶為數天前的預定事項,請自行推算是否已發生或完成,維持對話自然度。)"
    )
遵循「不注入空殼」原則,每個區塊均通過 if 有資料才加入 判斷。若四個區塊皆無資料,則回傳空字串,絕不傳送只有標題的空白模板給模型。
test_day24.py)測試撰寫技巧:模擬「5 天前說過的話」時,不透過 add_user_memory()(其預設帶入當下時間),而是直接寫入 Collection:
def seed(memory_id: str, text: str, category: str, days_ago: int):
    """直接寫入指定時間的記憶,用來造出「幾天前說過」的情境"""
    ts = (datetime.now(timezone.utc) - timedelta(days=days_ago)).isoformat()
    rag_memory.user_memory_collection.upsert(
        documents=[text],
        ids=[memory_id],
        metadatas=[{"user_id": USER, "category": category, "created_at": ts}],
    )
測試案例採正反成對設計,確保觸發條件的精確性:
============================================================
Day 24:用戶輪廓與主動關心
============================================================

【1】對話 → 記憶自動增加
  提取前:0 筆
  + [name      ] 使用者的名字是小明。
  + [other     ] 使用者是資工系的學生。
  + [schedule  ] 使用者正在準備下週二的期末考。
  提取後:3 筆

【2】記憶達上限時的處理
  上限設為 3 筆時:
    寫入 = []

【3】有記憶 → 輪廓依 category 分類
  【關於這位使用者】
  稱呼:使用者的名字是小明。
  身分:使用者是資工系的學生。
  近期行程:使用者正在準備下週二的期末考。

【4】無記憶 → 回空字串(不注入只有標題的空殼)
  回傳 '' → 是空字串:True

【5】schedule 已 5 天 → 觸發主動關心
  【主動關心提示】使用者在 8 天前提過「使用者這週末要搬家」,那個時間點可能已經過了。
  可以在對話中自然地關心一下結果,但不要每一輪都問,也不要生硬地照唸這句提示。
  ↑ 兩筆都超過門檻時應挑最舊的(8 天前的搬家)

【6】schedule 才剛講 → 不觸發
  回傳 ''

【6b】只有非 schedule 記憶 → 不觸發
  回傳 ''

【7】完整 RAG Context(輪廓 + 關心 + Lore + 檢索記憶)

--- [RAG 檢索輔助記憶] ---
【現在時間】2026-09-09 03:37(星期三)

【關於這位使用者】
稱呼:使用者的名字是小明
近期行程:使用者下週二有期末考

【主動關心提示】使用者在 6 天前提過「使用者下週二有期末考」,那個時間點可能已經過了。
可以在對話中自然地關心一下結果,但不要每一輪都問,也不要生硬地照唸這句提示。

【檢索到的角色設定 (Lore)】:
- 莉莉非常擅長製作各種甜點與手工烘焙,特別是烤薄餅,最喜歡推薦甜點給別人。

【關於使用者的歷史記憶(包含時間註記)】:
- [6 天前] 使用者下週二有期末考
- [1 天前] 使用者的名字是小明
(注意事項:請根據記憶發生的時間差距與邏輯來回應。若記憶為數天前的預定事項,
請自行推算是否已發生或完成,維持對話自然度。)
今天完成的兩個功能,底層核心都在解決同一個問題:把「等你問」變成「我一直都在」。
技術架構上最大的收穫是釐清了兩者的定位分工:
另一個深刻的體會是設計門檻時的代價思考:DUPLICATE_DISTANCE 選擇保守、LORE_DISTANCE_MAX 選擇積極,釐清系統失敗時的代價結構,設定參數時自然就有清晰的依據。


 iThome鐵人賽
 看影片追技術