
在上幾天完成「自動記憶提取器(Memory Extractor)」與「用戶輪廓(User Profile)與主動關心」之後,我們的 Agent 已經具備了強大的記憶捕捉與 Context 側寫能力。莉莉與時刻不再是無記憶的木頭,而是能精準叫出你的名字、甚至在幾天後主動問候你:「上週的資工系期末考還順利嗎?」。
然而,當系統真實運行一段時間後,隨之而來的卻是長期記憶維護(Sustainable Memory System)的災難與死角:
事實衝突與矛盾鬼故事(Contradiction):
使用者三天前說「我最討厭吃香菜」,今天卻聊到「我最近嘗試了香菜烘焙,發現其實蠻香的」。如果這兩筆事實同時保存在向量資料庫裡,RAG 檢索時會把兩條完全相反的記憶一併撈出注入 Prompt,導致角色在對話中直接陷入「精神分裂」,一邊說著「你不是討厭香菜嗎」,一邊又說「你最近不是愛上香菜了」。
記憶膨脹與檢索雜訊(Memory Bloat & Noise):
雖然我們在 Day 24 設定了容量上限擋板,但如果只是單純的「滿了就不寫入」,那麼過期的瑣碎行程(例如:「三週前要買牛奶」)將永遠占用著寶貴的記憶額度,而最新重要的事實卻被擋在門外;若是採用隨機丟棄,又極有可能誤刪使用者的「名字」或「核心身分」。
記憶不是越積越多就好,會「新陳代謝」的記憶才是活的。
今天的核心任務,就是要建構一套完整的記憶淘汰機制(Memory Pruning)。我們將挑戰整個 Agent 架構中邏輯密度最高、除錯最棘手的一關:衝突判定、過期歸檔與分級修剪。
更重要的是,我們堅持一條至關重要的工程防線:絕不真正執行物理刪除(Hard Delete)!一律採用 archived: True 標記進行軟刪除(Soft Delete)。這不僅讓記憶的演變完全可逆,也為後續手動管理留下了安全退路。
archived 欄位,避免過濾器導致舊資料消失。_live_filter(),重構所有讀取路徑。0.25 - 0.45),並利用 LLM + Schema 判定 CONTRADICT / DUPLICATE / DIFFERENT。schedule 記憶自動轉為歸檔狀態。archived 標記排除 RAG 與 Profile 檢索,保留資料可逆性。test_day25.py 驗證記憶覆蓋、淘汰與代謝流程。在 ChromaDB 中,where={"archived": False} 對於欄位不存在的文件是不會匹配的!這意味著如果不做處理,Day 23/24 存進去、根本沒有 archived 欄位的舊記憶會全部消失,不是被排除,是完全查不到。即使用 $ne 也無法救回。
順序絕對不能反:必須先回填,再實施過濾。
migrate_archived.py(一次性腳本,跑完即可,可重複執行):
# migrate_archived.py
import rag_memory

got = rag_memory.user_memory_collection.get(include=["metadatas"])
patched = []

for mid, meta in zip(got["ids"], got["metadatas"]):
    meta = meta or {}
    if "archived" not in meta:
        patched.append((mid, {**meta, "archived": False}))

if patched:
    # 只更新 metadata,不動 documents,
    # 重寫 documents 會觸發重新計算 embedding,白花一次 API 額度
    rag_memory.user_memory_collection.update(
        ids=[i for i, _ in patched],
        metadatas=[m for _, m in patched],
    )

print(f"成功回填 {len(patched)} 筆舊記憶欄位")
這裡同時修改 rag_memory.add_user_memory(),確保未來新寫入的記憶預設皆帶有 "archived": False。
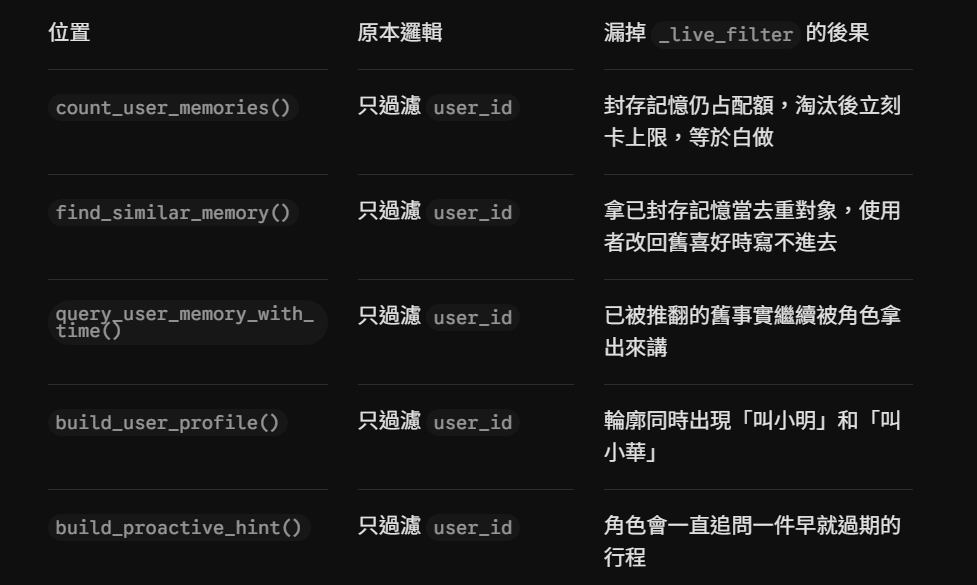
目前系統共有五處在讀取 user_memory。如果每個地方各自拼湊 where,漏掉一個就會產生隔離或邏輯漏洞。此外,ChromaDB 要同時比對多個欄位時必須使用 $and 語法。
在 rag_memory.py 中新增收攏函式:
# rag_memory.py
def _live_filter(user_id: str) -> dict:
    """未封存 + 屬於這位使用者。所有檢索路徑都該用這個,不要各自拼 where。"""
    return {"$and": [{"user_id": user_id}, {"archived": False}]}
再補一個寫入端。注意它做的是「標記」而不是 delete:
def archive_memory(memory_id: str, reason: str):
    """軟刪除:加標記排除檢索,資料本體保留(可逆)"""
    got = user_memory_collection.get(ids=[memory_id], include=["metadatas"])
    if not got["ids"]:
        return

    meta = got["metadatas"][0] or {}
    user_memory_collection.update(
        ids=[memory_id],
        metadatas=[{
            **meta,
            "archived": True,
            "archived_reason": reason,   # contradicted / expired / evicted
            "archived_at": datetime.now(timezone.utc).isoformat(),
        }],
    )
reason 一定要存。之後 Day 28 做記憶庫檢視介面時,使用者才看得懂「這筆為什麼不見了」,而不是只看到記憶莫名其妙少了一條。
Day 24 量到的向量距離分佈已經告訴我們答案了:
0.201  不吃香菜   ←→  討厭吃香菜      (重複 DUPLICATE)
0.264  討厭芹菜   ←→  討厭香菜        (不同 DIFFERENT)
0.393  我叫小明   ←→  使用者叫小明    (重複 DUPLICATE)
0.408  使用者叫小華 ←→  叫小明          (矛盾 CONTRADICT) ← 就是這個!
< 0.25 已由 DUPLICATE_DISTANCE 擋掉。0.25 – 0.45 這段是三種關係混在一起的灰色地帶,向量距離永遠分不開「芹菜 vs 香菜」(不同)和「小華 vs 小明」(矛盾),因為它們的向量距離幾乎一樣。
距離做不到的事,交給語意模型:
GRAY_ZONE_MAX = 0.45

def find_gray_zone_memories(text, user_id, n_results=3) -> list[dict]:
    """撈出距離落在 DUPLICATE_DISTANCE ~ GRAY_ZONE_MAX 的既有記憶,
    這些是「像但不夠像」的,需要進一步判斷關係"""
判斷器沿用 extractor 那套 Lite 模型 + response_schema 的寫法:
三選一 Enum 鎖死 Schema
{"relation": "DUPLICATE | CONTRADICT | DIFFERENT", "reason": "str"}
Prompt 的關鍵是講清楚矛盾 ≠ 不同:
CONTRADICT(同一屬性,數值變更)DIFFERENT(不同對象,可同時成立)DIFFERENT(保守原則,寧可多存一筆)處理動作:
CONTRADICT → archive_memory(舊, "contradicted") + 寫入新記憶DUPLICATE → SkipDIFFERENT → 正常寫入成本控制:只有真的撈到灰色地帶候選時才呼叫 LLM,而且多筆候選採批次判斷(最多 3 筆候選也只花 1 次 API 呼叫)。大多數無相近記憶的輪次不會增加額外負擔。
安全防線:若模型回傳的判斷筆數跟候選筆數對不上,就整串放棄改判
DIFFERENT。硬對齊會把 A 的判斷套到 B 身上,「封存錯一筆」比「不封存」嚴重得多。
schedule 類別記憶若建立超過 EXPIRE_DAYS = 14 天,自動調用 archive_memory(id, "expired")。此門檻大於 Day 24 的 PROACTIVE_DAYS = 3,留出緩衝餘裕,避免主動關心還沒問就被封存。MAX_USER_MEMORIES 時,依據類別優先序淘汰最舊的一筆:EVICTION_ORDER = ["schedule", "other", "habit", "hobby", "preference"]
# name 不在清單裡 = 永不淘汰!
# 忘記使用者叫什麼名字是角色崩壞,忘記他兩個月前某天要考試只是不夠貼心。
同類別內比對 created_at,最舊的先走。
test_day25.py)延續 Day 24 的寫法,測試專用 user_id、用 seed() 直接寫指定時間的記憶、跑完自動 clear()。
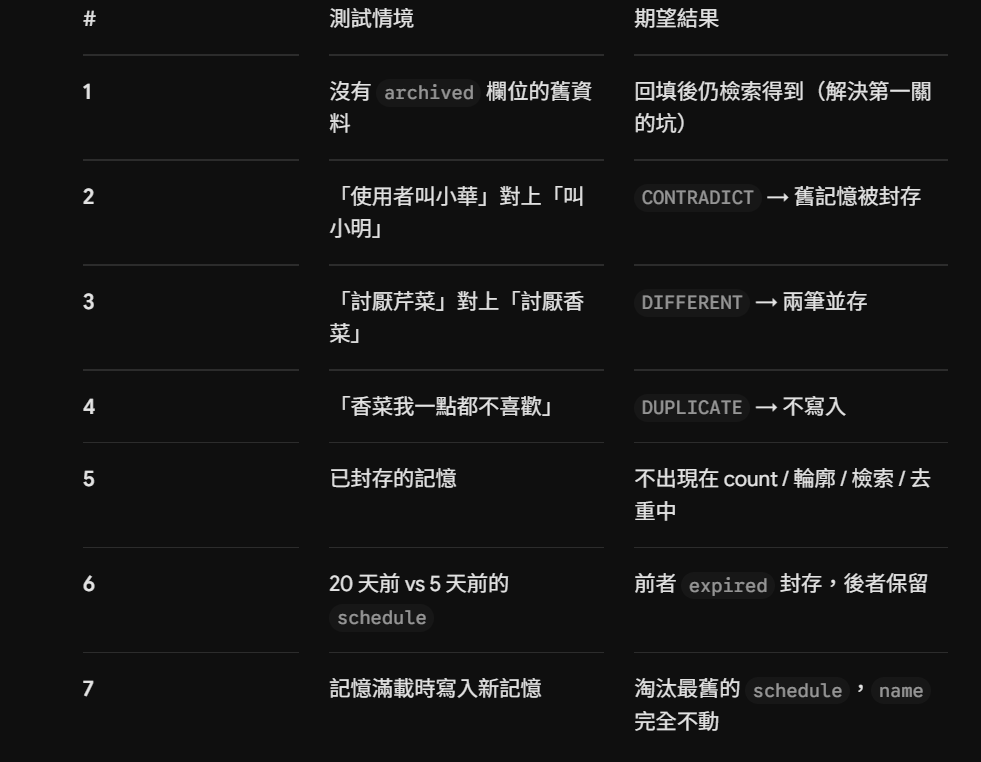
案例 2 與 3 是這天的核心,兩者的向量距離幾乎一樣(0.408 vs 0.264),結果卻必須完全相反。這一組驗證通過才算真正成功!
實際執行 test_day25.py 的精華輸出:
【2】「使用者叫小華」對上「使用者叫小明」 → 應判 CONTRADICT
  灰色地帶候選:[('使用者叫小明', 0.408)]
  封存舊記憶:「使用者叫小明」← 被「使用者現在的名字是小華。」推翻
    (名字屬於單一屬性,使用者不可能同時叫小明又叫小華,新事實更新了舊有的名字資訊。)
  目前記憶庫:
    [封存 / contradicted] 使用者叫小明
    [有效] 使用者現在的名字是小華。

【3】「討厭吃芹菜」對上「討厭吃香菜」 → 應判 DIFFERENT(可並存)
  灰色地帶候選:[('使用者討厭吃香菜', 0.264)]
  replaced = [] ← 應為空
  目前記憶庫:
    [有效] 使用者討厭吃香菜
    [有效] 使用者討厭吃芹菜。
關鍵對比:距離 0.408 的判矛盾,距離更近的 0.264 反而判不同。這證明了向量距離工具本身無法處理「同屬性數值變更」問題,必須依靠第二層語意判斷。
灰色地帶的重複性也順利通過驗證:
【4】「香菜我一點都不喜歡」對上「討厭吃香菜」 → 應判 DUPLICATE
  stored  = []
  skipped = 「使用者不喜歡吃香菜。」等同於「使用者討厭吃香菜」(距離 0.172,關卡1 距離去重)
  原話「香菜我一點都不喜歡」的灰色地帶候選:[('使用者討厭吃香菜', 0.328)]
    vs「使用者討厭吃香菜」→ DUPLICATE(「一點都不喜歡」與「討厭」在表達對香菜的負面態度上意義相同。)
過期與淘汰機制運作符合預期:
【6】schedule 超過 14 天 → 封存;未滿的不動
  封存:['使用者下週二有期末考']
    [封存 / expired] 使用者下週二有期末考
    [有效] 使用者這週末要搬家          ← 才 5 天,主動關心都還沒問過
    [有效] 使用者討厭吃香菜          ← 喜好不會過期

【7】記憶滿載 → 依 EVICTION_ORDER 淘汰,name 不動
  淘汰:[('schedule', '使用者明天要開會')]
  寫入:['使用者喜歡看動畫。']
    [有效] 使用者的名字是小明        ← 庫裡最舊(100 天前)卻不動
    [封存 / evicted] 使用者明天要開會 ← 庫裡最新(1 天前)卻先走
被淘汰的是最新的那筆 schedule,保留的是最舊的 name。這正是我們要的:淘汰看的是「忘掉的代價」,不是「存了多久」。
改完成式碼、test_day25.py 七案全過後,回頭跑 Day 24 的測試,卻發現案例 5 與 7 的 Prompt 輸出完全空掉了!
【5】schedule 已 5 天 → 觸發主動關心
  (無提示)

【7】完整 RAG Context(輪廓 + 關心 + Lore + 檢索記憶)
--- [RAG 檢索輔助記憶] ---
【現在時間】2026-09-06 02:42(星期日)
【檢索到的角色設定 (Lore)】:
- 莉莉非常擅長製作各種甜點與手工烘焙……
輪廓不見了、檢索記憶不見了、主動關心也不見了。而 test_day25.py 卻全過。
原因正是自己在第一關警告過的事:test_day24.py 裡的 seed() 是直接 Upsert 進 Collection 的,其 Metadata 漏掉了 archived: False 欄位。
自己埋的坑,自己填起來
# test_day24.py 的 seed(),修正後
metadatas=[{
    "user_id": USER, "category": category,
    "created_at": ts, "archived": False,   # ← 少了這行,Seed 進去的記憶全被 Live Filter 排除
}],
這個教訓非常深刻:只要系統裡有第二個資料寫入入口(如測試檔、爬蟲、批量匯入腳本),就有第二次中招的機會。
如果說 Day 24 是「讓 Agent 記得住」,那麼 Day 25 就是「讓 Agent 忘得對」。前者是功能實現,後者是系統治理;而治理的難處在於,你必須在資訊有限的情況下做決定。
整套設計的核心哲學就是:把不可逆變成可逆。
向量距離分不開矛盾與不同,就補一層語意判斷;語意判斷仍有出錯機率,就不做物理刪除、僅做封存。兩層防護加起來,就算誤判也只是「暫時隱藏」,絕非「永久失憶」。
(老實說:Day 25 的邏輯密度極高,並非一天就能一蹴而就,這是我實際打磨了一個多禮拜的結晶。)


 iThome鐵人賽
 看影片追技術